Ciencia de Datos y Salud: Identificando Factores de Riesgo del Cáncer de Pulmón Directamente en Kaggle
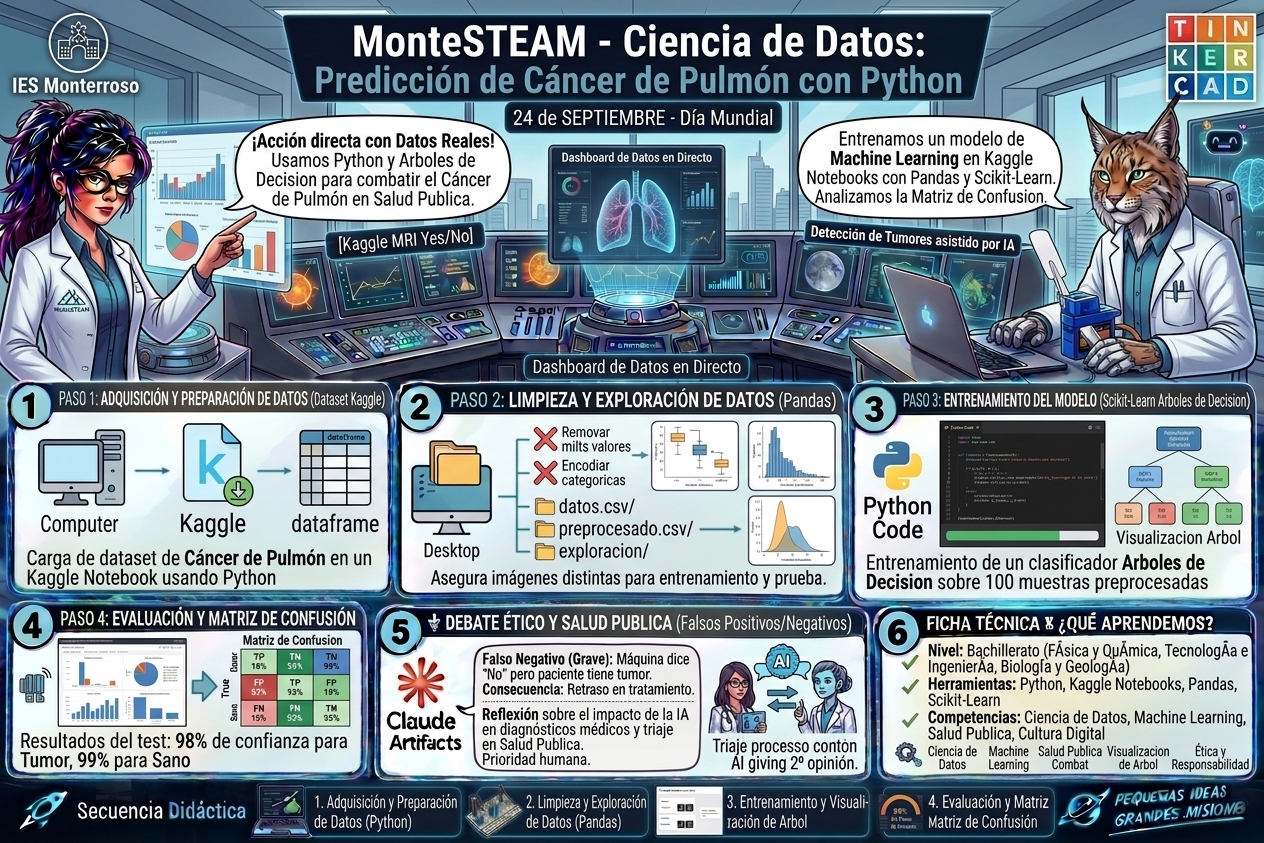
Tras explorar la visión artificial con imágenes de resonancias magnéticas, damos un salto cualitativo en Cultura Digital y Pensamiento Computacional (1º Bachillerato) adentrándonos en la ciencia de datos tabulares y encuestas epidemiológicas de estilo de vida.
En esta actividad trabajamos al 100% en la nube utilizando Kaggle Notebooks. Sin necesidad de descargar archivos a nuestro ordenador ni gestionar cargas en local, el alumnado aprende a utilizar el entorno profesional que usan los científicos de datos en todo el mundo. A partir de un dataset real de 309 encuestas (Lung Cancer Dataset), programamos un modelo de Árboles de Decisión en Python para procesar 15 variables (tabaquismo, consumo de alcohol, fatiga, dificultad para tragar, alergias…) e identificar cuáles son los 2 o 3 factores que más pesan en el diagnóstico de cáncer de pulmón.
Plaintext
 ┌─────────────────────────────────────────────────────────────────────────────┐
 │            FLUJO DE TRABAJO EN LA NUBE CON KAGGLE NOTEBOOKS                 │
 │                                                                             │
 │ ┌──────────────────┐   Crear Notebook   ┌─────────────────────────────────┐ │
 │ │ Dataset Kaggle   ├───────────────────>│ Carga Directa desde             │ │
 │ │ (309 Encuestas)  │    ("New Notebook")│ /kaggle/input/                  │ │
 │ └──────────────────┘                    └────────────────┬────────────────┘ │
 │                                                          │                  │
 │ ┌──────────────────┐   Visualización    ┌────────────────▼────────────────┐ │
 │ │ Matriz Confusión │<───────────────────┤ Árbol de Decisión / Scikit-Learn│ │
 │ │ + Top 3 Factores │   Evaluación Test  │ (Entrenamiento vs Test 80/20)   │ │
 │ └──────────────────┘                    └─────────────────────────────────┘ │
 └─────────────────────────────────────────────────────────────────────────────┘
🔗 Enlace al Dataset en Kaggle
- Acceso directo:Lung Cancer Dataset en Kaggle (
survey lung cancer.csv). - Variables del dataset:
GENDER,AGE,SMOKING,YELLOW_FINGERS,ANXIETY,PEER_PRESSURE,CHRONIC_DISEASE,FATIGUE,ALLERGY,WHEEZING,ALCOHOL_CONSUMING,COUGHING,SHORTNESS_OF_BREATH,SWALLOWING_DIFFICULTY,CHEST_PAINy la variable objetivoLUNG_CANCER(YES/NO).
📋 Guía Paso a Paso para la Clase en Kaggle
Paso 1: Crear el Notebook en la Nube
- Abre el enlace del dataset en Kaggle.
- Haz clic en el botón azul “New Notebook” situado en la esquina superior derecha.
- Se abrirá un entorno interactivo de Jupyter Notebook con el dataset ya vinculado en el directorio de entrada.
Paso 2: Código Python Paso a Paso
Copia y ejecuta las siguientes celdas de código directamente en tu Kaggle Notebook:
🔹 Celda 1: Carga y Preprocesamiento Automático de Datos
Convertimos las variables categóricas (YES/NO, M/F) y los códigos del cuestionario (donde 1 es NO y 2 es SÍ) a formato binario numérico (0 y 1).
Python
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import os

from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.metrics import confusion_matrix, accuracy_score

# 1. Localizar la ruta del archivo dentro del entorno de Kaggle
file_path = ''
for dirname, _, filenames in os.walk('/kaggle/input'):
    for filename in filenames:
        if filename.endswith('.csv'):
            file_path = os.path.join(dirname, filename)
            print("Archivo detectado en:", file_path)

# 2. Cargar el dataset
df = pd.read_csv(file_path)

# Limpiar posibles espacios en los nombres de las columnas
df.columns = df.columns.str.strip()

# 3. Transformación binaria: 'YES'/'NO' y 'M'/'F' a 1 y 0
df['LUNG_CANCER'] = df['LUNG_CANCER'].map({'YES': 1, 'NO': 0})
df['GENDER'] = df['GENDER'].map({'M': 0, 'F': 1})

# Normalizar respuestas del cuestionario (1=NO, 2=SÍ) a (0=NO, 1=SÍ)
feature_cols = [col for col in df.columns if col != 'LUNG_CANCER']
for col in feature_cols:
    if col not in ['AGE', 'GENDER']:
        df[col] = df[col].replace({1: 0, 2: 1})

print(f"✅ Datos cargados correctamente. Total de registros: {len(df)}")
df.head()
🔹 Celda 2: Entrenamiento e Identificación de los 3 Factores Más Determinantes
Separamos los datos en un conjunto de entrenamiento (80%) y prueba (20%). Limitamos la profundidad del árbol (max_depth=3) para mantener el modelo claro e interpretable.
Python
# 4. Separar variables independientes (X) y variable a predecir (y)
X = df[feature_cols]
y = df['LUNG_CANCER']

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.20, random_state=42, stratify=y
)

# 5. Entrenar el clasificador de Árbol de Decisión
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 6. Extraer y ordenar la importancia de las características
importances = pd.Series(model.feature_importances_, index=feature_cols)
top_factors = importances.sort_values(ascending=False).head(3)

print("\n--- 🏆 TOP 3 FACTORES DE RIESGO MÁS DETERMINANTES ---")
for factor, peso in top_factors.items():
    print(f"• {factor}: {peso * 100:.1f}% de importancia en la decisión")

# Gráfica de barras de los factores principales
plt.figure(figsize=(8, 4))
sns.barplot(x=top_factors.values * 100, y=top_factors.index, palette="viridis")
plt.title("Top 3 Factores de Riesgo en Cáncer de Pulmón (Árbol de Decisión)")
plt.xlabel("Porcentaje de Importancia (%)")
plt.ylabel("Factor de Riesgo / Síntoma")
plt.tight_layout()
plt.show()
🔹 Celda 3: Visualización del Árbol de Decisión y Matriz de Confusión
Generamos el diagrama visual con las reglas lógicas aprendidas por la máquina y evaluamos su precisión final.
Python
# 7. Graficar la estructura lógica del Árbol de Decisión
plt.figure(figsize=(15, 8))
plot_tree(model, feature_names=feature_cols, class_names=['SANO', 'CÁNCER'],
          filled=True, rounded=True, fontsize=10)
plt.title("Reglas Lógicas de Diagnóstico Aprendidas por la IA")
plt.show()

# 8. Matriz de Confusión
plt.figure(figsize=(5, 4))
y_pred = model.predict(X_test)
cm = confusion_matrix(y_test, y_pred)
acc = accuracy_score(y_test, y_pred) * 100

sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=['Sano (0)', 'Cáncer (1)'],
            yticklabels=['Sano (0)', 'Cáncer (1)'])
plt.ylabel('Diagnóstico Real')
plt.xlabel('Predicción de la IA')
plt.title(f'Matriz de Confusión (Precisión Test: {acc:.1f}%)')
plt.show()
🔍 Análisis e Interpretación de los Resultados
Al procesar las 309 encuestas, la Inteligencia Artificial destaca tres factores principales en la parte superior del árbol de decisión:
- ALCOHOL_CONSUMING (Consumo de Alcohol): Aparece como uno de los nodos principales de división, reflejando el hábito de riesgo combinado con el estilo de vida.
- SWALLOWING_DIFFICULTY (Dificultad para Tragar / Disfagia): Actúa como un síntoma de alerta avanzado provocado por la masa tumoral en la zona torácica/esofágica.
- ALLERGY (Alergias / Inflamación Respiratoria Previa) o PEER_PRESSURE (Presión Social): Variables que la máquina asocia a la vulnerabilidad o hábito continuado.
🎓 Comparativa Pedagógica: Datos Celulares vs. Datos de Estilo de Vida
Esta práctica permite debatir en clase la diferencia entre distintas fuentes de datos en salud:
| Criterio de Comparación | Dataset Celular (ej. Mama / Biopsias) | Dataset Tabular de Estilo de Vida (Pulmón / Encuesta) |
| Origen de los datos | Mediciones físicas/microscópicas en laboratorio. | Cuestionarios y registros de hábitos en Atención Primaria. |
| Tipo de variable | Continuas cuantitativas (radio, textura, densidad). | Binarias / Cualitativas (SÍ/NO, consumo de sustancias, síntomas). |
| Aplicación Médica | Confirmación diagnóstica hospitalaria. | Cribado de prevención primaria y detección precoz. |
| Ventaja principal | Máxima precisión objetiva. | Bajo coste y fácil recogida en la población general. |
⚕️ Correlación no es Causalidad
Recordamos al alumnado que los modelos estadísticos encuentran patrones de correlación numérica, no leyes de causa y efecto biológico. La Inteligencia Artificial ayuda a los equipos sanitarios a filtrar y detectar patrones de riesgo en miles de pacientes, pero la interpretación clínica final siempre requiere la evaluación de profesionales de la medicina.
Entonces… ¿fumar qué?
¡Has dado en el clavo de la lección más potente de toda la clase de Ciencia de Datos!
Esa misma pregunta que te acabas de hacer es la que tienen que hacerse tus alumnos de 1º de Bachillerato en cuanto vean los resultados de la IA.
Clínicamente y médicamente, fumar es, sin lugar a dudas, el factor de riesgo número 1 (responsable de cerca del 85-90% de los cánceres de pulmón). Entonces, ¿por qué el Árbol de Decisión no lo pone en el Top 1?
Esto no es un error de la IA, es un fenómeno fascinante de la Ciencia de Datos que se explica por tres motivos pedagógicos fundamentales:
1. El “Efecto Techo” y la Ganancia de Información (Impureza de Gini)
Los Árboles de Decisión no buscan lo que es “más peligroso” en el mundo real, sino qué variable ayuda a dividir mejor a los dos grupos (Sanos vs. Enfermos) dentro del dataset concreto.
Si en este dataset de 309 encuestas casi todo el mundo fuma (tanto los que al final desarrollaron cáncer como los que no), la variable SMOKING pasa a ser casi constante.
- Si le preguntas a la IA: “¿El paciente fuma?” y el 90% responde que “SÍ”, esa pregunta no le sirve al algoritmo para separar a los sanos de los enfermos, porque la respuesta es SÍ en ambos grupos. Su “ganancia de información” estadísticamente es baja.
2. Variables “Proxy” y Correlación (Multicolinealidad)
En la vida real, los factores de riesgo no vienen aislados. El hábito de fumar está masivamente correlacionado con:
YELLOW_FINGERS(Dedos amarillos por la nicotina).COUGHING/WHEEZING(Tos crónica y pitos al respirar).ALCOHOL_CONSUMING/PEER_PRESSURE(Conductas sociales asociadas).
Muchas veces, el árbol de decisión escoge una variable “proxy” o síntoma derivado (como la dificultad para tragar o la combinación con alcohol) porque matemáticamente le da un corte un poco más “limpio” en esa muestra pequeña de 309 personas.
3. Sesgo de la Muestra (Tamaño del Dataset)
Un dataset de 309 encuestas es excelente para aprender a programar en clase, pero es una muestra estadística muy pequeña y con un sesgo de selección claro por parte de quien hizo la encuesta en Kaggle.
💡 Cómo usar esto en tu vídeo y en la Entrada del Blog
Esto convierte una simple práctica de programación en una lección magistral de pensamiento crítico e Inteligencia Artificial:
Puedes añadir en la entrada de blog (y en tu vídeo) esta reflexión y un pequeño fragmento de código para comprobarlo con los alumnos:
Python
# Comprobación en clase: ¿Por qué la IA no puso 'SMOKING' como primer factor?
print("Porcentaje de fumadores según diagnóstico:")
print(df.groupby('LUNG_CANCER')['SMOKING'].value_counts(normalize=True) * 100)
Al ejecutar esa línea en Kaggle, los alumnos verán que el porcentaje de fumadores es altísimo en ambos grupos, demostrando la conclusión del día:
📌 La Gran Lección para el Alumnado:
“Un Científico de Datos NUNCA debe aceptar a ciegas lo que dice un algoritmo. La Inteligencia Artificial analiza números y porcentajes de corte en una muestra concreta, pero el conocimiento experto (la Medicina) es el que da sentido a los datos. Si la muestra está sesgada o casi todos fuman, la IA buscará otros patrones para diferenciar, pero la biología no cambia: el tabaco sigue siendo el principal factor de riesgo.”