Día Mundial de la Investigación en Cáncer: tres formas de investigar con datos e IA
Hoy hemos celebrado en MONTESTEAM el Día Mundial de la Investigación en Cáncer acercándonos a un ámbito en el que la ciencia de datos y la Inteligencia Artificial están adquiriendo cada vez más importancia: el análisis de datos biomédicos.
Lo hemos hecho de una manera muy concreta: trabajando con datasets reales y construyendo pequeños modelos capaces de encontrar patrones en los datos.
No hemos pretendido crear herramientas médicas ni sistemas capaces de diagnosticar enfermedades. El objetivo ha sido mucho más interesante desde el punto de vista educativo: experimentar con algunas de las técnicas que se utilizan en ciencia de datos y comprender también sus limitaciones.
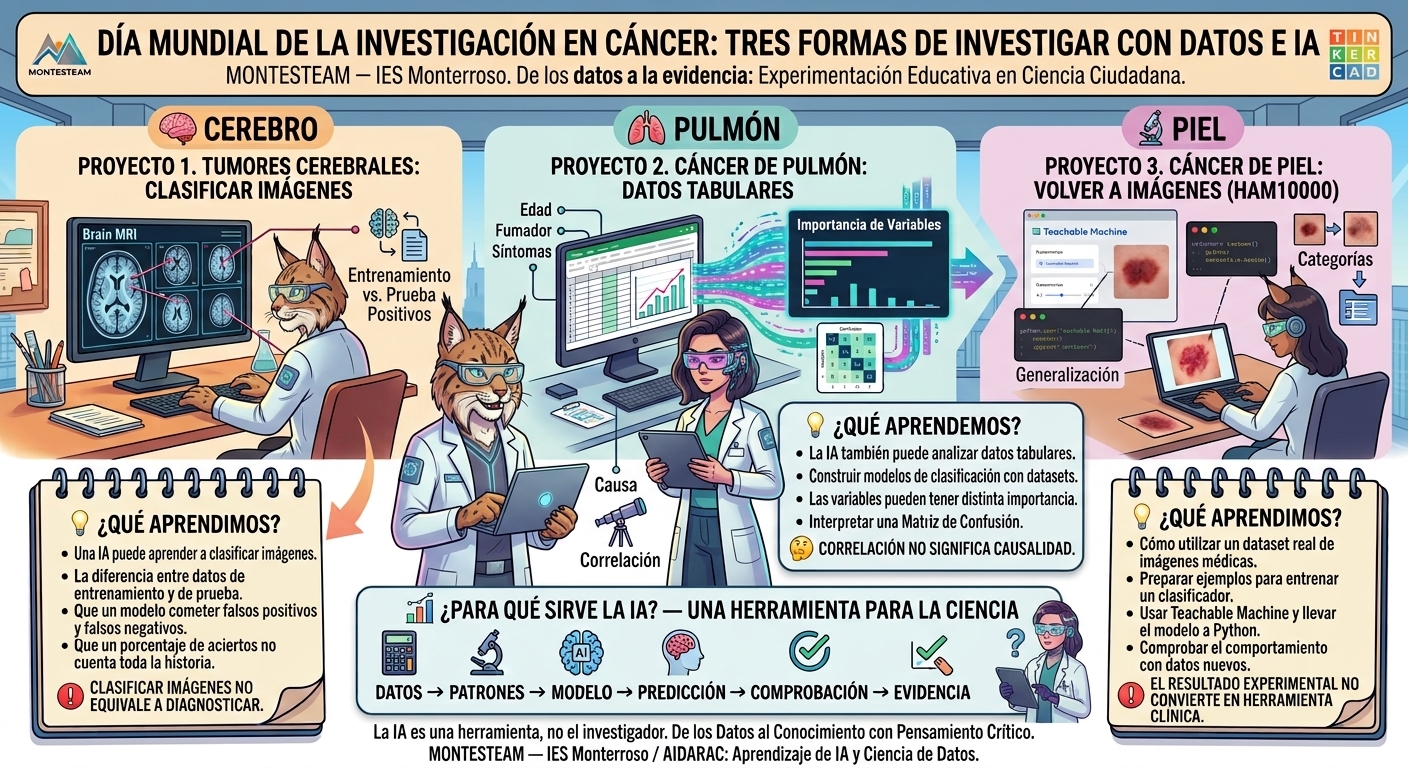
🧠 Tres problemas, tres tipos de datos
A lo largo de las actividades hemos trabajado con tres conjuntos de datos diferentes y, con ellos, hemos aprendido que no existe una única manera de utilizar la Inteligencia Artificial para investigar.
🧠 Proyecto 1. Tumores cerebrales: aprender a clasificar imágenes
Hemos utilizado imágenes de resonancia magnética para entrenar un modelo de clasificación.
La pregunta no es:
“¿Puede la IA diagnosticar un tumor cerebral?”
La pregunta correcta es:
“¿Puede un modelo aprender patrones presentes en este conjunto de imágenes y utilizarlos para clasificarlas?”
La diferencia es importante.
El modelo trabaja con las imágenes que le proporcionamos y aprende determinadas características de ellas. Después podemos comprobar cómo se comporta ante imágenes que no ha utilizado durante el entrenamiento.
Un porcentaje elevado de aciertos puede resultar llamativo, pero no convierte al modelo en una herramienta médica. Para utilizar un sistema de este tipo en medicina serían necesarios muchos más datos, estudios rigurosos, validación independiente, control de sesgos, evaluación clínica y supervisión de profesionales.
💡 ¿Qué aprendimos?
- Que una IA puede aprender a clasificar imágenes a partir de ejemplos.
- La diferencia entre datos de entrenamiento y datos de prueba.
- Que un modelo puede cometer falsos positivos y falsos negativos.
- Que un porcentaje de aciertos no cuenta toda la historia.
- Que los resultados dependen de los datos con los que hemos entrenado y evaluado el modelo.
- Y, sobre todo, que clasificar imágenes de un dataset no equivale a diagnosticar a una persona.
🫁 Proyecto 2. Cáncer de pulmón: cuando los datos no son imágenes
En el segundo proyecto hemos cambiado completamente de tipo de información.
En lugar de fotografías o resonancias, hemos trabajado con datos tabulares: diferentes variables asociadas a personas de un dataset y una variable que indica la clase correspondiente.
Aquí el modelo intenta encontrar relaciones entre las variables para realizar una clasificación.
También hemos podido observar qué variables tienen mayor importancia para ese modelo y dentro de ese conjunto de datos.
Y aquí aparece otra idea fundamental:
Que una variable sea importante para un modelo no significa automáticamente que sea la causa de una enfermedad.
Los modelos encuentran patrones. La investigación científica tiene que determinar qué significan esos patrones.
💡 ¿Qué aprendimos?
- Que la IA no trabaja solamente con imágenes: también puede analizar datos tabulares.
- Cómo utilizar un dataset para construir un modelo de clasificación.
- Que las variables pueden tener distinta importancia para las predicciones de un modelo.
- A interpretar una matriz de confusión y distinguir entre aciertos y errores.
- La importancia de separar los datos utilizados para entrenar el modelo de los utilizados para comprobarlo.
- Y una de las ideas fundamentales de la ciencia de datos:
Correlación o asociación no significa causalidad.
Que el modelo encuentre una relación en los datos no demuestra por sí solo que una variable provoque una enfermedad.
🔬 Proyecto 3. Cáncer de piel: volver a las imágenes
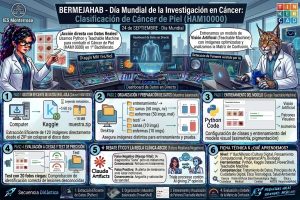
Finalmente hemos trabajado con HAM10000, un conocido conjunto de imágenes dermatológicas, utilizando Teachable Machine y Python.
De nuevo, el objetivo ha sido comprobar si un modelo puede aprender a distinguir diferentes categorías presentes en las imágenes.
Pero, una vez más, hay que distinguir entre:
clasificar imágenes de un dataset
y
diagnosticar a una persona.
Son cosas completamente diferentes.
Nuestro experimento sirve para aprender cómo funcionan los modelos de clasificación y para plantearnos preguntas sobre los datos, los errores y la capacidad de generalización de un modelo.
No sirve para realizar diagnósticos médicos.
💡 ¿Qué aprendimos?
- Cómo utilizar un dataset real de imágenes médicas.
- Cómo preparar ejemplos para entrenar un clasificador.
- Cómo utilizar Teachable Machine para crear un modelo de clasificación.
- Cómo llevar ese modelo a Python y utilizarlo con nuevas imágenes.
- Que el comportamiento de un modelo depende de las imágenes que ha visto durante su entrenamiento.
- Que debemos comprobar qué ocurre cuando presentamos al modelo datos nuevos.
- Y, nuevamente, que un buen resultado experimental no convierte automáticamente un modelo educativo en una herramienta clínica.
📊 Entonces, ¿para qué sirve la IA?
Esta es probablemente la pregunta más importante de toda la jornada.
La Inteligencia Artificial puede ser una herramienta extraordinariamente útil para los investigadores.
Puede ayudar a:
- analizar grandes cantidades de datos;
- encontrar patrones difíciles de detectar manualmente;
- clasificar imágenes;
- comparar información;
- generar predicciones;
- localizar relaciones que después pueden ser estudiadas por los investigadores.
Pero encontrar un patrón no es lo mismo que demostrar una explicación.
Y obtener una predicción tampoco significa que esa predicción sea correcta.
Por eso, cuando trabajamos con IA, necesitamos volver continuamente a las preguntas fundamentales de la ciencia:
¿De dónde proceden los datos?
¿Son suficientes?
¿Son representativos?
¿Qué errores comete el modelo?
¿Funciona igual con datos nuevos?
¿Podemos reproducir los resultados?
¿Qué significa realmente el patrón que hemos encontrado?
🧪 La IA es una herramienta, no el investigador
Quizá esta sea la idea que queremos que nuestros alumnos se lleven de esta jornada.
Una calculadora puede hacer una operación mucho más rápido que nosotros.
Un microscopio puede permitirnos observar estructuras que nuestros ojos no pueden distinguir.
Un telescopio puede mostrarnos objetos que se encuentran a enormes distancias.
Un ordenador puede analizar millones de datos.
Y un modelo de Inteligencia Artificial puede encontrar determinados patrones en esos datos.
Pero ninguna de esas herramientas sustituye el trabajo científico.
La herramienta puede ayudar a observar, medir, calcular, clasificar o encontrar patrones.
La persona tiene que plantear las preguntas, decidir qué datos son adecuados, interpretar los resultados, comprobar los errores y decidir qué conclusiones están realmente justificadas.
Por eso no se trata de que:
“la IA ha descubierto que…”
sino de que:
“hemos utilizado un modelo de IA para analizar estos datos y hemos observado que…”
Y después viene la parte verdaderamente científica:
¿Es suficiente esa evidencia para sacar una conclusión?
Muchas veces, la respuesta será no todavía.
Y eso no significa que la IA haya fracasado.
Significa que estamos haciendo ciencia.
🔬 De los datos a la evidencia
Los tres proyectos nos han permitido recorrer, de una manera muy sencilla, una pequeña parte del camino que existe entre los datos y el conocimiento científico:
DATOS → PATRONES → MODELO → PREDICCIÓN → COMPROBACIÓN → EVIDENCIA
Cada paso plantea nuevas preguntas.
Y cada resultado necesita ser comprobado.
Ese es precisamente uno de los aprendizajes que queremos incorporar a AIDARAC: Aprendizaje de Inteligencia Artificial y ciencia de Datos con Resultados en Acciones de Ciencia Ciudadana.
No queremos enseñar solamente a utilizar herramientas de Inteligencia Artificial.
Queremos aprender a hacer preguntas con los datos, experimentar, comprobar resultados y reconocer los límites de lo que podemos afirmar.
🌍 La investigación sigue siendo humana
La investigación contra el cáncer es un enorme trabajo colectivo en el que participan médicos, biólogos, genetistas, especialistas en imagen, estadísticos, ingenieros, científicos de datos y muchos otros profesionales.
La IA puede formar parte de ese trabajo.
Puede ayudar a acelerar determinadas tareas y a analizar información que sería muy difícil estudiar manualmente.
Pero sigue siendo una herramienta.
Una herramienta muy potente, sí. Pero una herramienta al servicio de las personas y de la investigación científica.
Y quizá esa sea la mejor conclusión para nuestro Día Mundial de la Investigación en Cáncer:
No se trata de enseñar a una máquina a sustituir al investigador.
Se trata de aprender a utilizar nuevas herramientas para que los investigadores puedan hacer mejores preguntas, analizar más datos y encontrar nuevas respuestas.
🏠 Investigar también puede empezar desde casa
Hay otra idea que queremos que quede clara después de esta experiencia.
Para empezar a investigar no siempre necesitamos un laboratorio, equipamiento sofisticado o grandes recursos. También podemos comenzar trabajando con datos abiertos, datasets reales y herramientas que están al alcance de cualquier estudiante con un ordenador y conexión a Internet.
En estas actividades hemos utilizado Kaggle, Teachable Machine y Python, entre otras herramientas. No porque queramos convertir a nuestros alumnos en investigadores médicos, sino porque queremos proporcionarles algo que consideramos mucho más importante: herramientas para hacerse preguntas y empezar a buscar respuestas por sí mismos.
Un alumno puede descargar un dataset, plantear una pregunta, analizar los datos, entrenar un modelo, comprobar sus resultados, descubrir que se ha equivocado y volver a empezar.
Eso también es aprender a investigar.
La Inteligencia Artificial hace que algunas de estas posibilidades sean ahora mucho más accesibles. Pero la herramienta no hace el trabajo científico por nosotros.
La pregunta sigue siendo nuestra. Los datos hay que comprenderlos. Los resultados hay que comprobarlos. Y las conclusiones hay que justificarlas.
Por eso, nuestro objetivo no es enseñar a los alumnos que “la IA puede detectar el cáncer”.
Queremos que descubran algo mucho más útil:
“Tengo acceso a datos y herramientas. Puedo plantear una pregunta, experimentar, analizar resultados y aprender de ellos.”
Y quizá ahí esté una de las grandes oportunidades educativas de la ciencia de datos y la Inteligencia Artificial: poner herramientas de investigación en manos de los alumnos y enseñarles a utilizarlas con curiosidad, rigor y pensamiento crítico.
Porque investigar no tiene por qué empezar en un laboratorio.
A veces puede empezar en casa, delante de un ordenador, con una buena pregunta.
🔬 MONTESTEAM — IES Monterroso
Etiqueta:AIDARAC, aprendizaje automático, Cáncer, cáncer de piel, cáncer de pulmón, ciencia de datos, clasificación de imágenes, datasets médicos, datos biomédicos, Día Mundial de la Investigación en Cáncer, HAM10000, ia, inteligencia artificial, investigación del cáncer, machine learning, Pensamiento Crítico, python, Teachable Machine, Tumores Cerebrales