Enseñamos a una IA a reconocer piedra, papel y tijera con fotos de tu mano y la conectamos a Scratch para jugar. Aprendemos condicionales, variables y confianza.
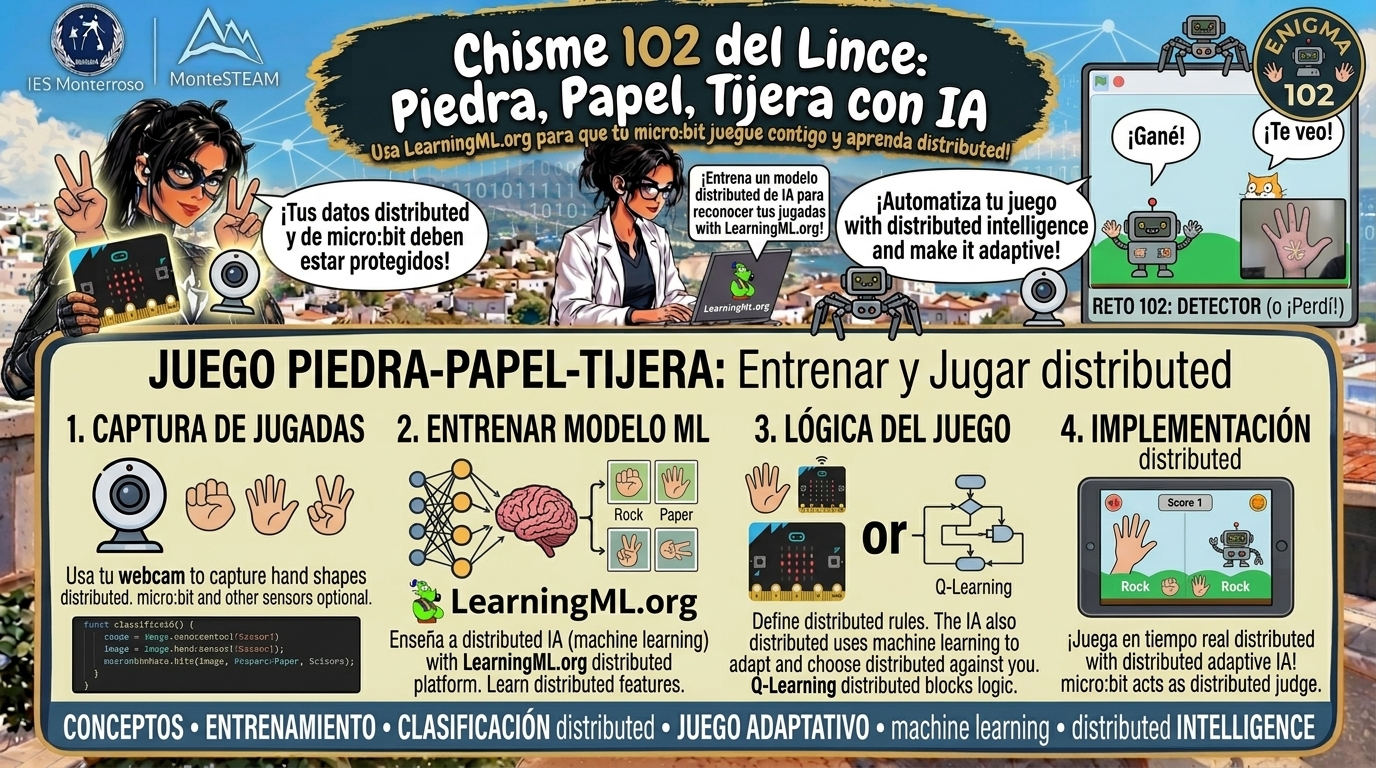

Enseñamos a una IA a reconocer piedra, papel y tijera con fotos de tu mano y la conectamos a Scratch para jugar. Aprendemos condicionales, variables y confianza.
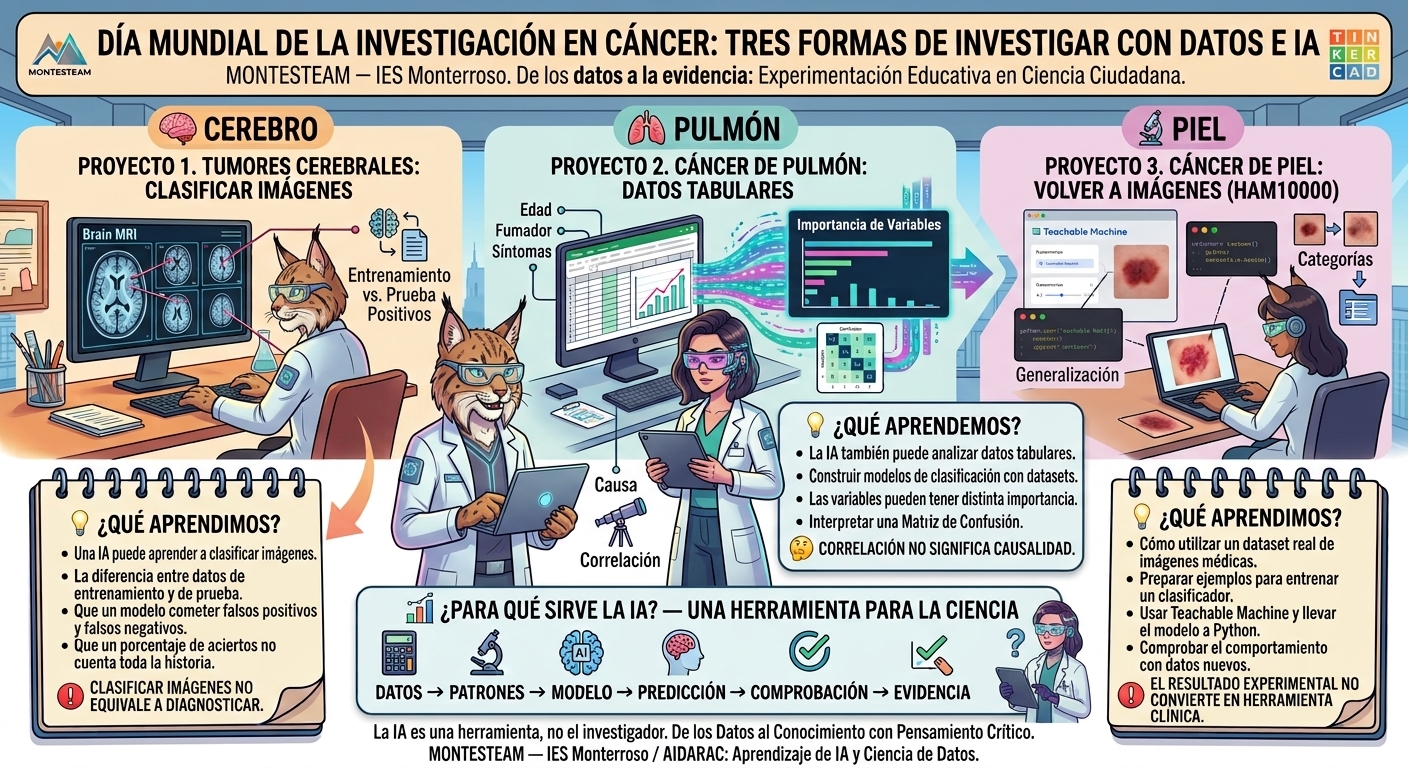
En el Día Mundial de la Investigación en Cáncer, MONTESTEAM explora tres aplicaciones educativas de la Inteligencia Artificial y la ciencia de datos con datasets reales sobre tumores cerebrales, cáncer de pulmón y cáncer de piel. Una experiencia para aprender a clasificar imágenes, analizar datos y, sobre todo, comprender que la IA es una herramienta de apoyo a la investigación, no un sustituto del trabajo científico.
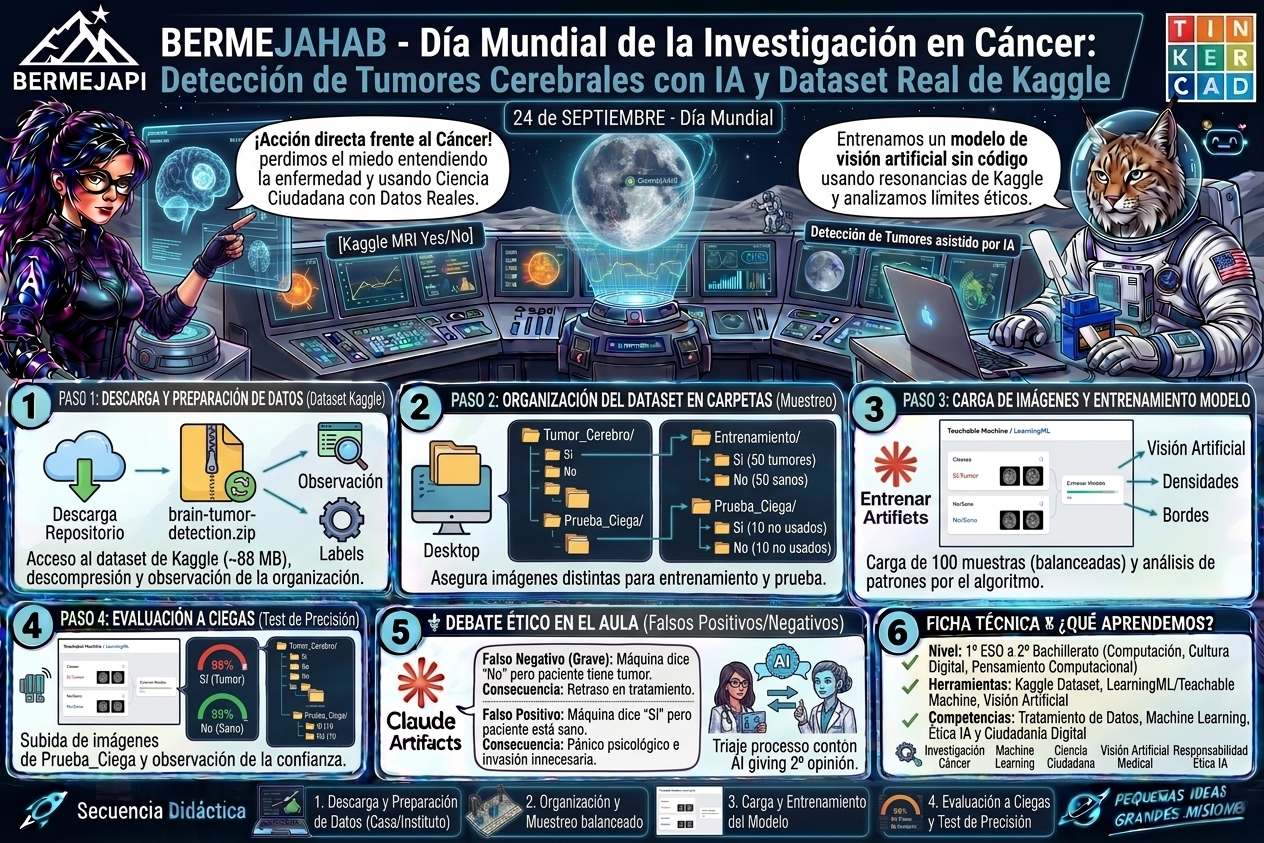
Taller práctico de Ciencia Ciudadana e IA para el Día Mundial de la Investigación en Cáncer. Clasificación de tumores cerebrales con Kaggle y visión artificial.
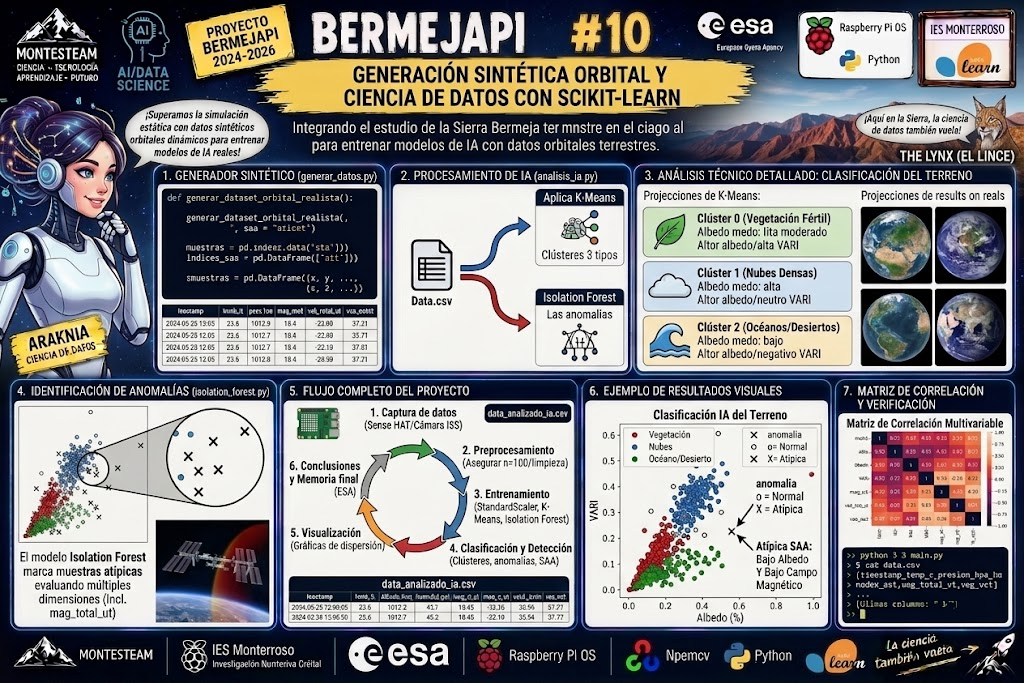
En la décima entrega del proyecto BermejaPi, desarrollamos un generador de telemetría sintética orbital de alta precisión para superar las limitaciones de la simulación estática. Con datos variados y realistas, aplicamos algoritmos no supervisados de Scikit-Learn (K-Means e Isolation Forest), clasificando de forma autónoma tres tipos de biomas terrestres (océanos, vegetación fértil y nubes) e identificando anomalías magnéticas compatibles con la SAA, consolidando la rama de Ciencia de Datos para la memoria final de la ESA.
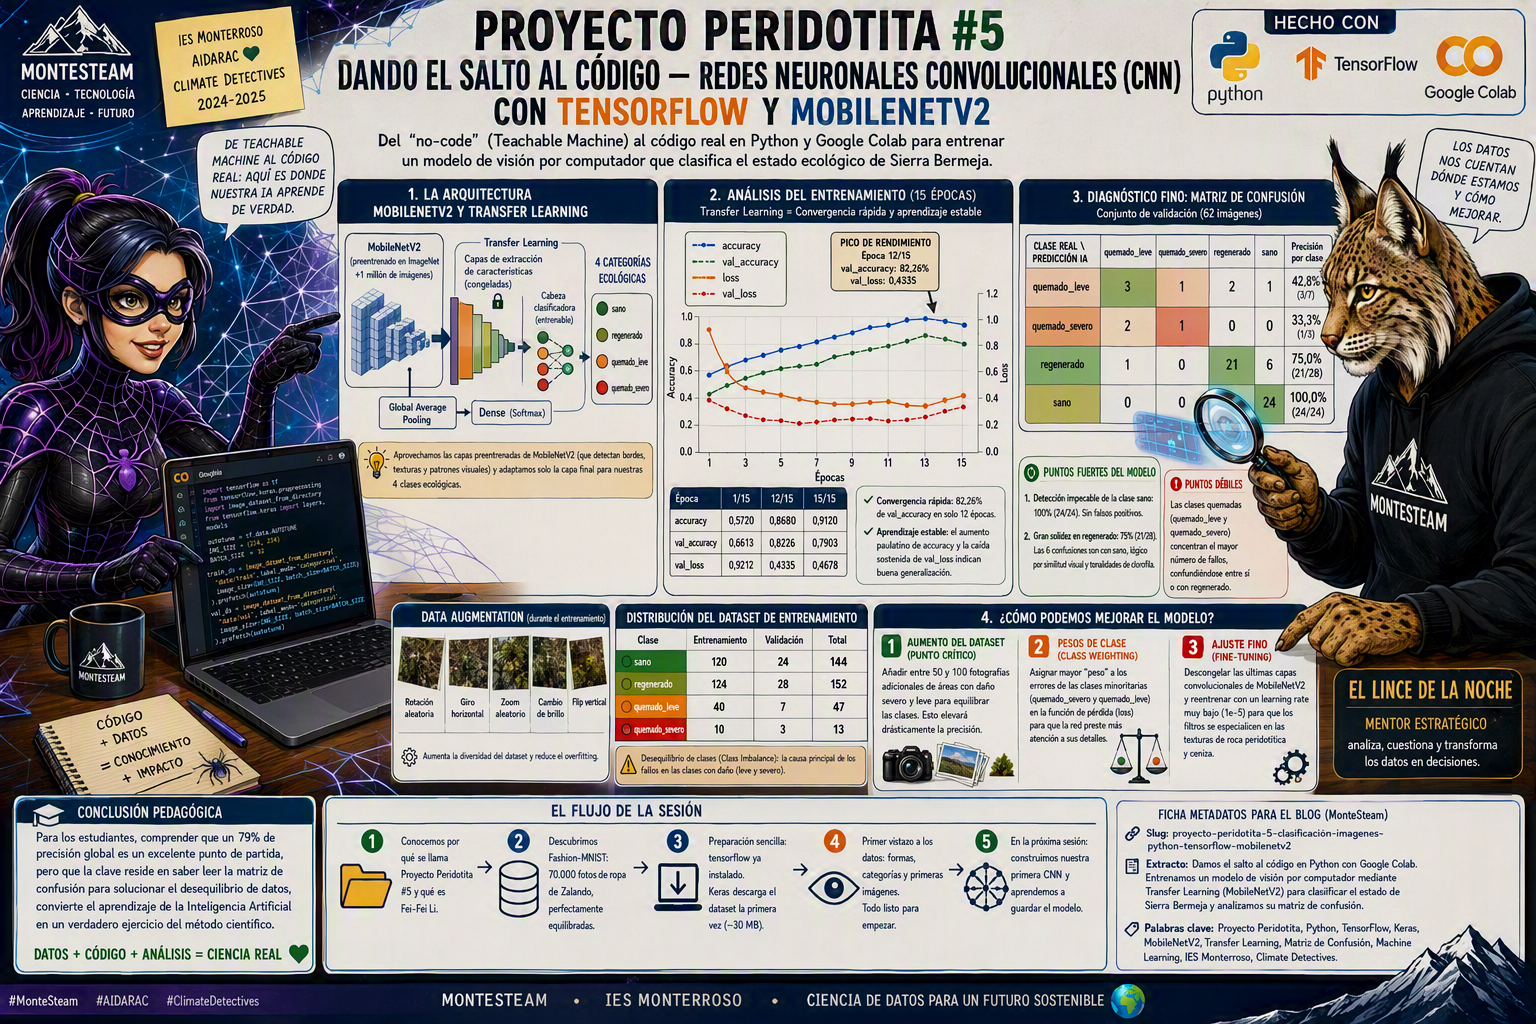
Damos el salto al código en Python con Google Colab. Entrenamos un modelo de visión por computador mediante Transfer Learning (MobileNetV2) para clasificar el estado de Sierra Bermeja y analizamos su matriz de confusión.
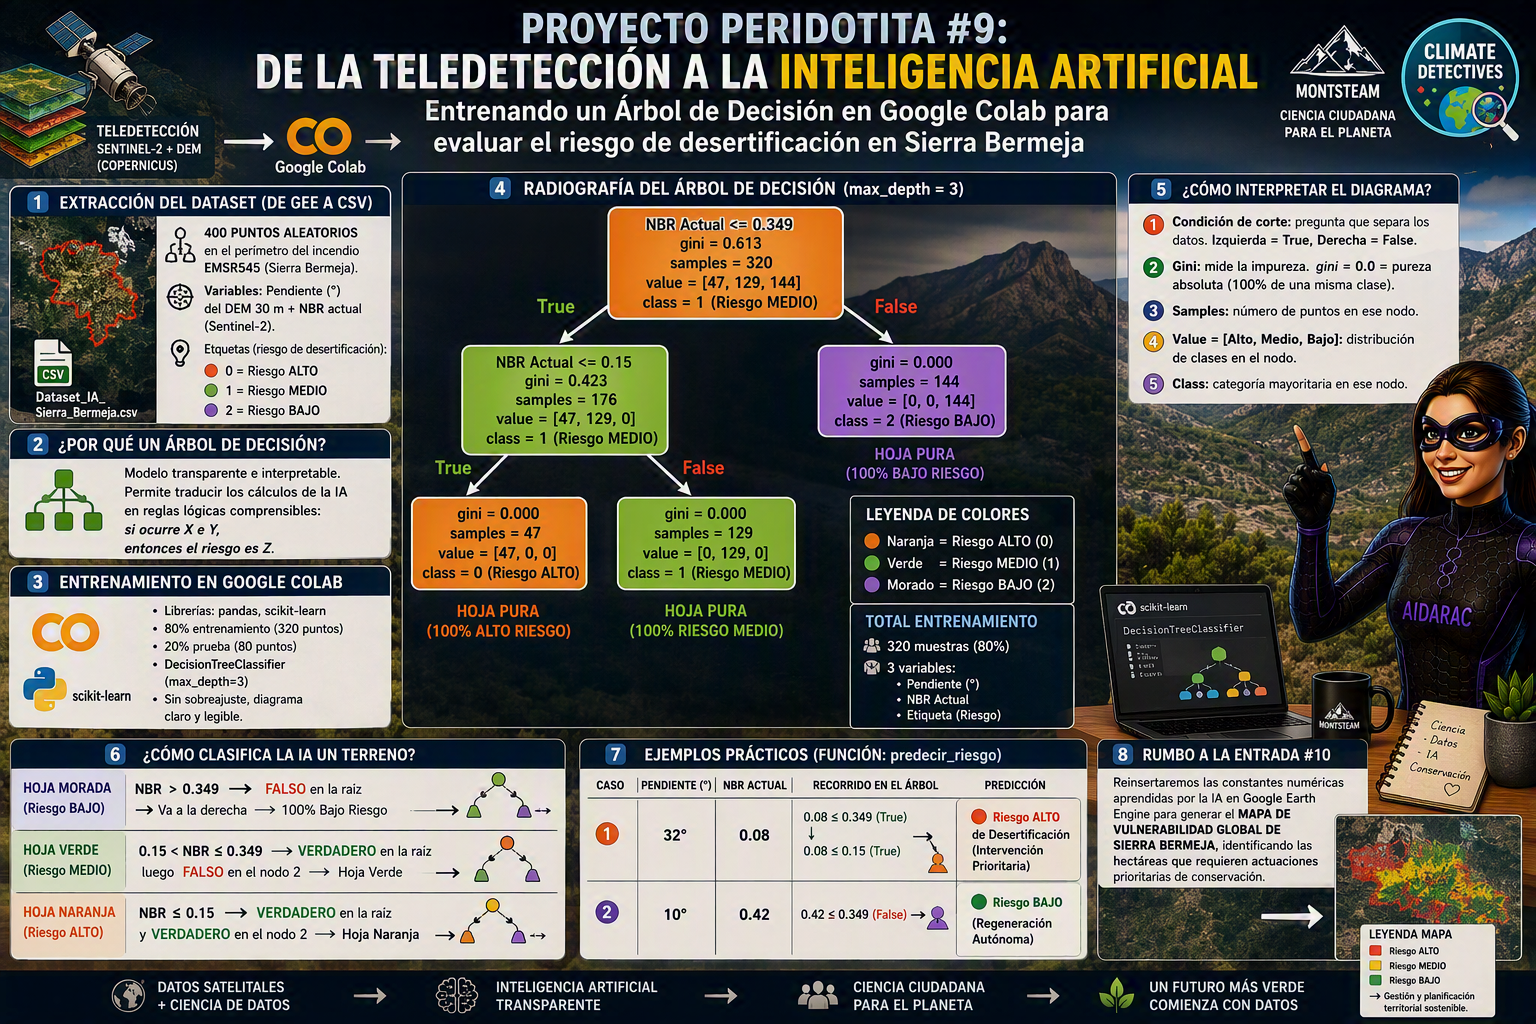
Damos el salto de la observación satelital a la Inteligencia Artificial. Exportamos datos multivariable de Google Earth Engine a Google Colab y entrenamos un Árbol de Decisión con Python (scikit-learn) para predecir los niveles de riesgo de desertificación en Sierra Bermeja. Desgranamos paso a paso el significado científico de cada parámetro del modelo dentro del proyecto Climate Detectives.

Damos el salto a la Inteligencia Artificial aplicada. Descubre cómo automatizamos con Google Earth Engine la generación de un dataset de 312 teselas satelitales de Sierra Bermeja y cómo usarlas en LearningML o Teachable Machine para crear un sistema experto que evalúa la regeneración del bosque.
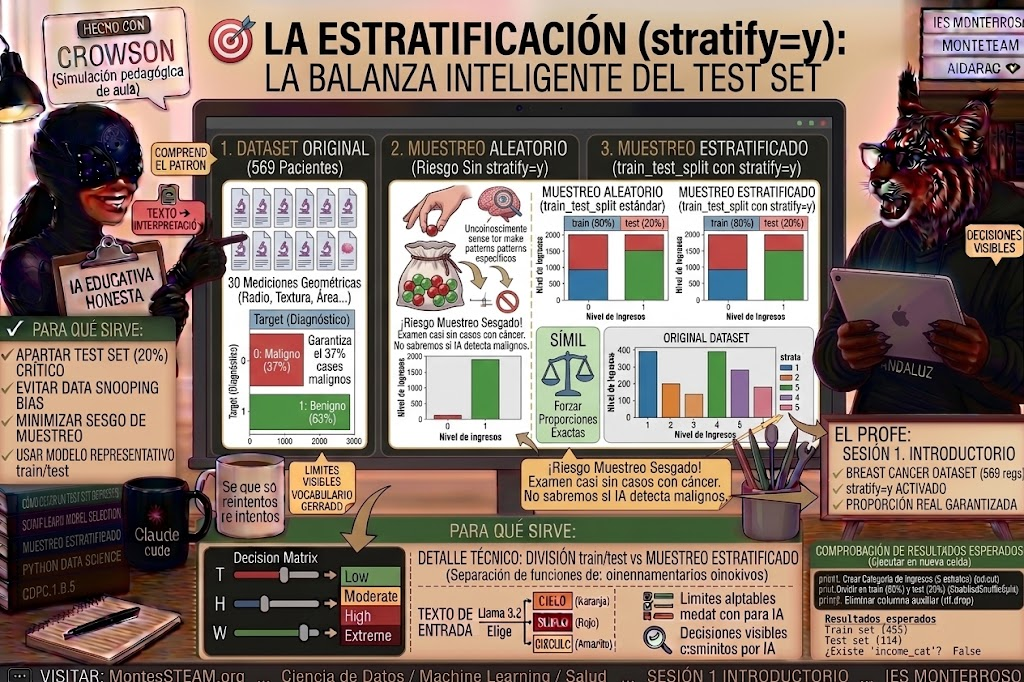
En este tutorial introductorio de Ciencia de Datos para MontesSTEAM e IES Monterroso, damos los primeros pasos en Machine Learning aplicado a la salud mediante el dataset real Breast Cancer Wisconsin. Aprende a instalar scikit-learn en JupyterLab, cargar datos médicos en memoria, reservar un conjunto de prueba para evaluar el modelo y comprender la importancia de la estratificación (stratify=y) para garantizar un reparto equilibrado entre tumores benignos y malignos.
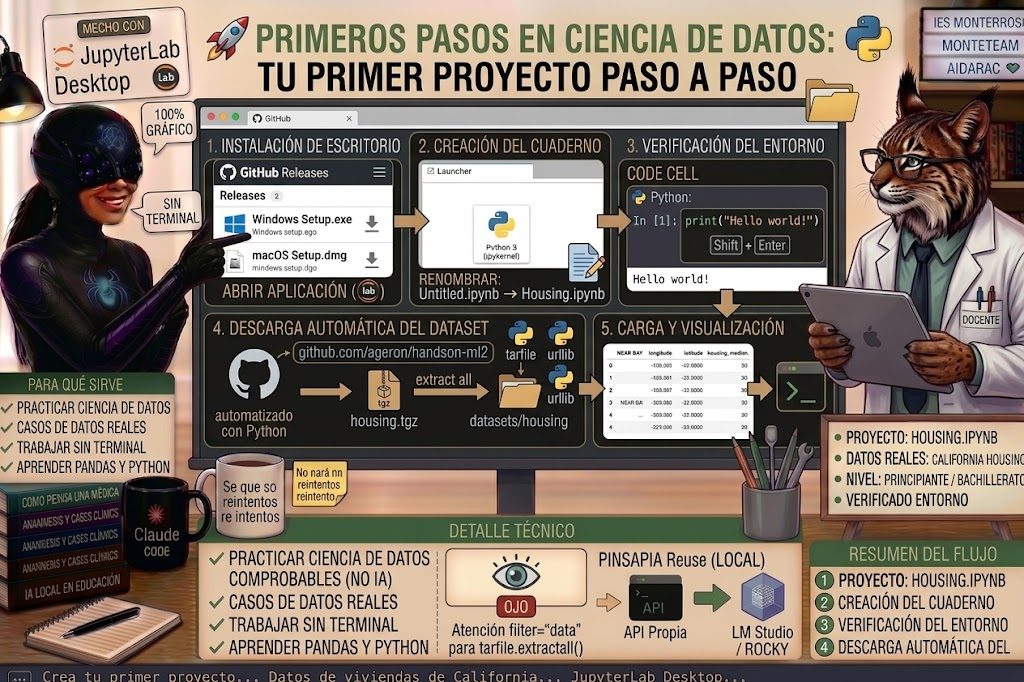
Aprende a configurar un entorno de Ciencia de Datos en local con JupyterLab Desktop de forma 100% visual y sin usar comandos de consola. Guía paso a paso para descargar y visualizar tu primer conjunto de datos real con Python y Pandas para proyectos de Inteligencia Artificial y pensamiento computacional.
Benigno Maligno IMAGEN DE PRUEBA BENIGNO IMAGEN DE PRUEBA MALIGNO