Análisis de hábitos y síntomas de cáncer de pulmón con Árboles de Decisión en Python directamente en Kaggle Notebooks para 1º de Bachillerato.
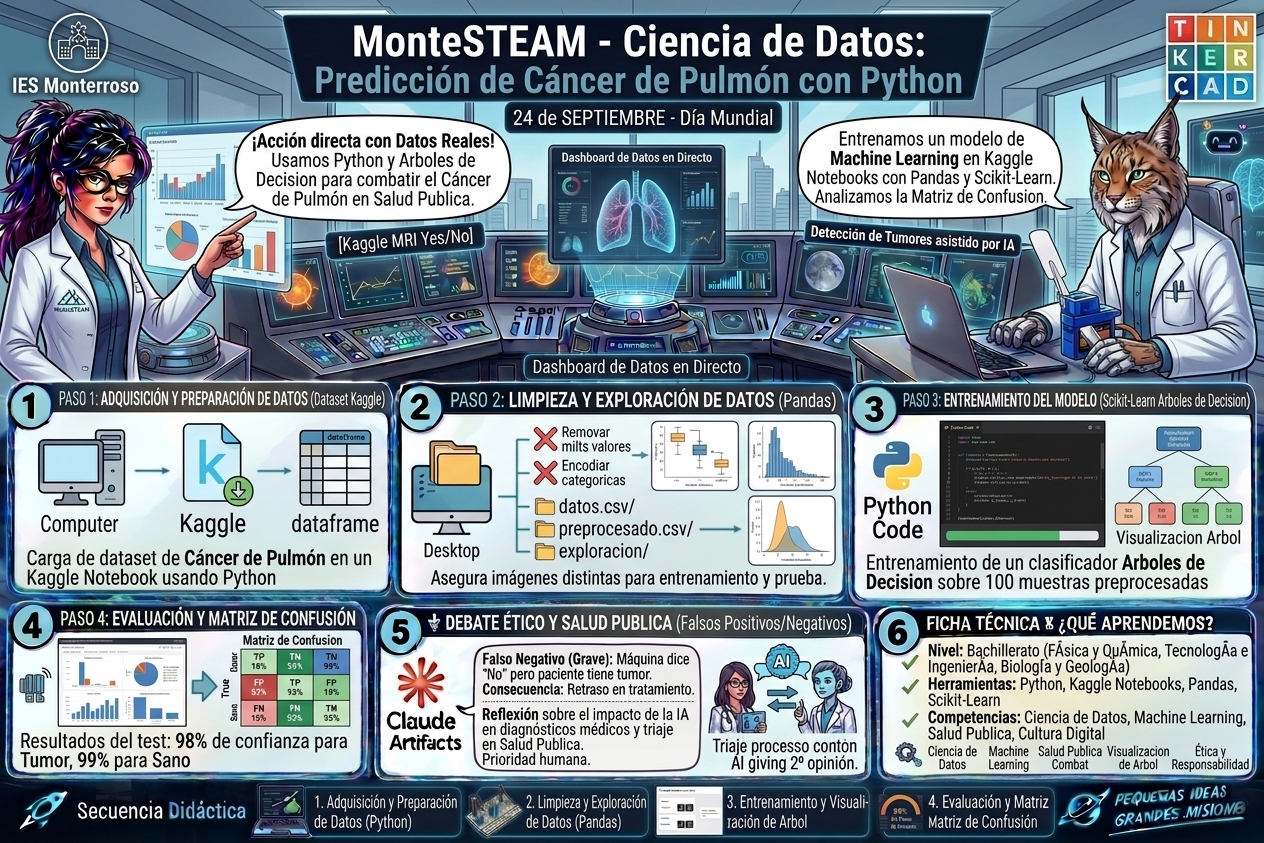

Análisis de hábitos y síntomas de cáncer de pulmón con Árboles de Decisión en Python directamente en Kaggle Notebooks para 1º de Bachillerato.
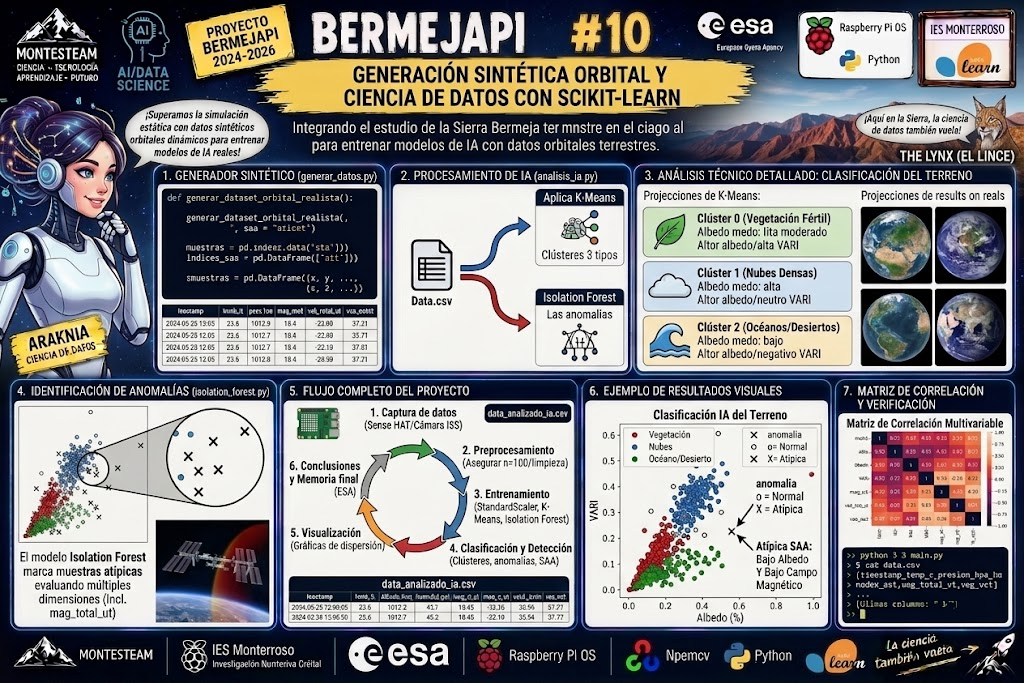
En la décima entrega del proyecto BermejaPi, desarrollamos un generador de telemetría sintética orbital de alta precisión para superar las limitaciones de la simulación estática. Con datos variados y realistas, aplicamos algoritmos no supervisados de Scikit-Learn (K-Means e Isolation Forest), clasificando de forma autónoma tres tipos de biomas terrestres (océanos, vegetación fértil y nubes) e identificando anomalías magnéticas compatibles con la SAA, consolidando la rama de Ciencia de Datos para la memoria final de la ESA.
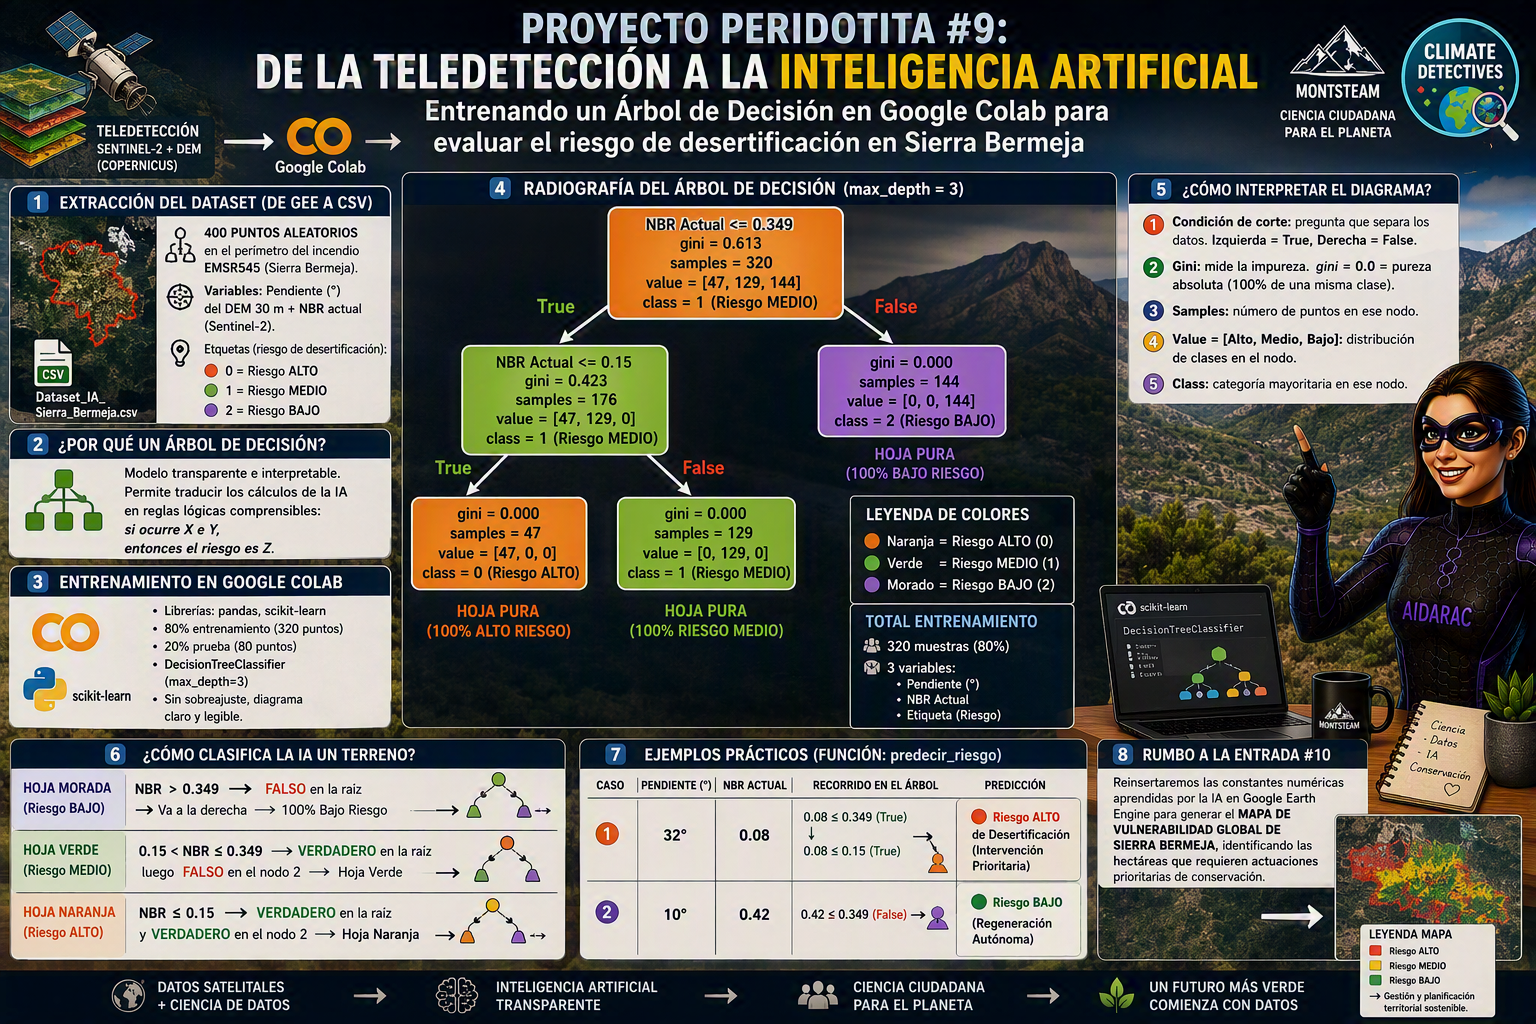
Damos el salto de la observación satelital a la Inteligencia Artificial. Exportamos datos multivariable de Google Earth Engine a Google Colab y entrenamos un Árbol de Decisión con Python (scikit-learn) para predecir los niveles de riesgo de desertificación en Sierra Bermeja. Desgranamos paso a paso el significado científico de cada parámetro del modelo dentro del proyecto Climate Detectives.
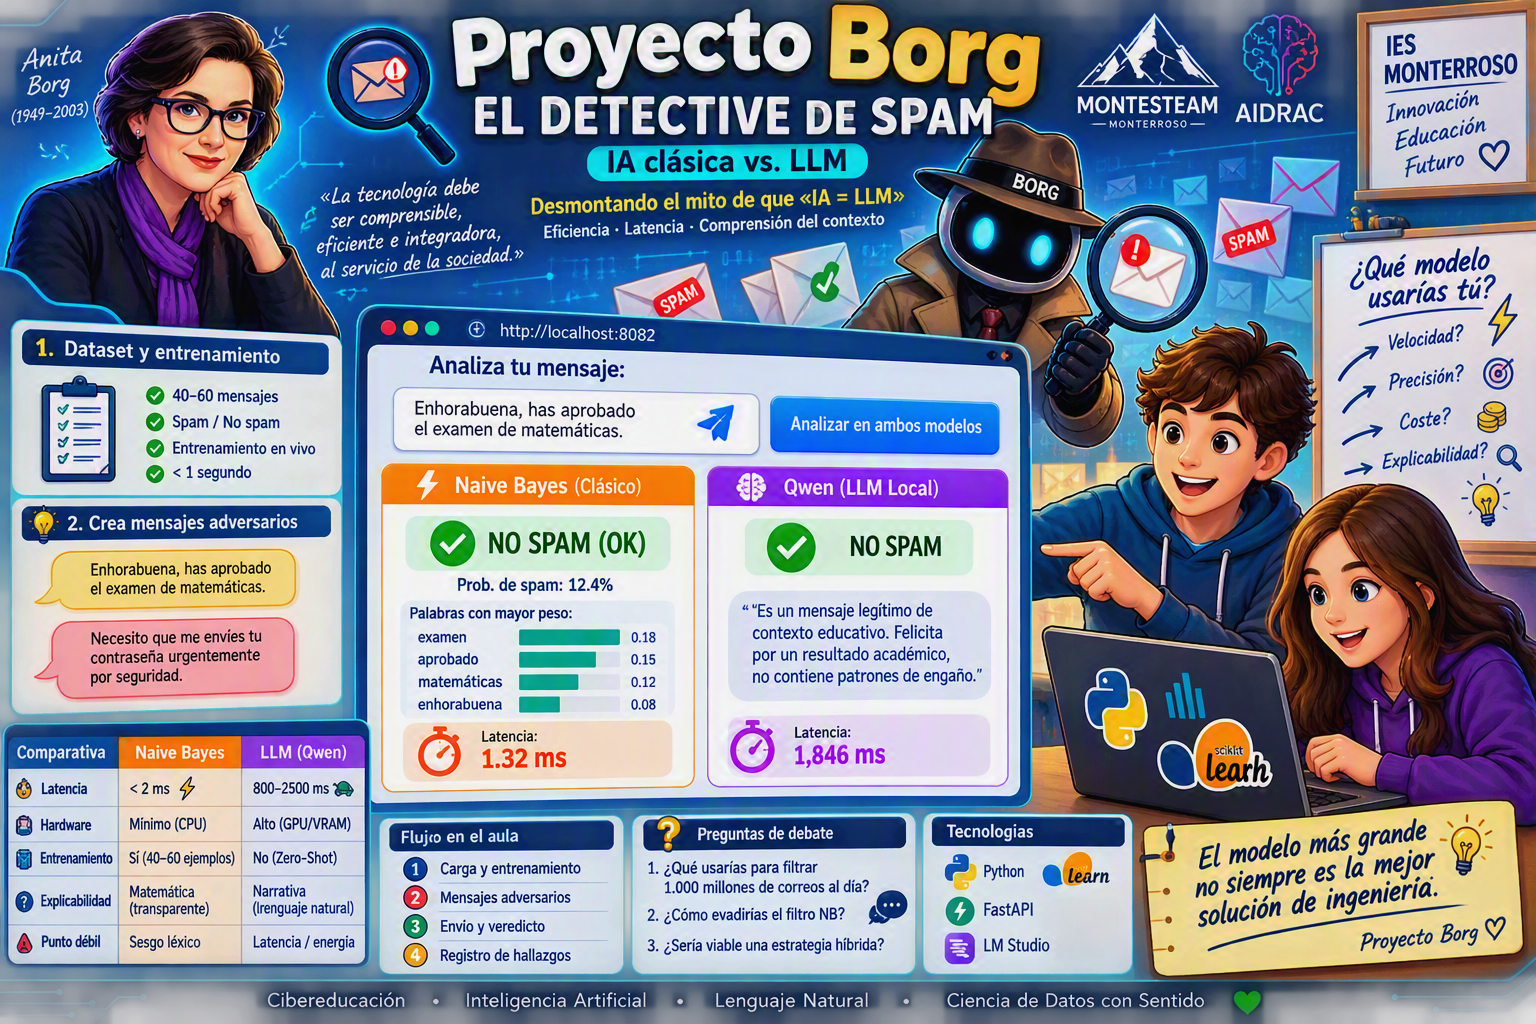
En el marco de las iniciativas MonteSTEAM y AIDRAC del IES Monterroso, presentamos el Proyecto Borg: una actividad de cibereducación que rinde homenaje a la informática Anita Borg. La aplicación contrapone un clasificador de spam clásico (Naive Bayes con Scikit-Learn) a un LLM local (Qwen) en el puerto 8082, permitiendo al alumnado comprobar con datos reales de latencia e interpretabilidad que el modelo más grande y caro no siempre es la mejor solución de ingeniería.
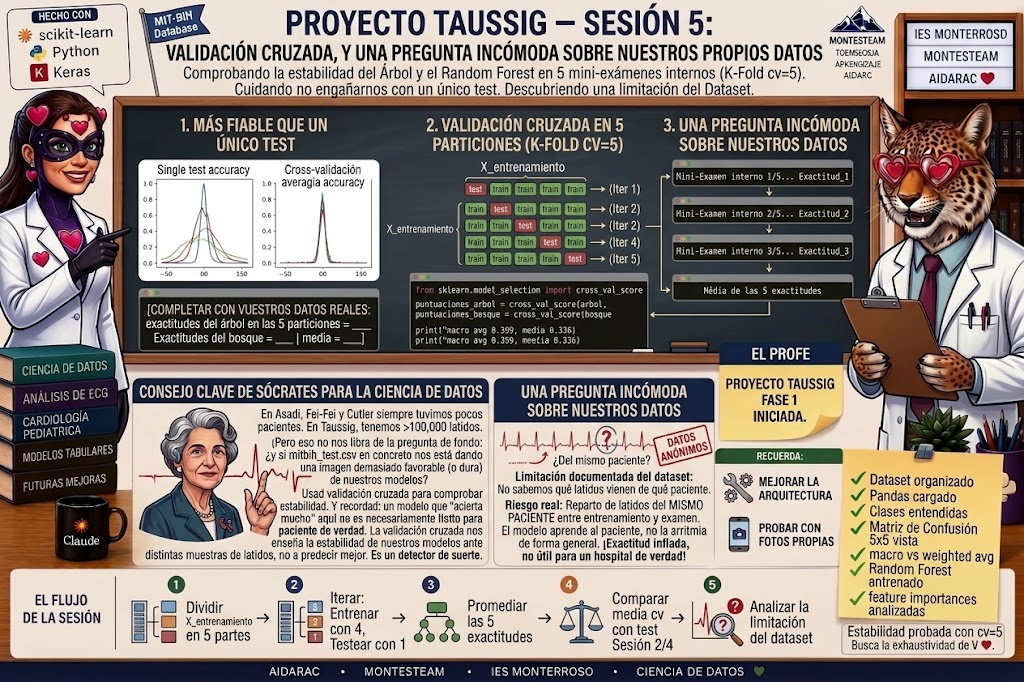
En la Sesion 5 del Proyecto Taussig, el alumnado usa validacion cruzada con scikit-learn para comprobar la estabilidad de sus modelos de arritmia cardiaca, y descubre una limitacion real y documentada del dataset de ECG: no se sabe que latidos pertenecen al mismo paciente.
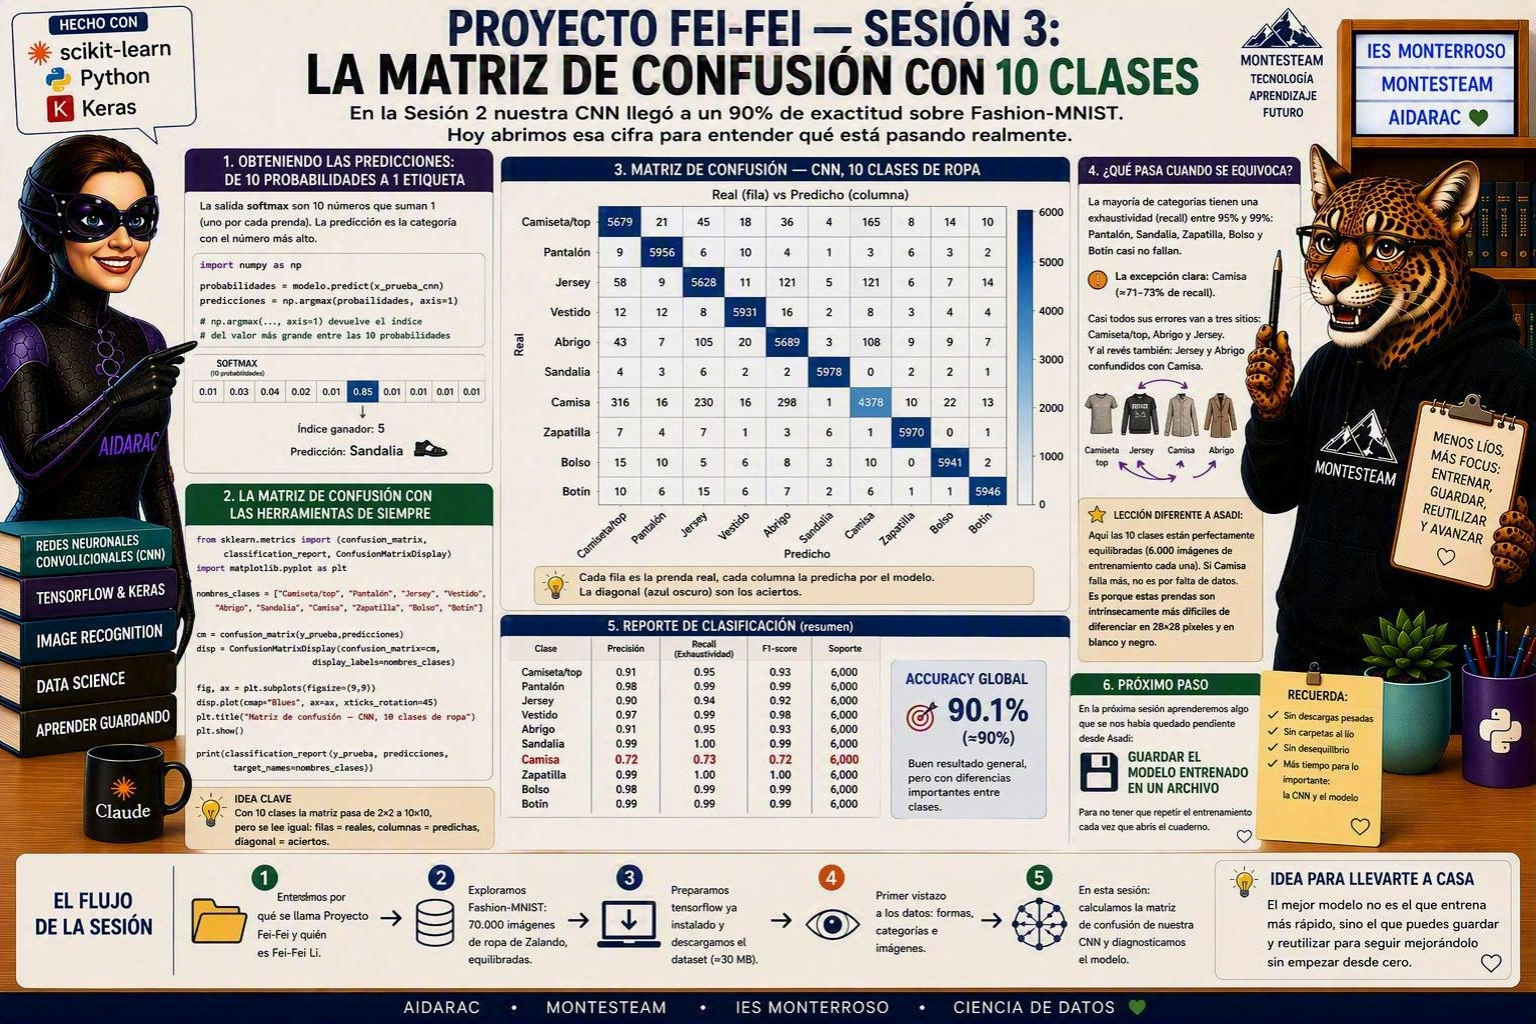
En la Sesion 3 del Proyecto Fei-Fei, el alumnado calcula la matriz de confusion de su CNN sobre las 10 categorias de Fashion-MNIST y descubre que Camisa es la prenda mas dificil de reconocer, confundida con Camiseta, Jersey y Abrigo pese a que las clases estan perfectamente equilibradas.
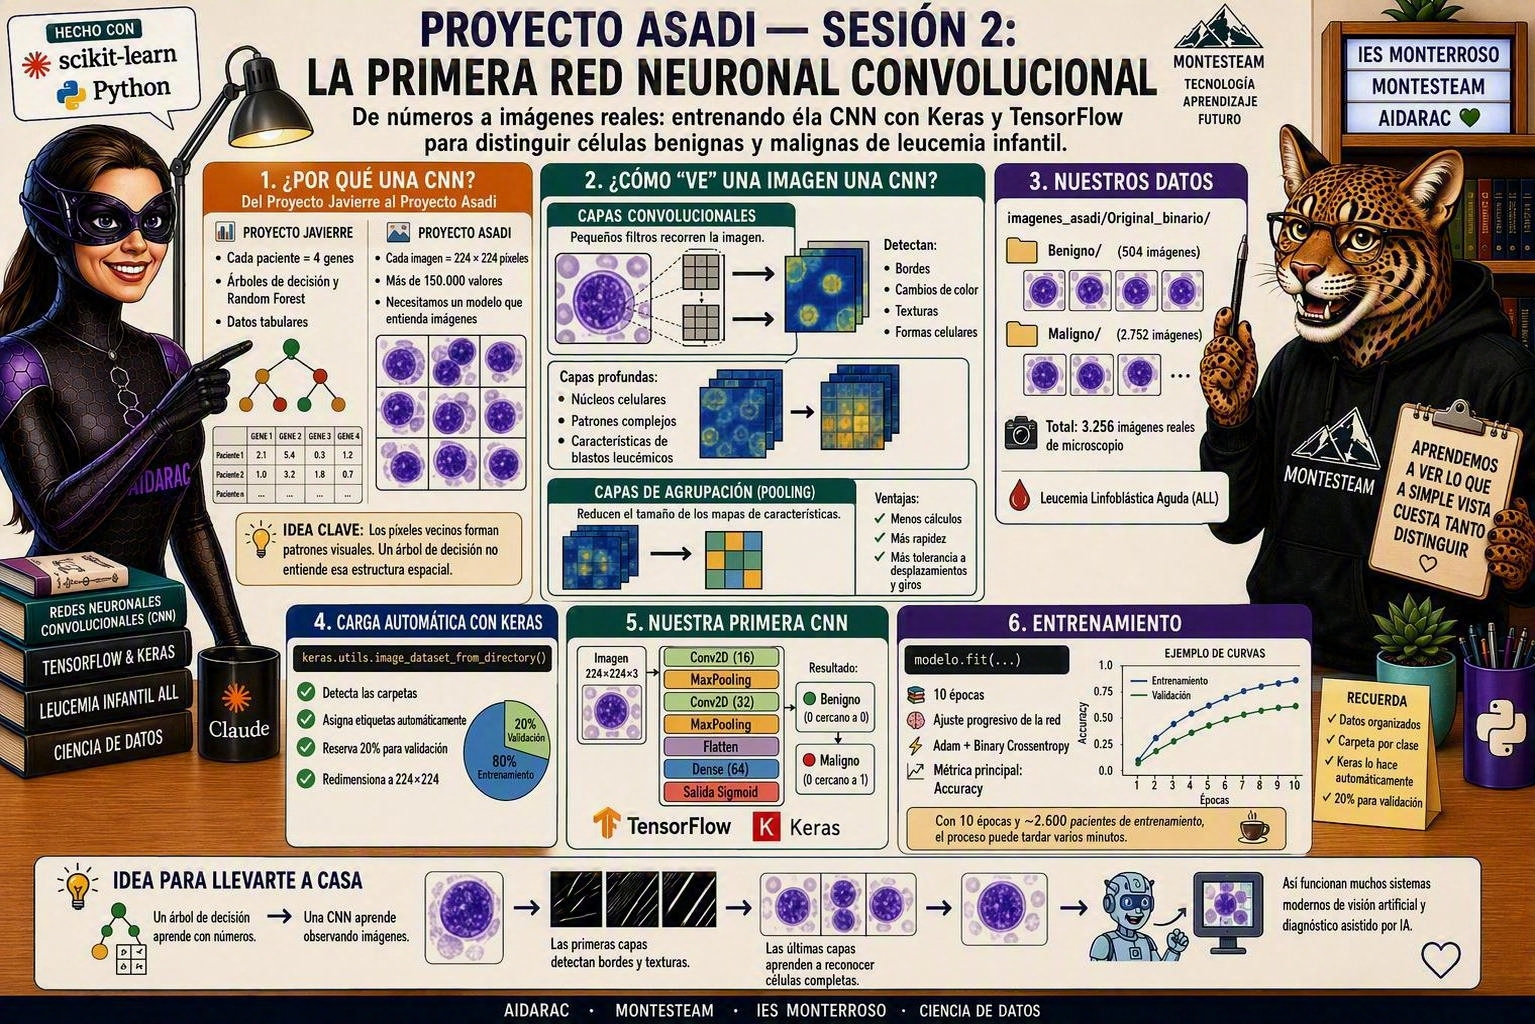
En la Sesion 3 del Proyecto Asadi, el alumnado calcula la matriz de confusion de su CNN sobre benigno/maligno y descubre por que el fuerte desequilibrio entre clases (504 benignas frente a 2752 malignas) puede sesgar los resultados.
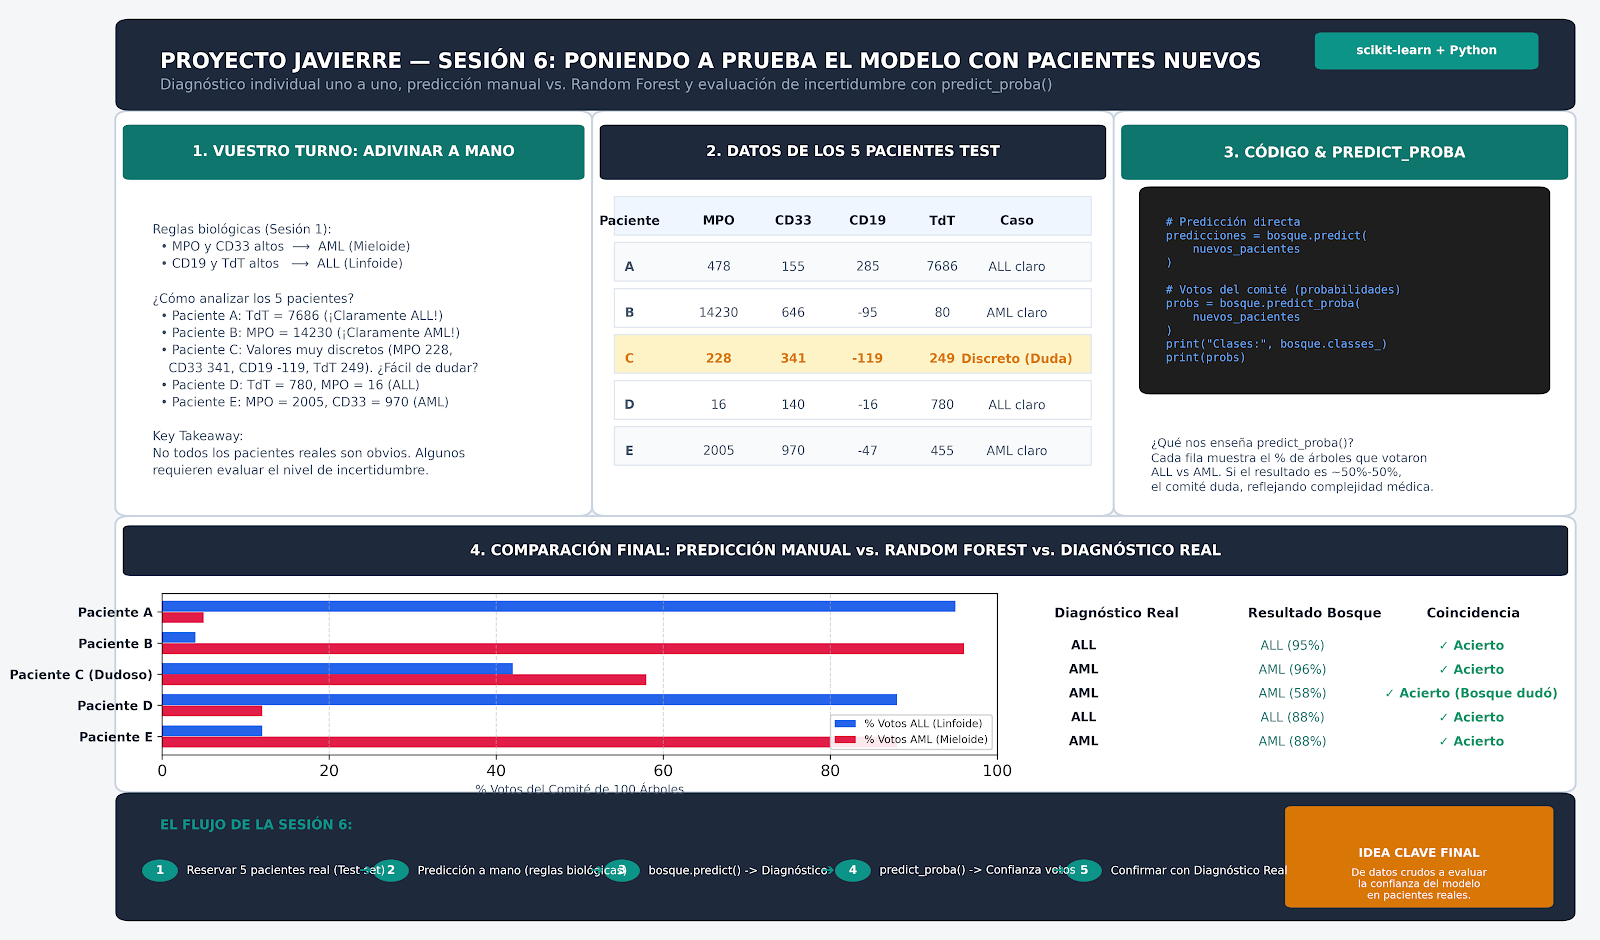
En la Sesion 6 del Proyecto Javierre, el alumnado predice a mano el diagnostico de cinco pacientes reales nunca vistos por el modelo, compara su respuesta con la del Random Forest y con el diagnostico real, cerrando el recorrido del proyecto.
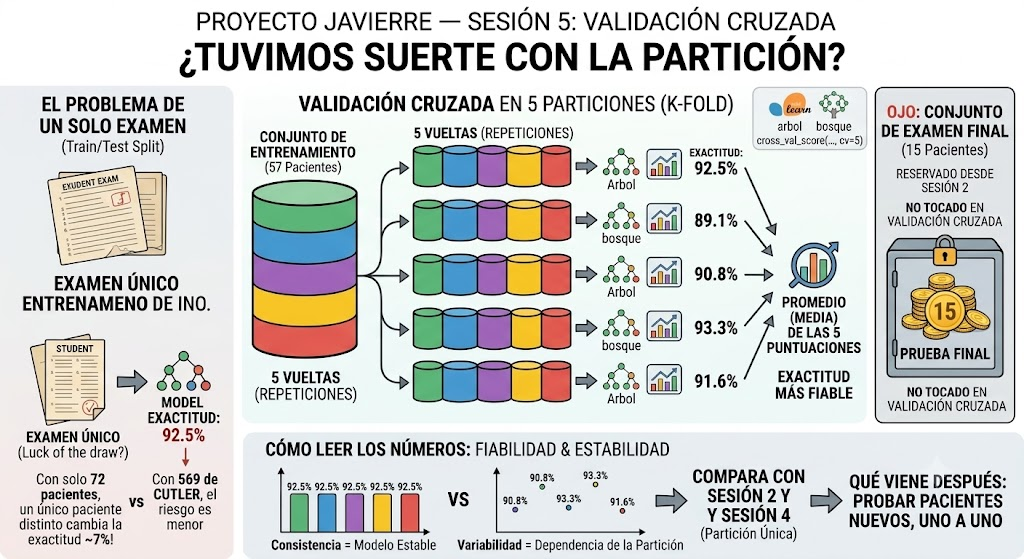
En la Sesion 5 del Proyecto Javierre, el alumnado usa validacion cruzada con scikit-learn para comprobar si la exactitud de sus modelos sobre leucemia infantil dependia de la suerte de una unica particion de solo 15 pacientes de examen.
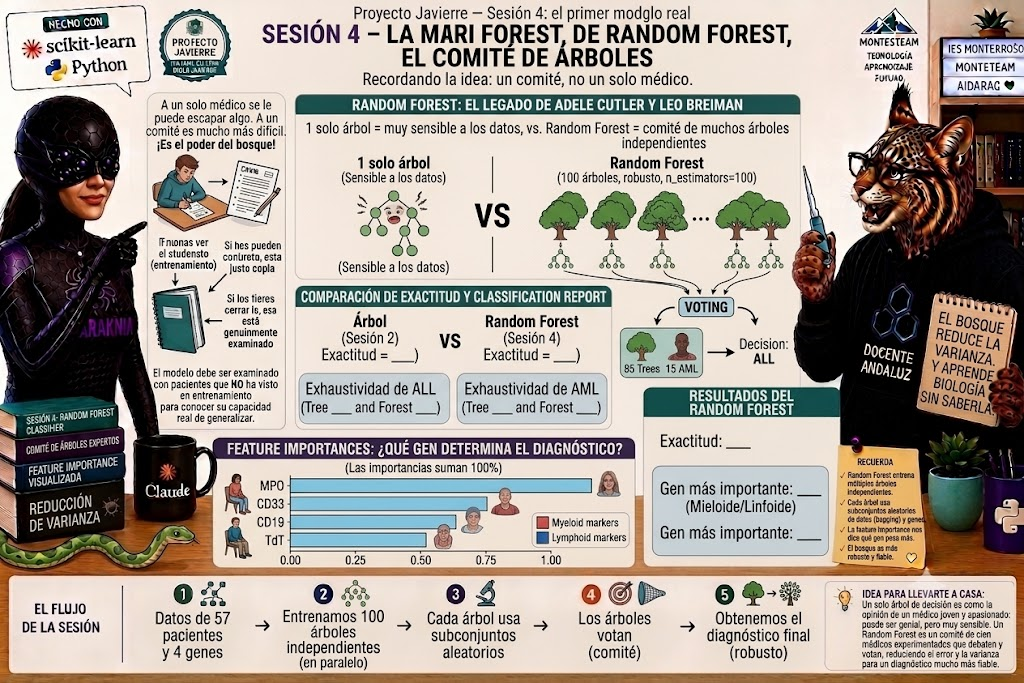
En la Sesion 4 del Proyecto Javierre, el alumnado entrena un Random Forest sobre los cuatro genes seleccionados y comprueba, con feature importances, si el algoritmo aprende a apoyarse en los mismos marcadores mieloides y linfoides elegidos por su significado clinico real.