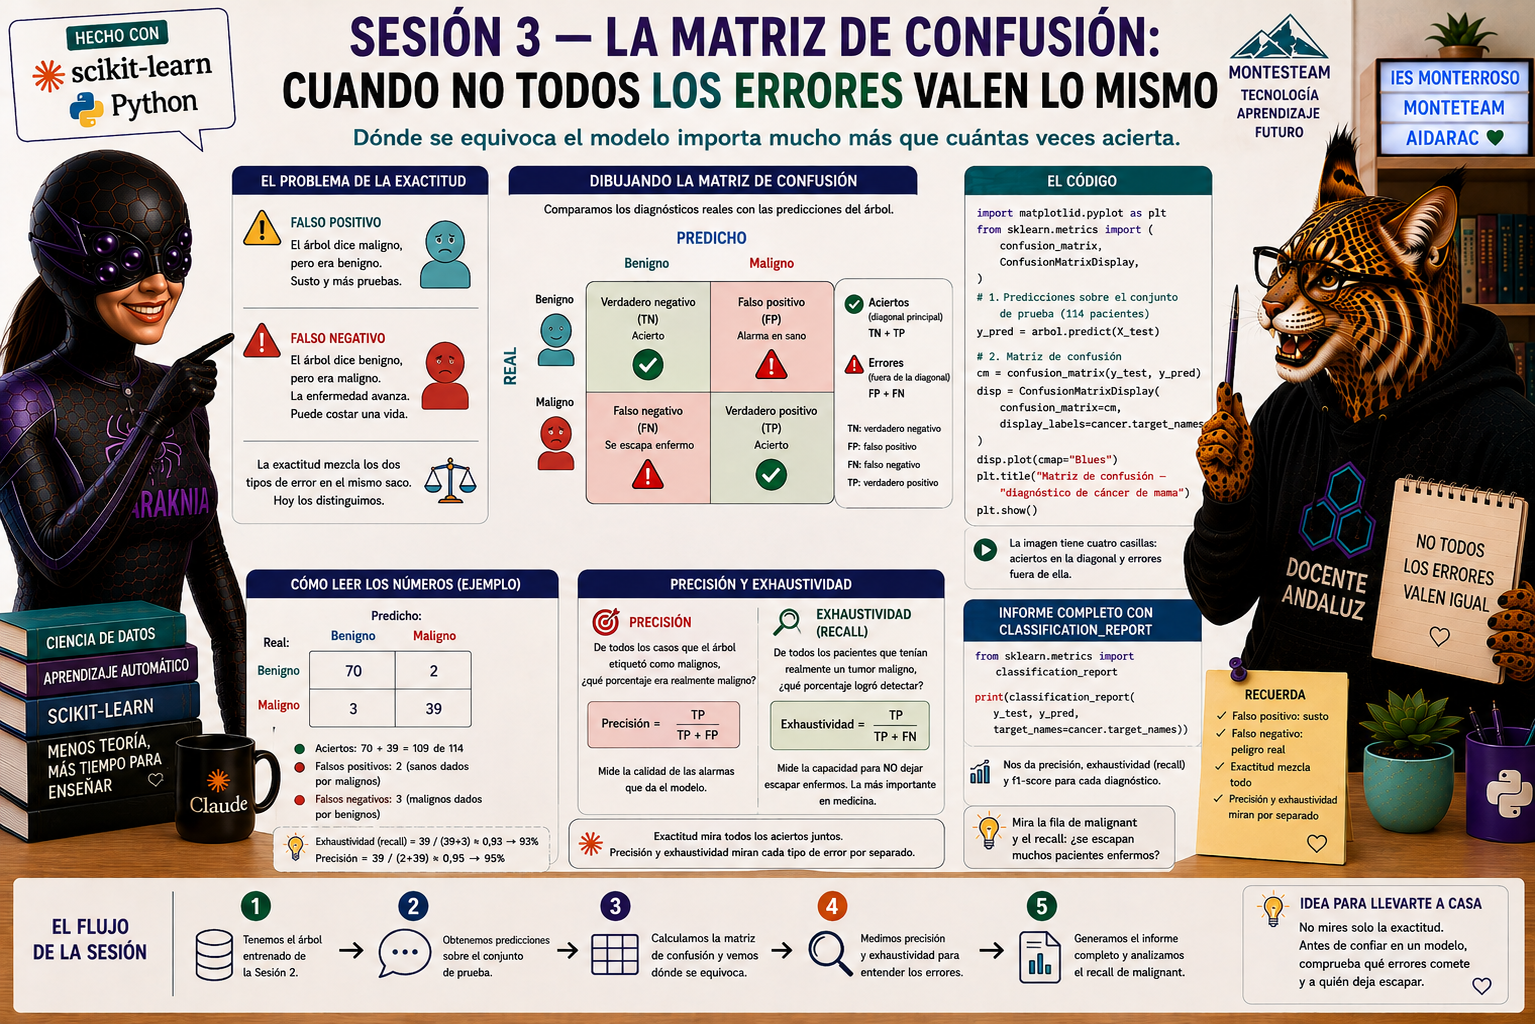
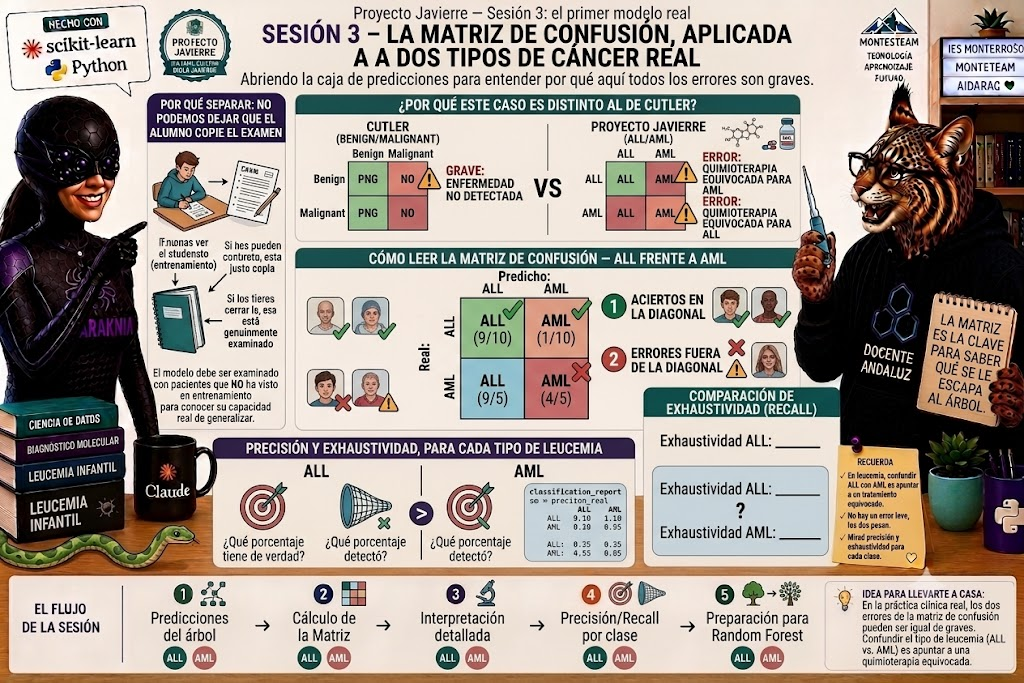
En la Sesion 3 del Proyecto Javierre, el alumnado calcula la matriz de confusion de su arbol de decision sobre ALL y AML, descubriendo que aqui los dos tipos de error pesan igual porque ambas clases son leucemias reales que se tratan de forma distinta.
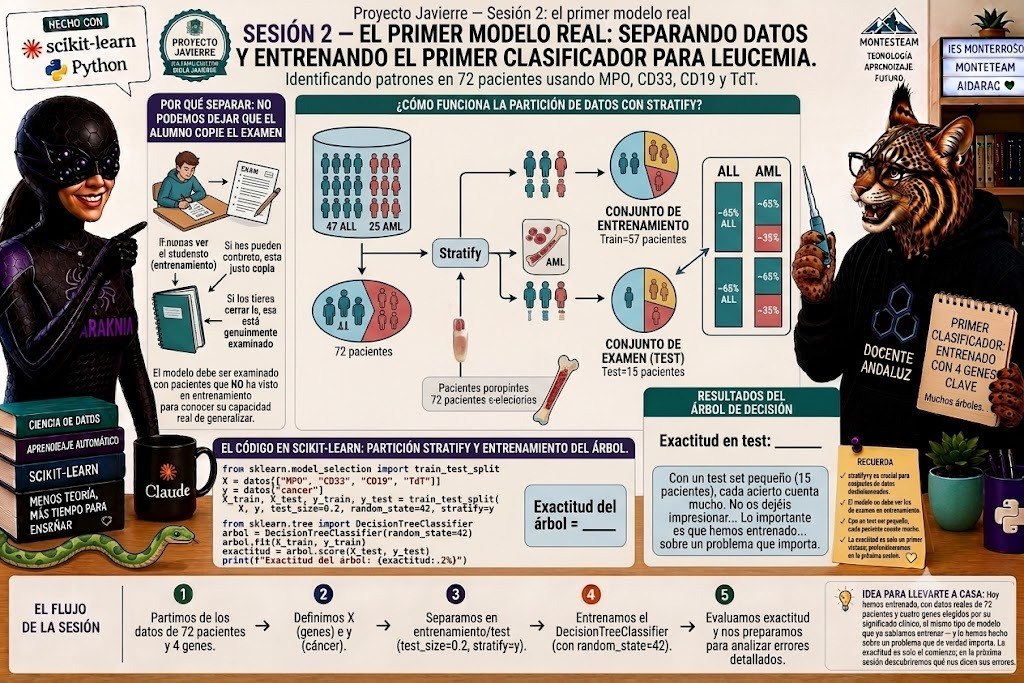
En la Sesion 2 del Proyecto Javierre, el alumnado separa los 72 pacientes en entrenamiento y examen con stratify, y entrena su primer arbol de decision real sobre los cuatro genes seleccionados para distinguir leucemia linfoblastica aguda de leucemia mieloide aguda.
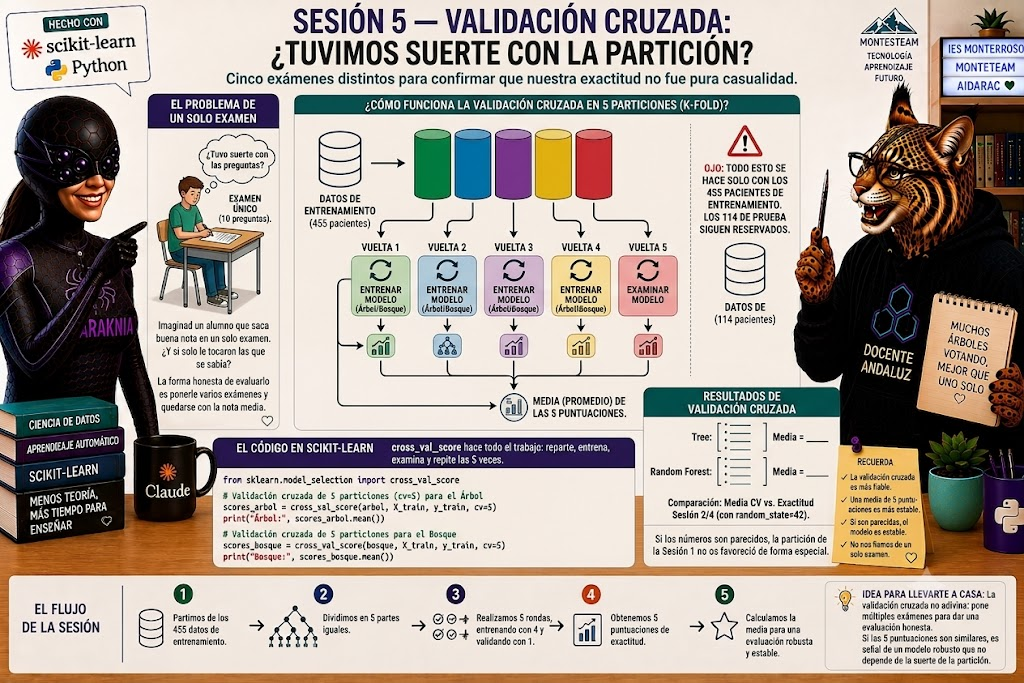
En la Sesión 5, la última del taller CUTLER, el alumnado usa validación cruzada con scikit-learn para comprobar si la exactitud de sus modelos dependía de la suerte de una única partición de datos, cerrando el recorrido del taller.
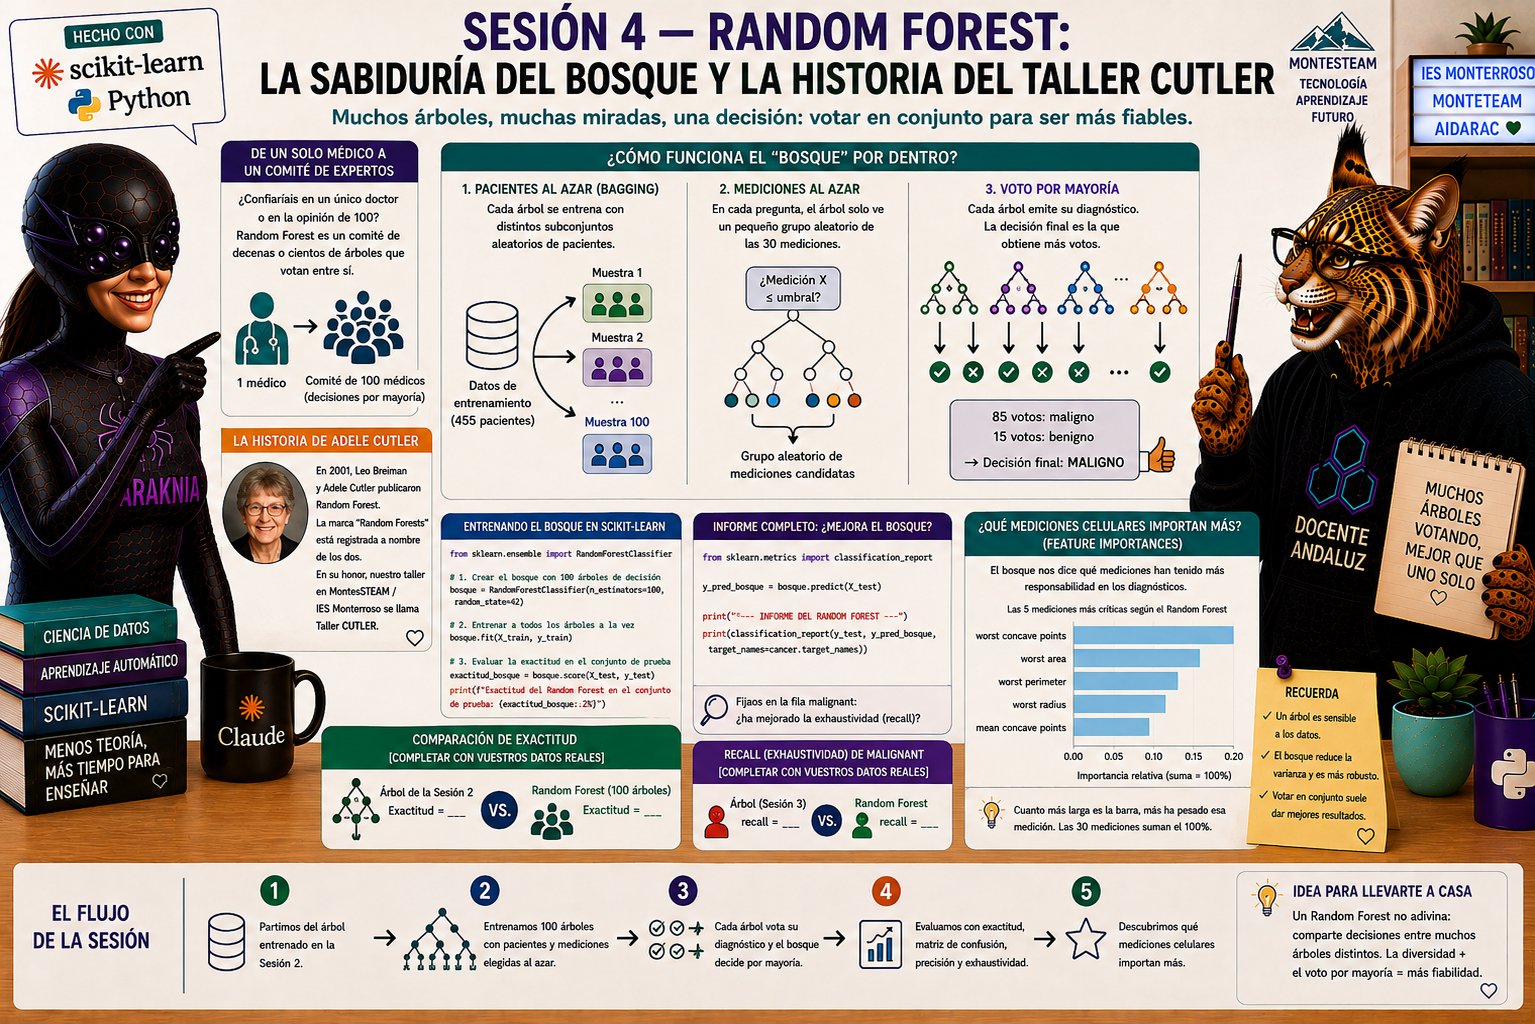
Sesión 4 del taller CUTLER, el alumnado entrena su primer Random Forest (bosque aleatorio) con scikit-learn. Descubrimos la historia de Adele Cutler, la sabiduría del voto por mayoría y qué mediciones celulares son más críticas en la detección del cáncer.
Seguimos en nuestro cuaderno. En la Sesión 2 entrenamos nuestro primer árbol de decisión y calculamos su exactitud en el conjunto de prueba. Nos dio un porcentaje bastante alto pero, ¿es suficiente un solo número para confiar en un diagnóstico …
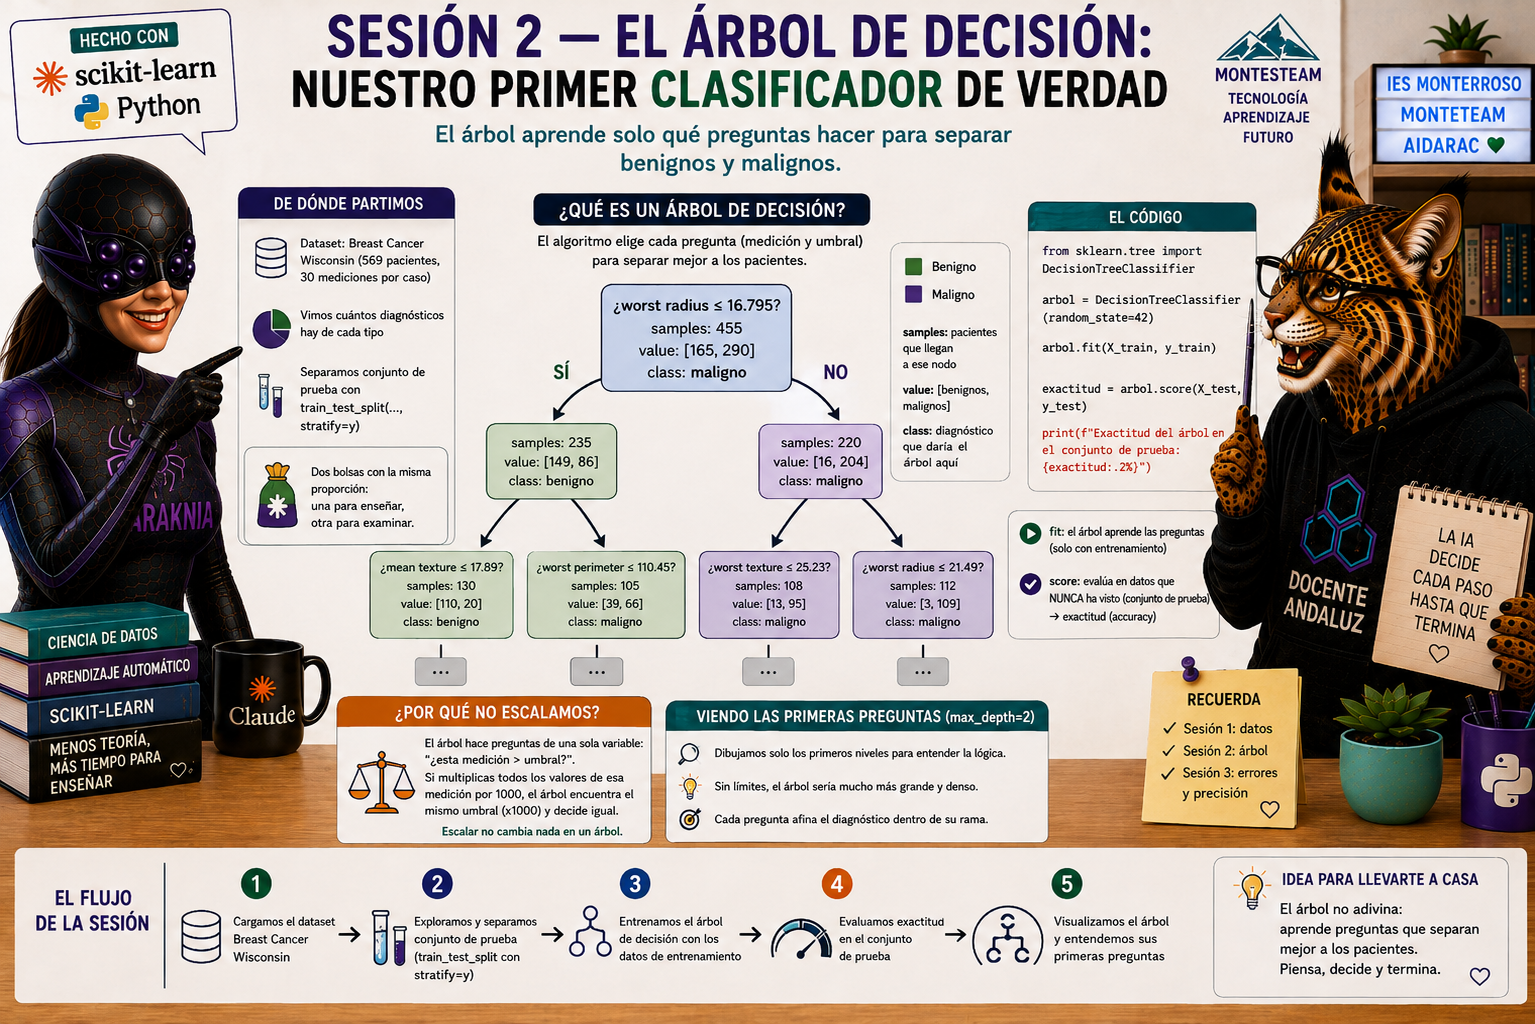
En la Sesión 2 del taller CUTLER, el alumnado entrena su primer clasificador real — un árbol de decisión con scikit-learn — sobre datos médicos reales, sin escalar variables y midiendo su exactitud.
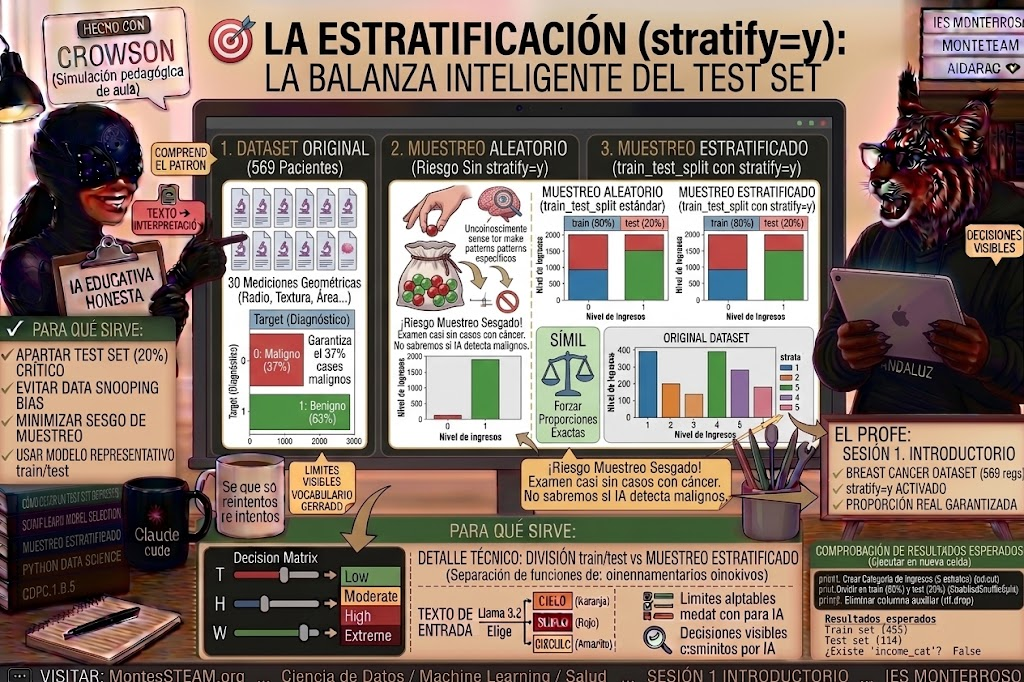
En este tutorial introductorio de Ciencia de Datos para MontesSTEAM e IES Monterroso, damos los primeros pasos en Machine Learning aplicado a la salud mediante el dataset real Breast Cancer Wisconsin. Aprende a instalar scikit-learn en JupyterLab, cargar datos médicos en memoria, reservar un conjunto de prueba para evaluar el modelo y comprender la importancia de la estratificación (stratify=y) para garantizar un reparto equilibrado entre tumores benignos y malignos.