Análisis de hábitos y síntomas de cáncer de pulmón con Árboles de Decisión en Python directamente en Kaggle Notebooks para 1º de Bachillerato.
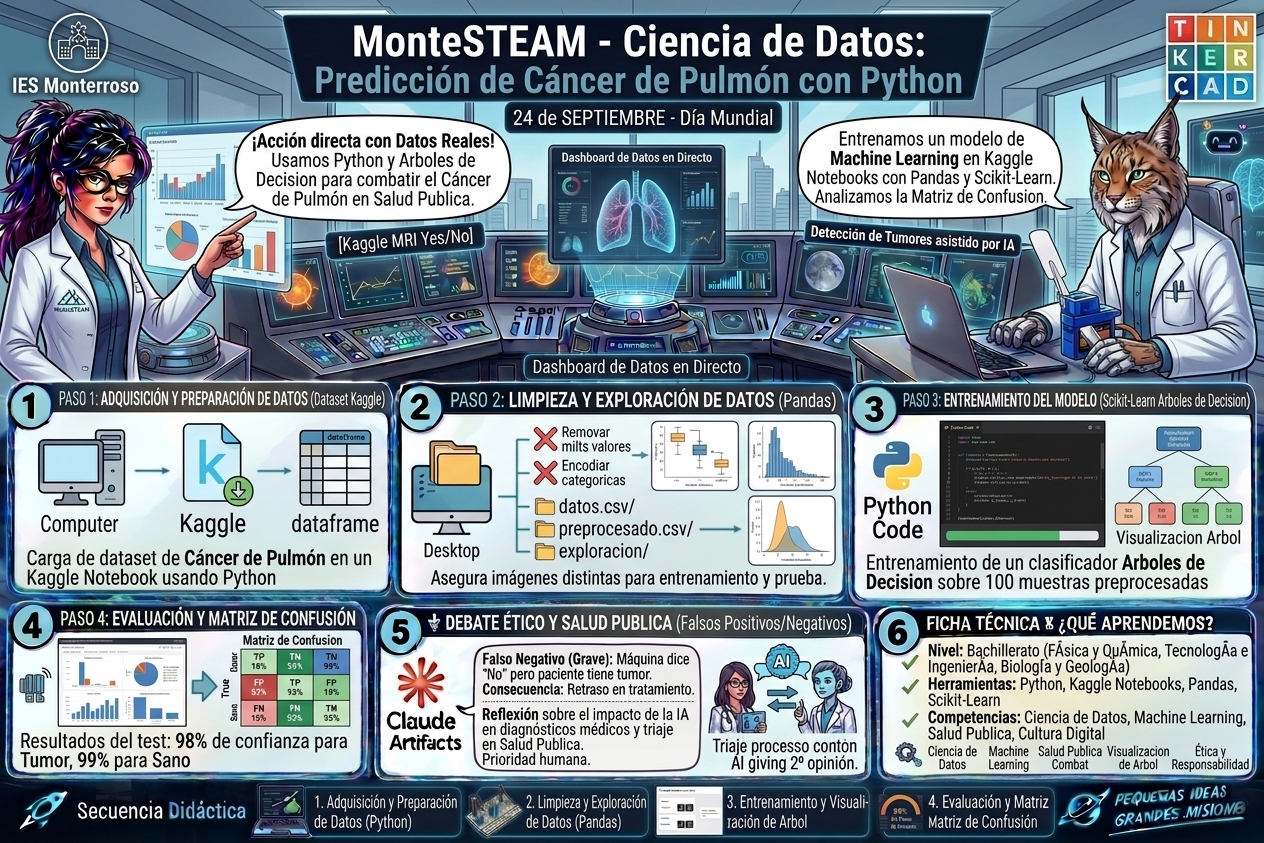

Análisis de hábitos y síntomas de cáncer de pulmón con Árboles de Decisión en Python directamente en Kaggle Notebooks para 1º de Bachillerato.
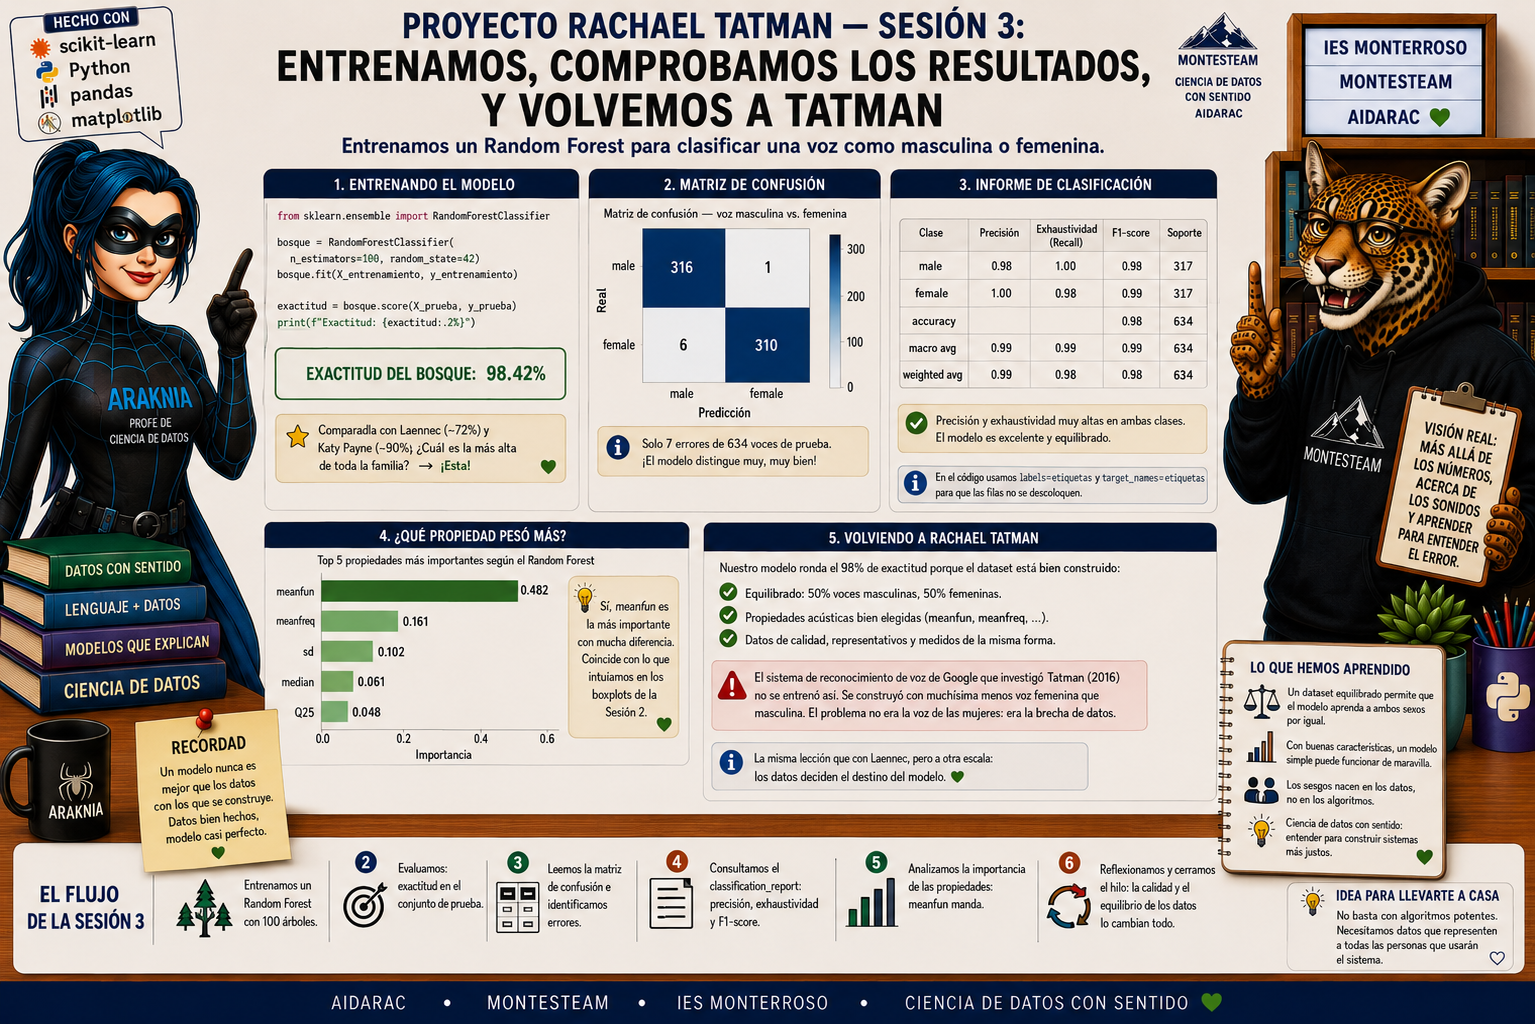
Sesion final del Proyecto Rachael Tatman: se entrena un Random Forest sobre las propiedades acusticas del dataset Gender Recognition by Voice, se leen la matriz de confusion y el classification_report, y se conecta el excelente resultado obtenido con la historia real de sesgo de genero en el reconocimiento de voz de Google que investigo Rachael Tatman en 2016.
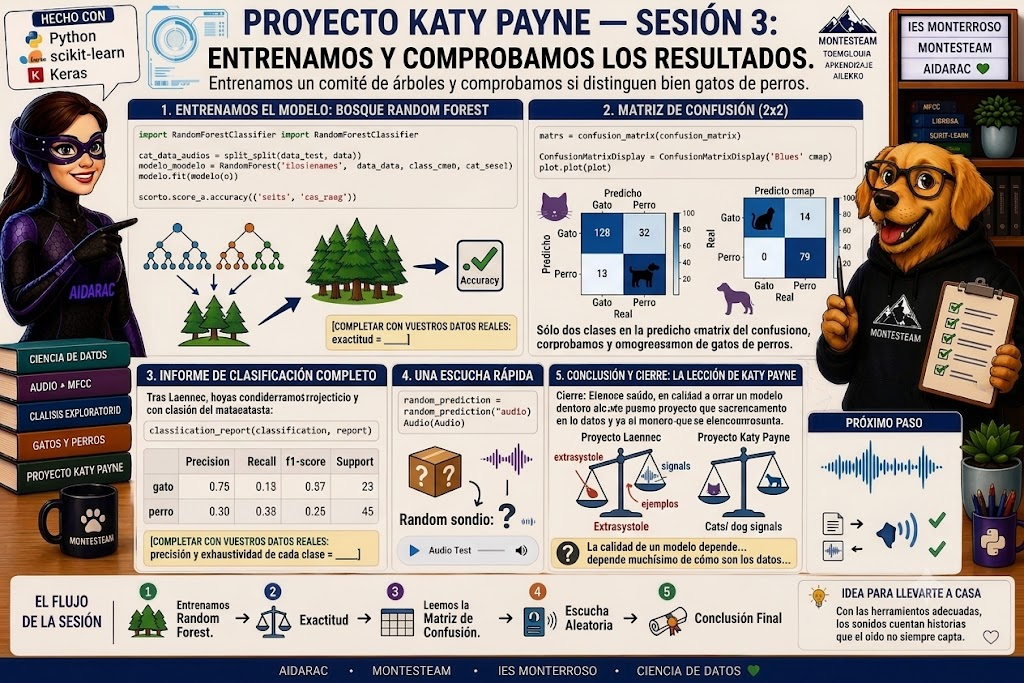
Sesion final del Proyecto Katy Payne: se entrena un Random Forest sobre los MFCC de gatos y perros, se lee la matriz de confusion 2×2 y el classification_report, y se comparan los resultados con los del Proyecto Laennec para mostrar como el desequilibrio y el numero de clases afectan al rendimiento de un modelo.
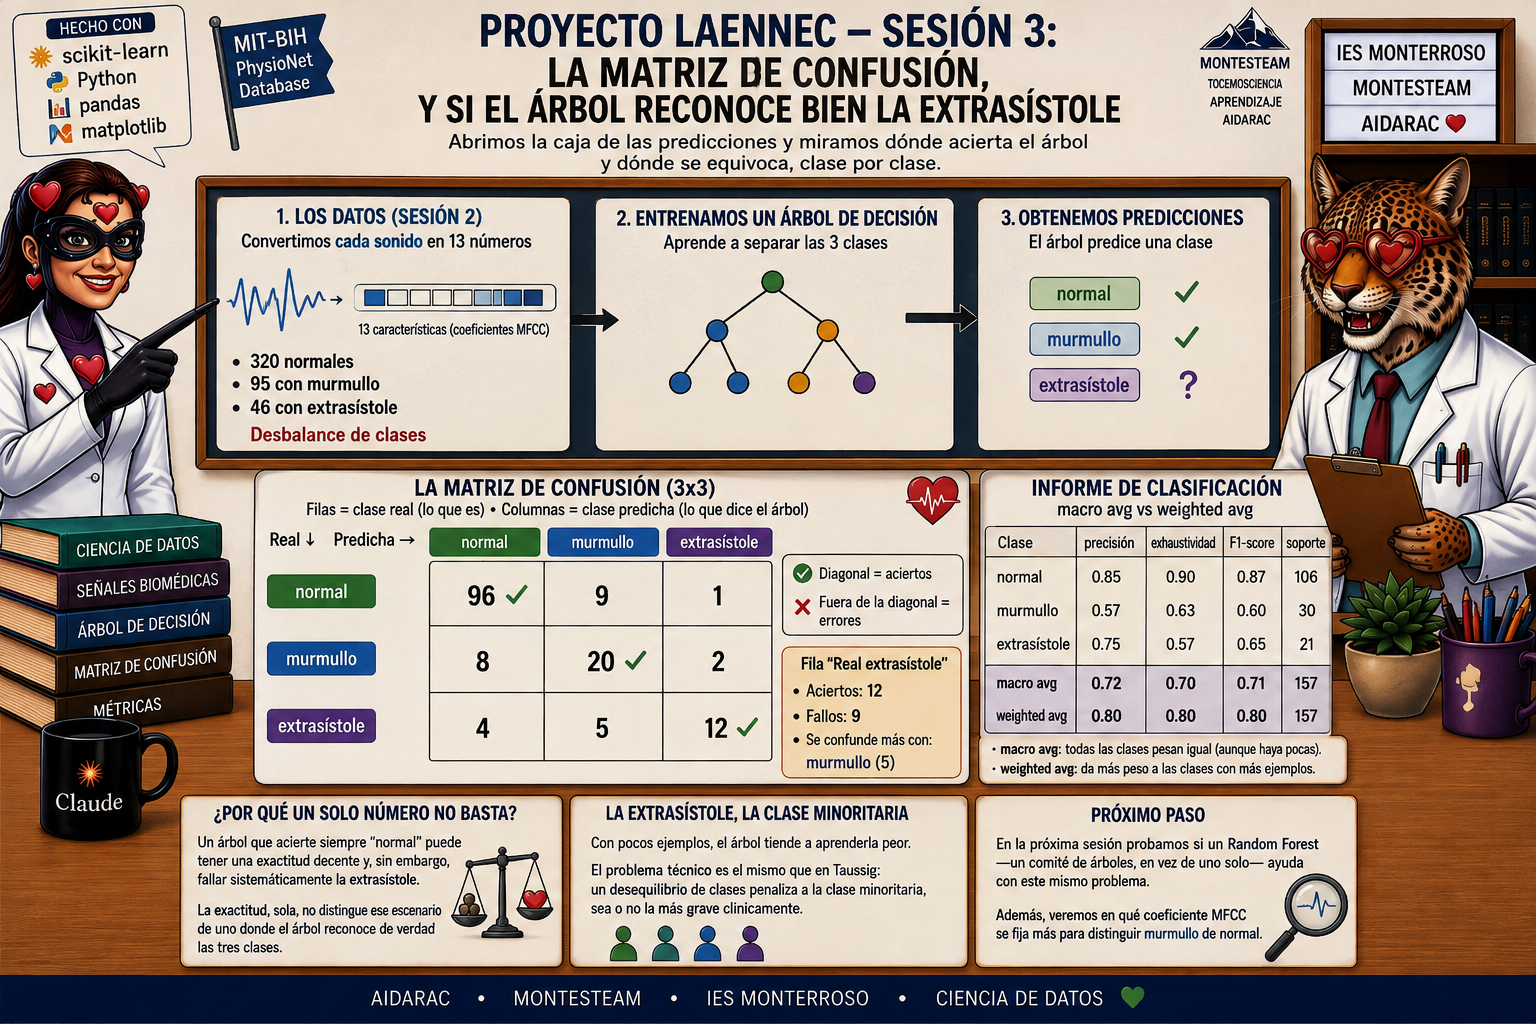
En la Sesion 3 del Proyecto Laennec, el alumnado calcula una matriz de confusion 3×3 sobre los sonidos del corazon (normal, murmullo, extrasistole), retoma macro avg frente a weighted avg y comprueba si el arbol de decision reconoce bien la clase minoritaria, la extrasistole.
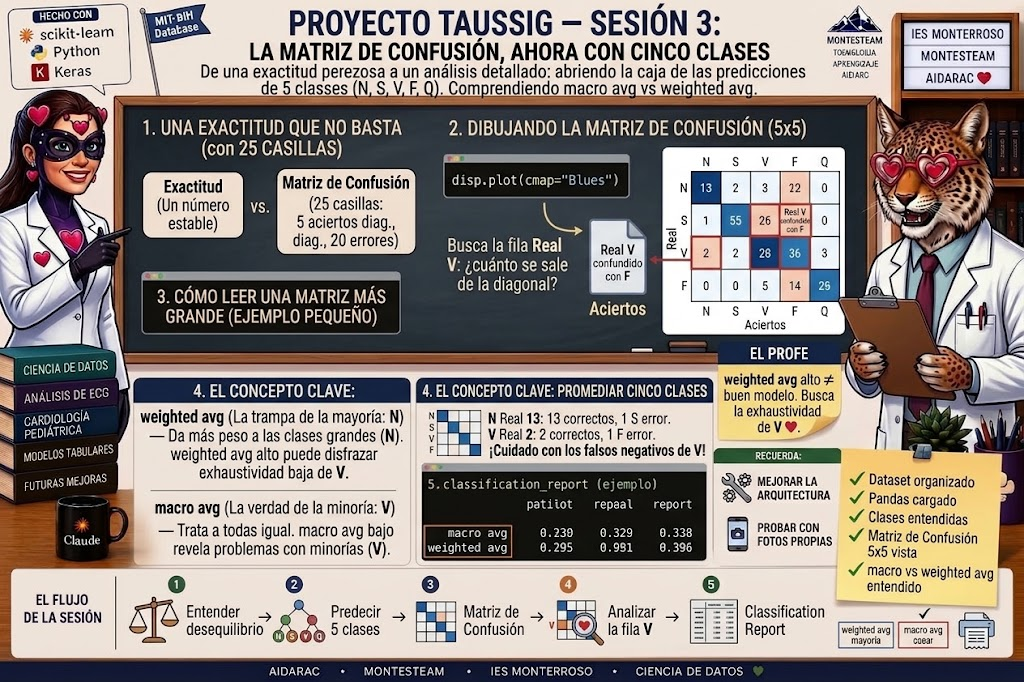
En la Sesion 3 del Proyecto Taussig, el alumnado calcula una matriz de confusion de 5×5 sobre los latidos de ECG, descubre la diferencia entre macro avg y weighted avg en classification_report, y comprueba si el arbol reconoce bien la arritmia ventricular pese al fuerte desequilibrio de clases.
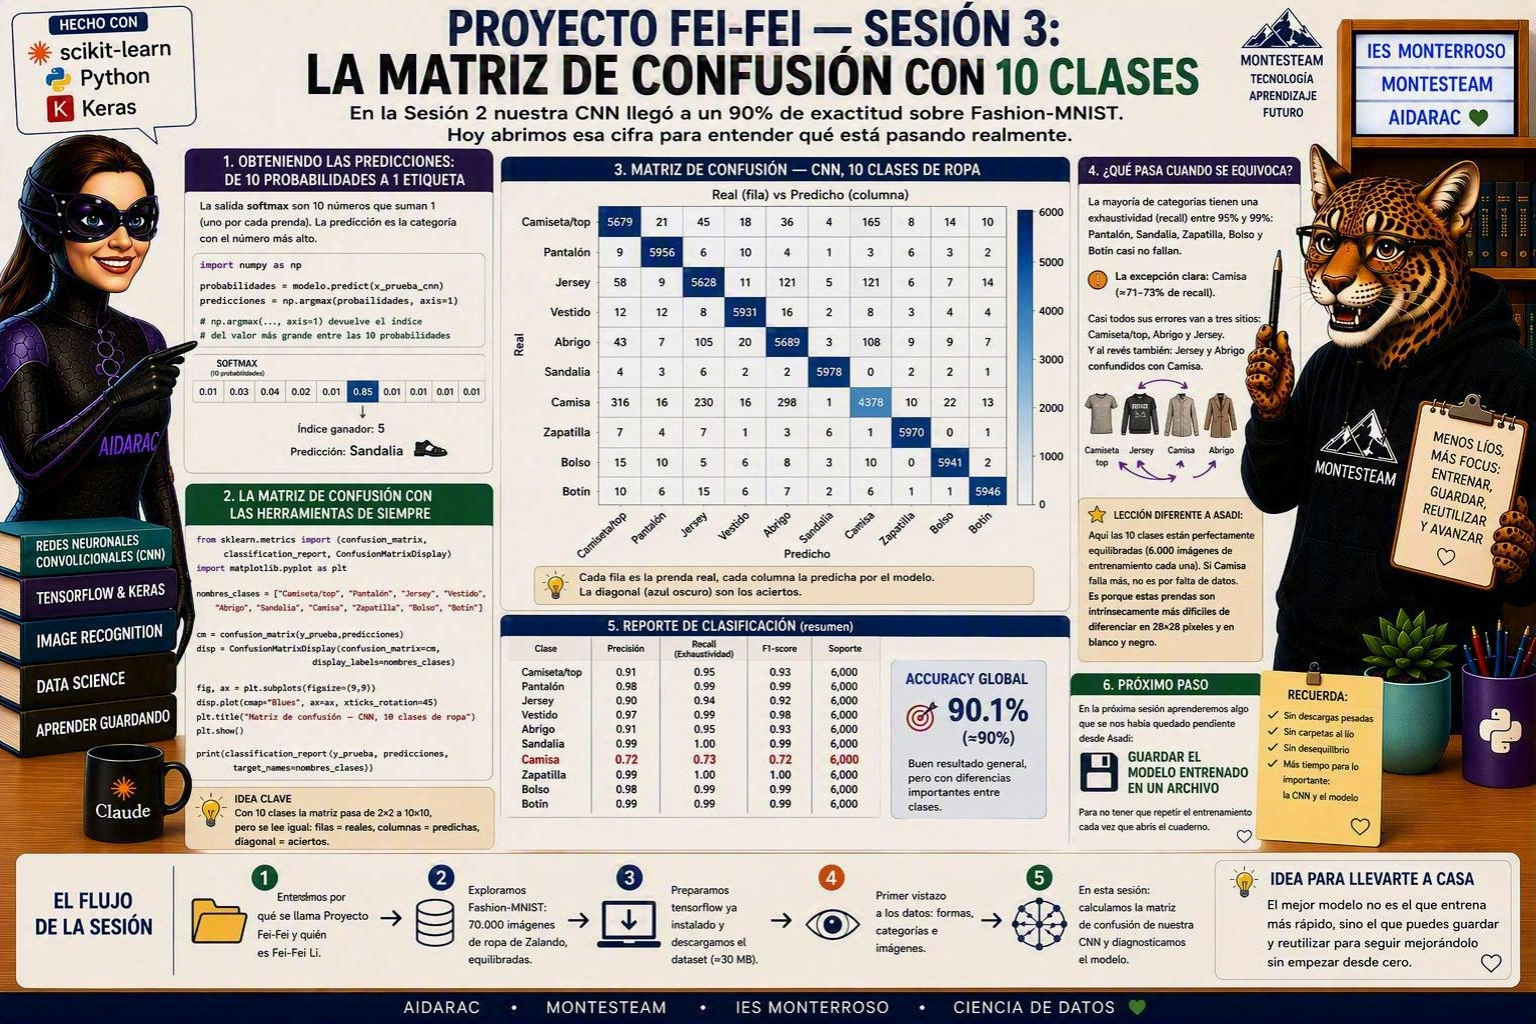
En la Sesion 3 del Proyecto Fei-Fei, el alumnado calcula la matriz de confusion de su CNN sobre las 10 categorias de Fashion-MNIST y descubre que Camisa es la prenda mas dificil de reconocer, confundida con Camiseta, Jersey y Abrigo pese a que las clases estan perfectamente equilibradas.
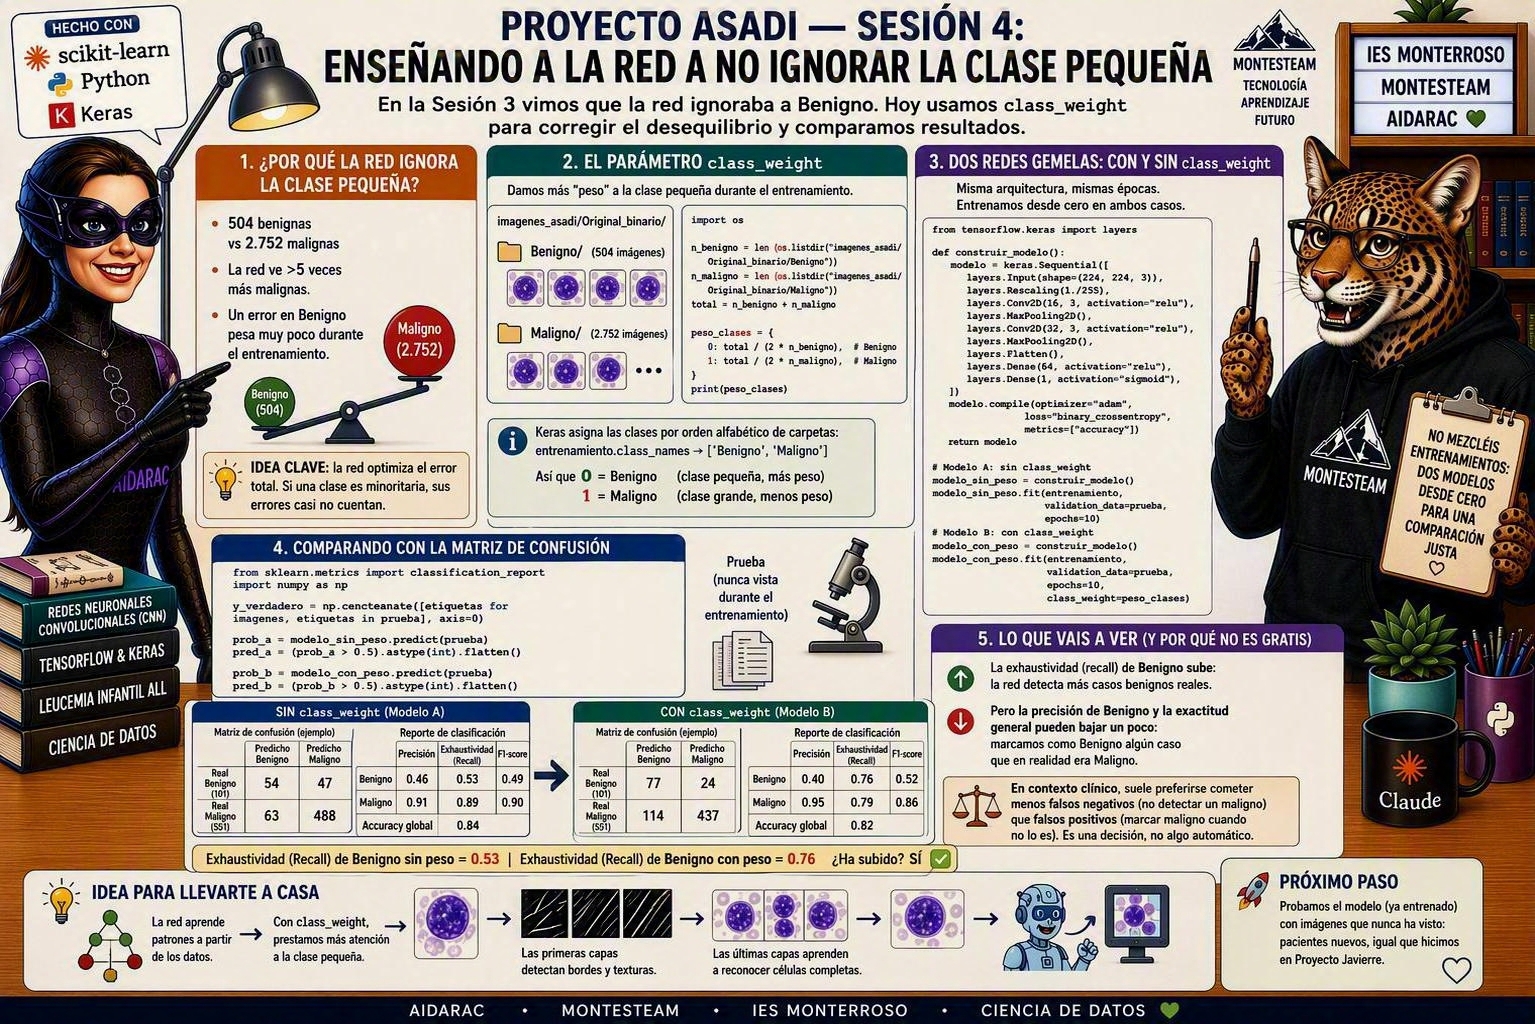
En la Sesion 4 del Proyecto Asadi, el alumnado usa el parametro class_weight de Keras para corregir el efecto del desequilibrio entre benignos y malignos detectado en la Sesion 3, y compara la matriz de confusion antes y despues.
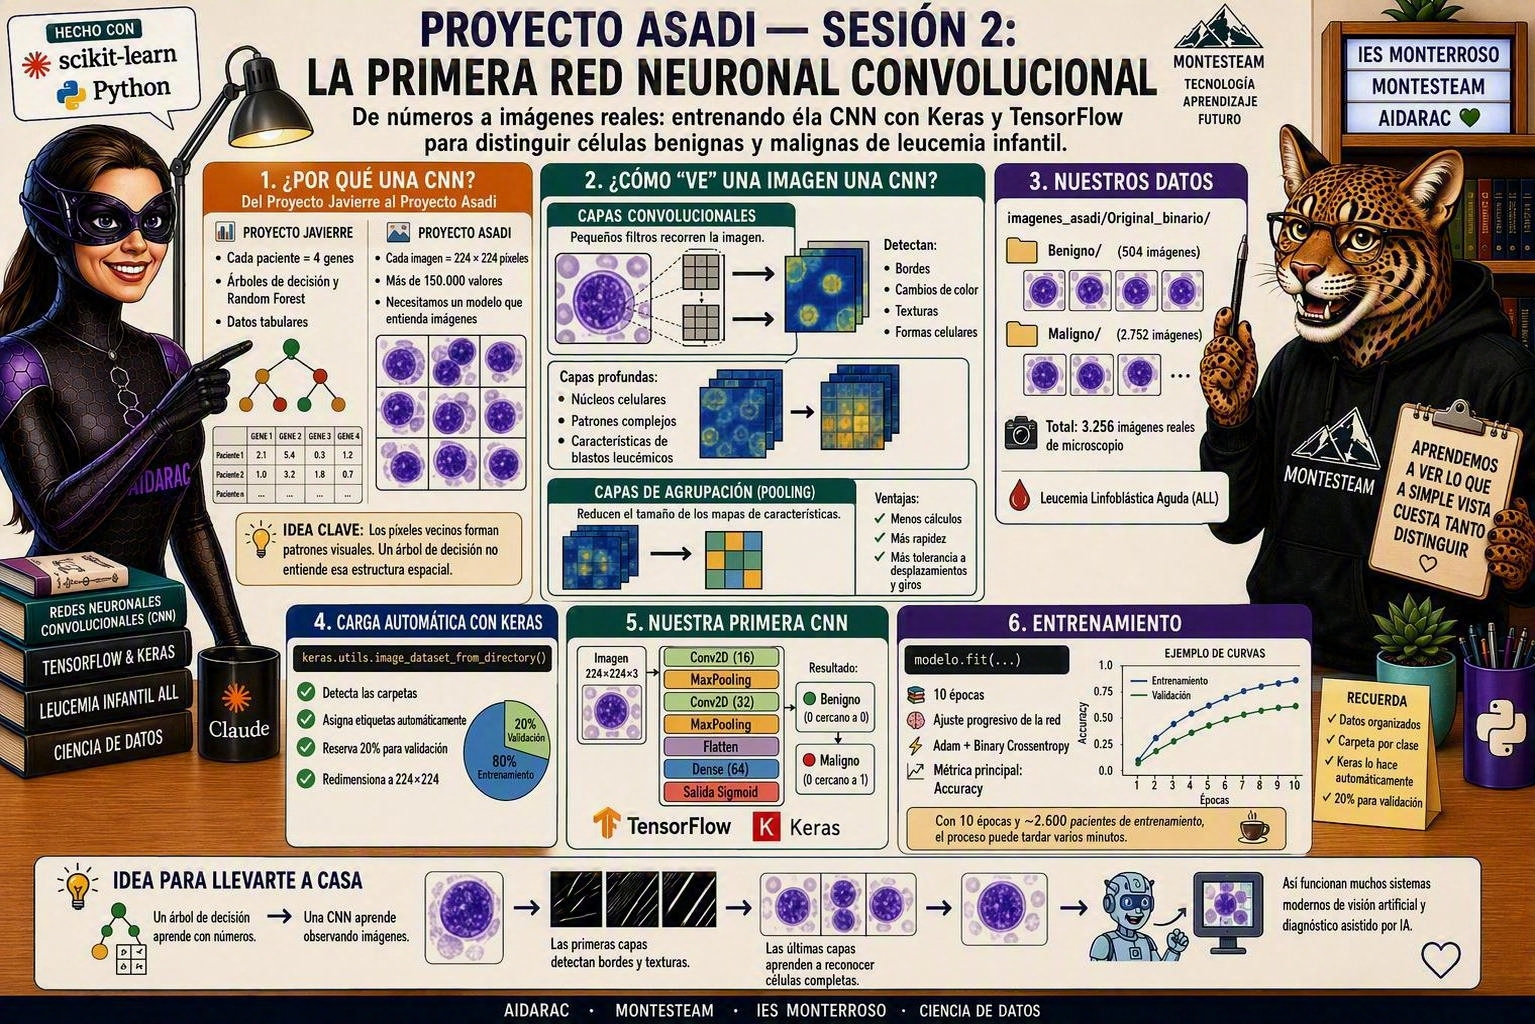
En la Sesion 3 del Proyecto Asadi, el alumnado calcula la matriz de confusion de su CNN sobre benigno/maligno y descubre por que el fuerte desequilibrio entre clases (504 benignas frente a 2752 malignas) puede sesgar los resultados.
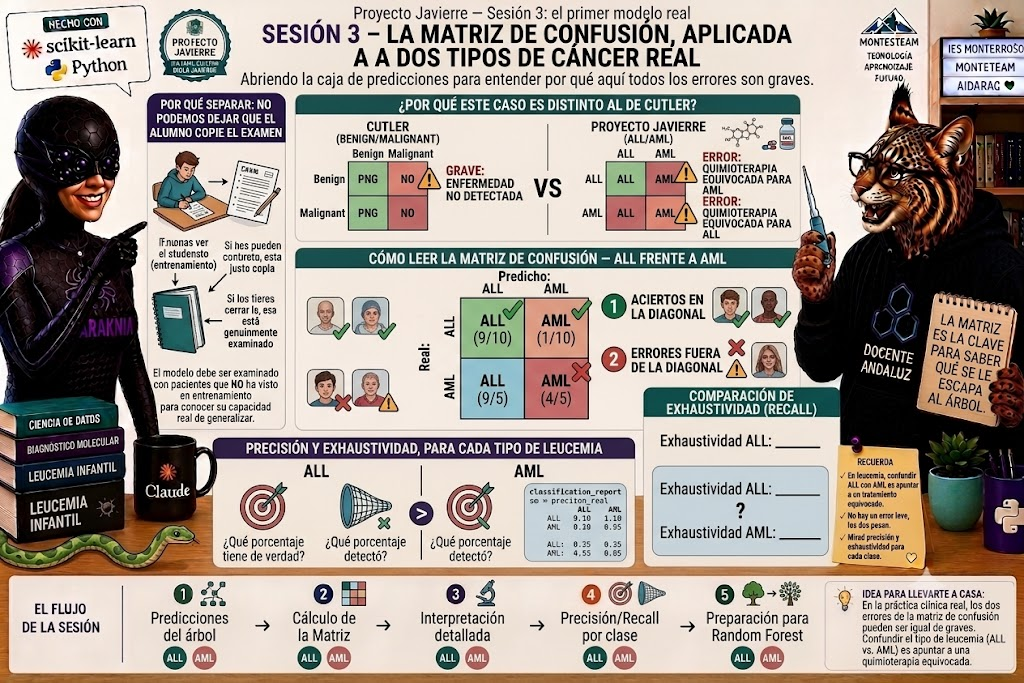
En la Sesion 3 del Proyecto Javierre, el alumnado calcula la matriz de confusion de su arbol de decision sobre ALL y AML, descubriendo que aqui los dos tipos de error pesan igual porque ambas clases son leucemias reales que se tratan de forma distinta.
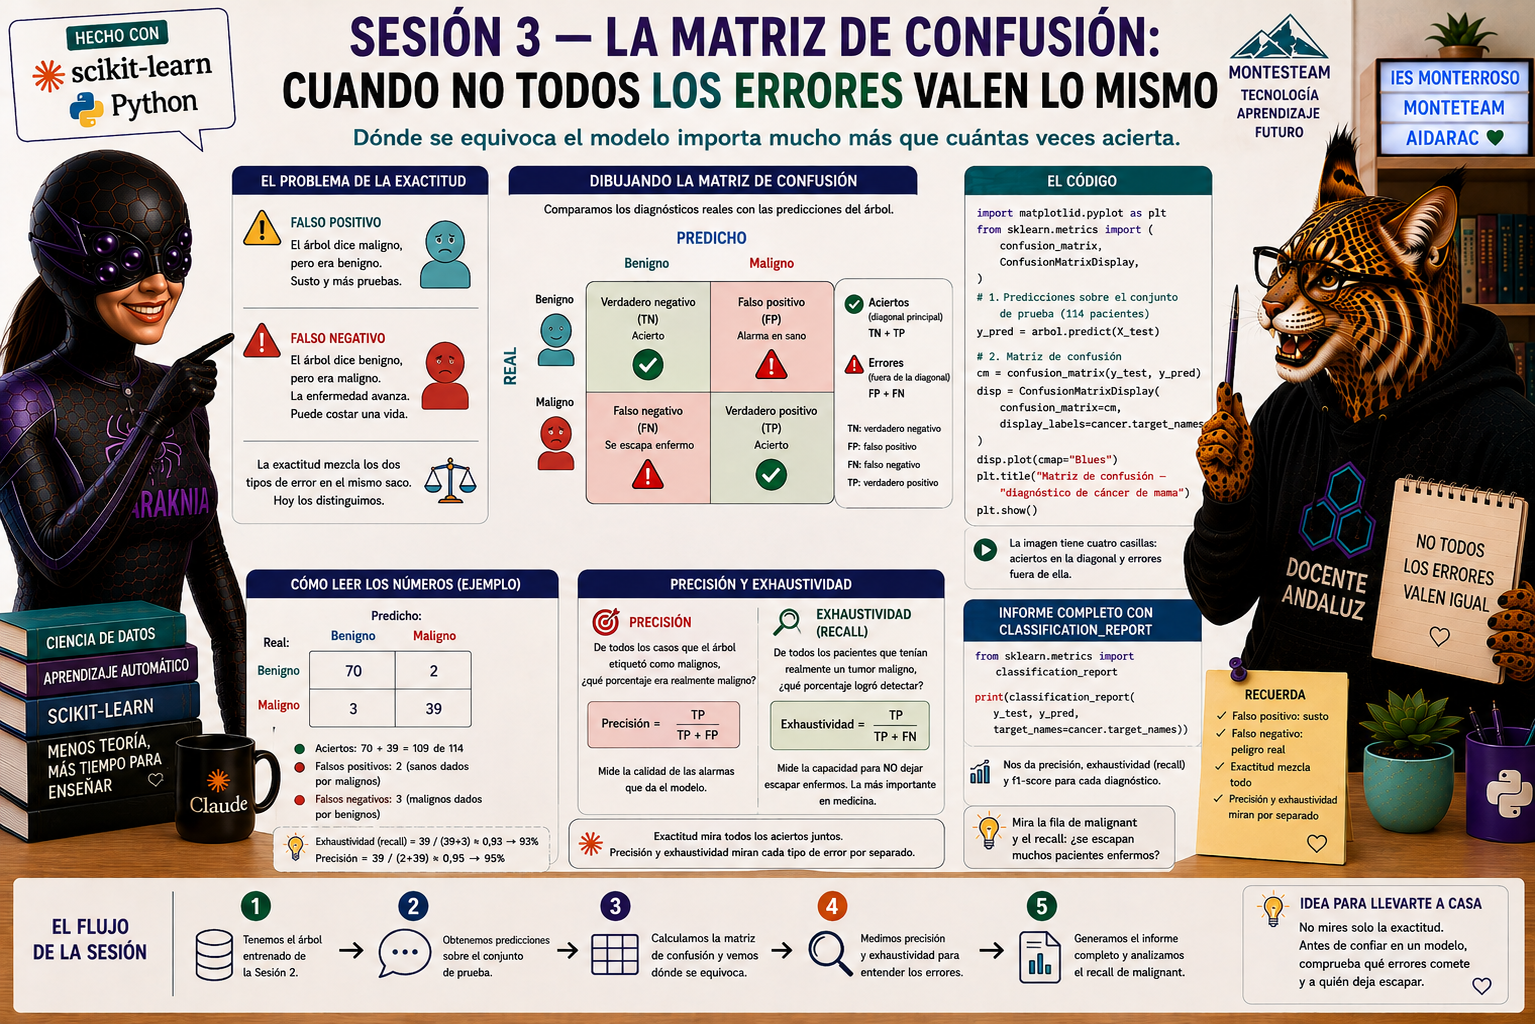
Seguimos en nuestro cuaderno. En la Sesión 2 entrenamos nuestro primer árbol de decisión y calculamos su exactitud en el conjunto de prueba. Nos dio un porcentaje bastante alto pero, ¿es suficiente un solo número para confiar en un diagnóstico …