Chismes del Lince 18b: El detector de obstáculos del Lince (parte 2), una webapp que usa tu modelo sin enviar la foto a ningún sitio
Slug: chismes-del-lince-18b-el-detector-de-obstaculos-del-lince-parte-2-webapp-con-el-modelo-de-teachable-machine
Extracto SEO: Una webapp que carga un modelo de Teachable Machine desde tu propia carpeta, analiza una foto en el móvil y dice si hay obstáculos, sin enviar nada a la nube.
Etiquetas (WordPress): AIDARAC, Chismes del Lince, ia, inteligencia artificial, teachable machine, tensorflow, obstáculos, parkinson, persona mayor, web app, ies monterroso, montesteam
El calcetín del Lince
Noche cerrada en la cueva del Lince. La Gata Montesa ha dejado el folio en el suelo del pasillo y, encima, un calcetín.
—Yo no necesito gafas para esto —dice el Lince, muy digno—. Veo perfectamente.
—Claro. Pero esta noche vas a probar el detector. Hazle una foto al pasillo.
El Lince apunta el móvil. Pi. La pantalla se pone roja, vibra y una voz dice: «Cuidado. Hay algo en medio del camino.»
—¡Qué listo es el móvil! —dice el Lince.
—Ahora quita el calcetín y hazle otra foto, pero con poca luz y desde un ángulo raro.
El Lince lo hace. Pi. La pantalla se pone naranja: «No estoy segura. Mire usted con cuidado.»
—¿Y ahora qué le pasa? —protesta el Lince.
—Que es honrado —contesta la Gata—. Dice lo que sabe y avisa cuando no lo sabe. Un detector que siempre contesta con seguridad es mucho más peligroso que uno que duda.
Introducción
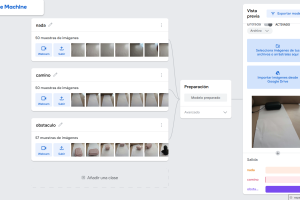
En la parte 1 (Chisme 18a) entrenamos con Teachable Machine un modelo que distingue tres cosas: nada, camino y obstaculo, y lo exportamos como tres archivos: model.json, weights.bin y metadata.json.
Ahora ponemos ese modelo a trabajar. La webapp hace esto:
- La persona pulsa Hacer foto (o elige una que ya tiene).
- La página recorta el centro de la foto y se lo da al modelo.
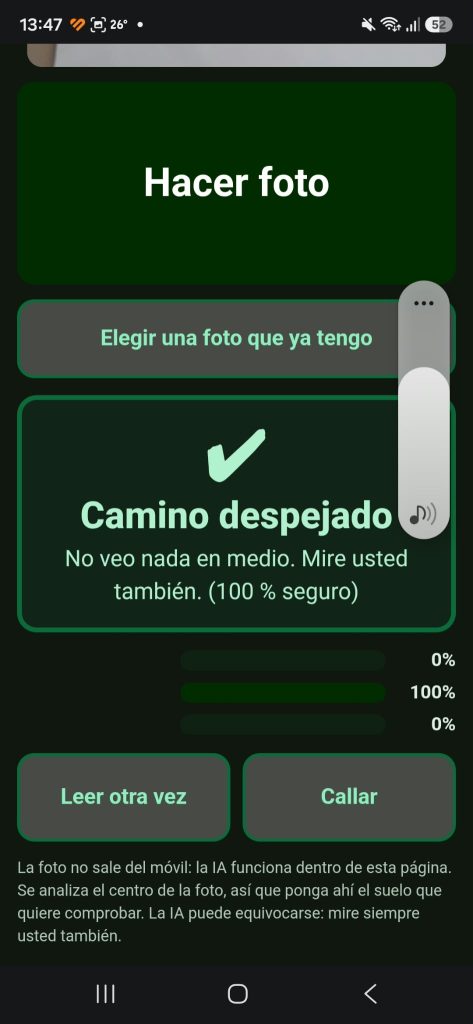
- El modelo devuelve tres porcentajes, uno por clase.
- La página muestra el resultado en grande, con color y con icono, y lo lee en voz alta.
- Si el modelo no está suficientemente seguro, no afirma nada: dice que no está segura.
Y lo más importante de este chisme: la foto no sale del móvil. No hay Worker, ni clave de API, ni Gemini. El modelo está en tu carpeta y funciona dentro de la propia página.
Las reglas de diseño son las de los chismes anteriores:
- Nada de teclear. Dos botones grandes: hacer foto y elegir una que ya tengo.
- Letra grande, y lo mismo que se oye aparece escrito.
- El color nunca va solo: cada estado tiene también un icono y un texto distinto.
- Ante la duda, no se afirma nada.
⚠️ Esto es una prueba técnica, no una ayuda para caminar
Un modelo entrenado con 150 fotos de un sofá no es un sistema de seguridad. No lo uses para guiar a una persona ni para decidir si un camino es seguro. Es un ejercicio para entender cómo aprende una IA y cómo se pone a trabajar en una página web.
La IA puede equivocarse con total seguridad, sobre todo con objetos, fondos o luces que no ha visto al entrenar. Una persona debe mirar siempre por sí misma.
No fotografíes personas. Prueba con objetos y suelos de ejemplo.
Qué cambia respecto a los chismes anteriores
| Ojo del Lince (06) | Explícame este papel (09) | Detector de obstáculos (18b) | |
|---|---|---|---|
| Dónde está la IA | En la nube (Gemini) | En la nube (Gemini) | En el propio móvil, dentro de la página |
| Worker de Cloudflare | Sí | Sí | No hace falta |
| Clave de API | Sí (secreto en el Worker) | Sí (secreto en el Worker) | No hay |
| La foto sale del móvil | Sí | Sí | No |
| Quién ha aprendido | Un modelo general de Google | Un modelo general de Google | Nuestro modelo, con nuestras 150 fotos |
| Qué responde | Texto libre | Texto con estructura fija | Una de tres clases, con porcentaje |
| Límite de uso | Cuota de Gemini | Cuota de Gemini | Ninguno: no hay peticiones a ningún servicio |
| Cuando no está seguro | Se lo inventa con soltura | Se lo inventa con soltura | Lo dice (umbral del 80 %) |
Cómo funciona por dentro
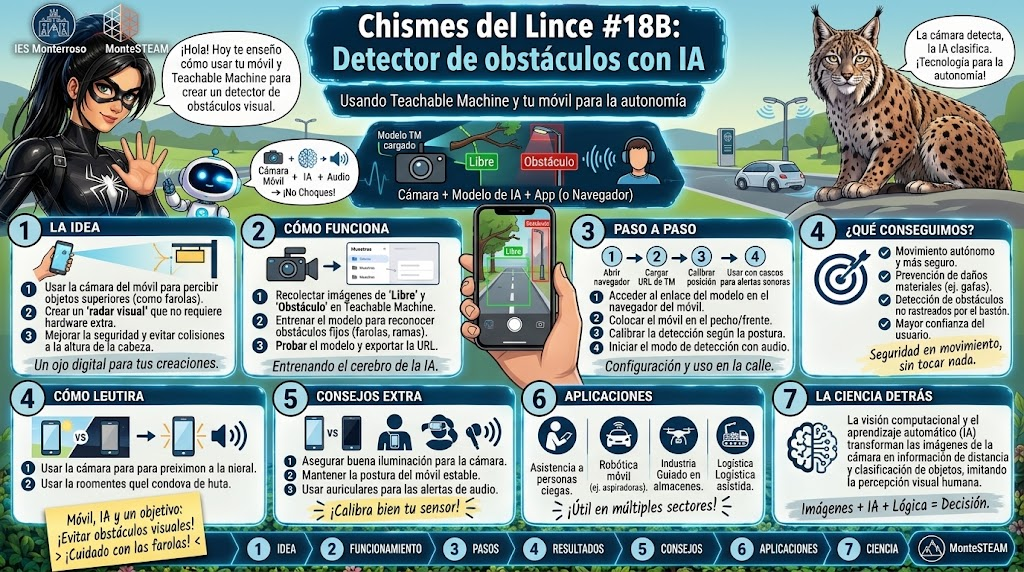
El recorrido completo es este:
Móvil (foto) → recorte cuadrado del centro → modelo en la página → tres porcentajes → pantalla + voz
- La persona pulsa Hacer foto. En el móvil se abre la cámara trasera (
capture="environment"). - La página dibuja el centro cuadrado de la foto en un
canvas. Lo que se ve en pantalla es exactamente lo que analiza la IA. - El modelo (
tmImage) recibe esecanvasy devuelve una probabilidad por clase. - La página escoge la clase con más probabilidad, si supera el umbral.
- Muestra el resultado, lee la frase en voz alta (
speechSynthesis) y, si hay obstáculo, hace vibrar el móvil (en Android).
Las dos librerías que usa (TensorFlow.js y Teachable Machine) se cargan desde internet la primera vez. La foto y el modelo nunca viajan: solo se descargan esas librerías.
Las cinco ideas que hay que entender
1. El modelo vive en la misma carpeta que la página
Los cuatro archivos van juntos, en la misma carpeta de tu servidor:
chisme18b-obstaculos.html
model.json
weights.bin
metadata.json
La página los llama por su nombre y de forma relativa (model.json, metadata.json). No les cambies el nombre: model.json busca weights.bin por ese nombre exacto.
2. Lo que ve la IA es lo que ve usted
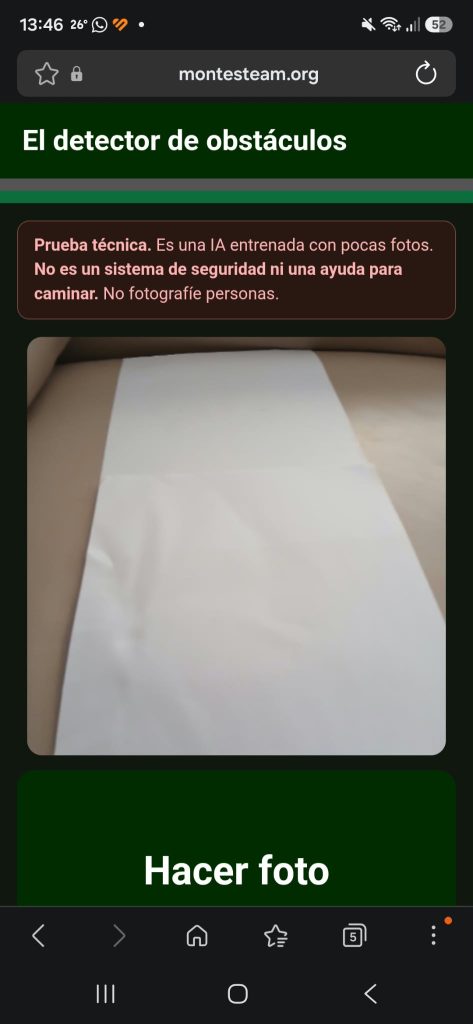
Los modelos de Teachable Machine trabajan con imágenes cuadradas pequeñas. Si le pasas una foto vertical de 3000 por 4000 píxeles, alguien tiene que decidir qué parte se queda. Aquí lo decidimos nosotros y lo enseñamos: la foto que aparece en pantalla es el recorte del centro que analiza el modelo.
Consecuencia práctica: un obstáculo en el borde de la foto no se ve. Hay que poner en el centro lo que se quiere comprobar.
3. La duda es una respuesta (y la más honesta)
El modelo siempre devuelve tres porcentajes que suman 100. Nunca dice «no lo sé». Tenemos que enseñarle a decirlo nosotros:
const UMBRAL = 0.80;
Si la clase ganadora no llega al 80 %, la página muestra el estado «No estoy segura», sin afirmar ni «camino» ni «obstáculo». Es la respuesta a la pregunta con la que cerramos el 18a: ¿qué hace el Lince cuando el modelo duda? Avisa de que duda.
El error más peligroso de un detector de obstáculos es decir «camino despejado» cuando no lo está. Por eso el umbral importa: sube el umbral y habrá más dudas pero menos aciertos falsos; bájalo y la página parecerá más segura de lo que es.
4. Cuatro estados, y ninguno depende solo del color
| Estado | Color | Icono | Qué dice |
|---|---|---|---|
camino | Verde | ✔ | «Camino despejado. Mire usted también.» |
obstaculo | Rojo | ⚠ | «¡Cuidado! Hay un obstáculo.» (y vibra) |
nada | Gris | ∅ | «No veo camino. Apunte al suelo.» |
| duda | Naranja | ? | «No estoy segura. Mire usted con cuidado.» |
Hay quien no distingue bien el rojo del verde, y hay momentos en que la pantalla no se ve bien. Por eso cada estado tiene también icono, texto y voz distintos. Todos los textos están en el objeto TEXTOS del script, para que los cambies sin tocar nada más.
5. Descargar los archivos sin caché y comprobarlos (lo que nos pasó a nosotros)
Al probarla nos salieron errores como este:
Based on the provided shape, [1,1,24,144], the tensor should have 3456 values but has 2007
Y en otro navegador:
byte length of Float32Array should be a multiple of 4
Lo que significan es que el modelo (model.json) y los pesos (weights.bin) no encajan entre sí: el primero describe una red con cierto número de valores y el segundo trae otros. Las causas habituales son tener model.json y weights.bin de exportaciones distintas (por ejemplo, si has entrenado dos veces), o que el navegador o el servidor sirvan una copia antigua de uno de ellos.
Lo solucionamos de dos formas:
- La página descarga los archivos sin usar la caché (
cache: 'no-store'). - Antes de cargar el modelo, calcula cuántos bytes debería pesar
weights.binsegúnmodel.jsony lo compara con lo que ha recibido. Si no coincide, lo dice con un mensaje claro en lugar de un error incomprensible.
Después de ese cambio, la página funcionó. No hemos podido confirmar cuál de las dos causas fue la nuestra, pero la comprobación es útil en ambos casos. Es una buena lección de ingeniería: un mensaje de error que explica lo que pasa ahorra mucho tiempo.
Paso 1: prepara los archivos
Del ZIP que descargaste en el 18a, necesitas los tres archivos del modelo: model.json, weights.bin y metadata.json. Usa siempre los tres de la misma exportación. Si has exportado más de una vez, quédate con la última y borra los demás.
Paso 2: guarda el HTML
Copia el código de la sección HTML (al final de esta entrada) y guárdalo como chisme18b-obstaculos.html. No hay que cambiar ninguna dirección: no hay Worker.
Si tus clases se llaman distinto de nada, camino y obstaculo, ajusta las claves del objeto TEXTOS y de NOMBRES.
Paso 3: súbelo todo junto
Sube los cuatro archivos a la misma carpeta (por ejemplo, app) con el gestor de archivos de tu hosting. Comprueba que weights.bin pesa lo mismo que el original (unos 2 MB).
Paso 4: ábrela en su propia dirección
En el móvil, abre la página directamente en su dirección:
https://montesteam.org/app/chisme18b-obstaculos.html
Tiene que ser https para que la cámara funcione. Si la incrustas en una entrada de WordPress (un iframe), la cámara puede fallar: enlázala a su propia dirección.
Cuando todo va bien, la tarjeta pasa de «Cargando la IA» a «Lista».
Paso 5: pruébala con método
Repite lo que hicimos en el 18a, ahora en la página:
- Las 15 fotos de prueba (5 por clase) que no usaste para entrenar. Apunta cuántas acierta.
- Un objeto nuevo sobre el folio.
- Un obstáculo muy pequeño (una goma, un clip).
- El obstáculo en el borde de la foto, y luego en el centro.
- Poca luz y desde otro ángulo.
- Un sitio distinto del sofá, como el suelo de otra habitación.
| Prueba | ¿Qué esperas? | ¿Qué dice? | Porcentaje |
|---|---|---|---|
| Folio vacío | camino | ||
| Folio con objeto nuevo | obstáculo | ||
| Obstáculo pequeño | obstáculo | ||
| Obstáculo en el borde | obstáculo | ||
| Poca luz | duda | ||
| Otro suelo distinto del sofá | duda o nada |
Cuando algo no funciona
| Síntoma | Causa probable | Qué hacer |
|---|---|---|
| «No he podido cargar la IA» y No encuentro … (error 404) | Falta un archivo o el nombre no coincide | Los tres archivos del modelo, en la misma carpeta que el HTML |
| «… no coincide con model.json: pesa X bytes y model.json espera Y» | model.json y weights.bin son de exportaciones distintas | Vuelve a subir los tres del mismo ZIP, sobrescribiendo los antiguos |
| Un error que no incluye la versión de la página | El navegador tiene el HTML antiguo en caché | Recarga en una pestaña privada |
| «Falta https» | La dirección no es segura | Abre la página con https:// |
| La cámara no se abre | Página en un iframe o sin https | Ábrela en su propia dirección |
| Siempre dice «No estoy segura» | Luz, fondo o ángulo distintos de los del entrenamiento | Haz fotos como las del entrenamiento, o amplía el entrenamiento |
| Dice «camino» con algo en medio | Objeto no visto, muy pequeño o fuera del centro | Pon el objeto en el centro, o añade fotos así al entrenamiento |
| No suena la voz | Volumen bajo o, en iPhone, interruptor de silencio | Sube el volumen y quita el modo silencio |
| No vibra | La vibración solo funciona en algunos móviles Android | Es normal en iPhone |
Los límites: cuánto da la prueba
- Solo sabe lo que le enseñamos. 150 fotos de un sofá no valen para una calle, una cocina o una escalera.
- Mira solo el centro de la foto. Lo que queda en los bordes no cuenta.
- Una foto no es un vídeo. No avisa mientras alguien camina; solo responde cuando se hace una foto.
- Los porcentajes no son una garantía. Un 95 % puede ser un error, porque el modelo no sabe lo que no ha visto.
- Una persona no es un robot. Quien camina no lleva el móvil a la altura fija de un robot, y la foto cambia mucho según cómo se sostenga.
- Distinto móvil, distinto resultado. Cámaras, objetivos y luz cambian lo que ve el modelo.
Para el aula
- Mueve el umbral. Prueba con 0,5, 0,8 y 0,95 y cuenta, con las mismas 15 fotos, cuántos aciertos, cuántos fallos y cuántas dudas hay en cada caso. ¿Qué umbral elegirías para algo en lo que se juega la seguridad?
- El centro. Haz la misma foto con el obstáculo en el centro, en una esquina y fuera de plano. ¿Qué pasa? ¿Qué cambiarías en el entrenamiento?
- Falsos «camino». Busca el obstáculo más difícil de ver. ¿Cuál es el fallo más grave: un falso «camino despejado» o un falso «obstáculo»? ¿Por qué?
- Rompe el modelo. Fotografía un sitio muy distinto. ¿Con qué seguridad contesta algo que no tiene sentido?
- Reescribe los textos. Cambia las frases del objeto
TEXTOS. ¿Qué frase se entiende mejor al oírla sin mirar la pantalla? - Sin la nube. Compara esta página con la del 09. ¿Qué ganamos y qué perdemos al no usar Gemini? (Pista: pensad en privacidad, cuota, precisión y flexibilidad.)
- Piensa en la ética. Si este detector se instalara de verdad en un andador o en un robot que guía a alguien, ¿quién debería comprobarlo y con qué pruebas?
Conclusión
Con un modelo propio y una página de unas pocas líneas hemos hecho algo distinto de los chismes anteriores:
foto → modelo en el móvil → tres porcentajes → pantalla + voz
Y hemos aprendido tres cosas que importan más que el código:
- Los datos mandan: el modelo vale lo que valen las fotos con las que se entrenó.
- La duda es parte de la respuesta: un detector honrado dice cuándo no está seguro.
- Un buen mensaje de error ahorra horas: comprobar que los archivos encajan son unas pocas líneas de código y evitan errores que no se entienden.
La Gata ya lo sabía desde el principio: lo más seguro de un detector no es que acierte, sino que sepa cuándo no puede.
⚠️ ANTES DE PUBLICAR NADA, LEE ESTO
Es una prueba técnica de un centro educativo. No es un sistema de seguridad, ni un producto sanitario, ni una ayuda a la movilidad de nadie.
No la uses para guiar a una persona ni para decidir si un camino es seguro. Una IA puede equivocarse y hacerlo con total seguridad.
No fotografíes personas y revisa las fotos antes de enseñar o publicar capturas: no deben salir caras, pantallas con datos ni documentos.
La foto no sale del móvil, pero la página descarga las librerías de TensorFlow.js y Teachable Machine desde internet (jsDelivr), y la voz del móvil, según el sistema, puede usar un servicio en línea. Si trabajas con alumnado, revisa las condiciones con la persona responsable de protección de datos de tu centro.
Pide consentimiento a la persona y a su familia antes de que la pruebe.
La tecnología es la parte fácil. Decidir cómo, con quién y para qué la usamos es el verdadero chisme.
HTML
<!DOCTYPE html>
<html lang="es">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1, viewport-fit=cover">
<meta name="theme-color" content="#0b6b3a">
<title>Chisme 18b · El detector de obstáculos del Lince</title>
<style>
:root{--bg:#eef4ee;--card:#fbfdfb;--ink:#16261b;--mute:#4f6355;--line:#c9dccd;--pine:#0b6b3a;--ocre:#b9770e;--bad:#8a1c1c}
*{box-sizing:border-box}
body{margin:0;background:var(--bg);color:var(--ink);font:20px/1.45 system-ui,-apple-system,"Segoe UI",Roboto,sans-serif;padding:env(safe-area-inset-top) 0 env(safe-area-inset-bottom)}
header{background:var(--pine);color:#fff;padding:14px 18px;border-bottom:10px solid #fff;box-shadow:0 10px 0 var(--pine);margin-bottom:10px}
header h1{margin:0;font-size:1.45rem}
main{max-width:680px;margin:0 auto;padding:14px}
.aviso{background:#f6e3df;border:1px solid #dfb1a8;color:var(--bad);border-radius:10px;padding:10px 13px;font-size:.85rem;margin:0 0 14px}
button,.btn{font:inherit;font-weight:700;border:0;border-radius:14px;cursor:pointer;color:#fff;background:var(--pine);display:flex;align-items:center;justify-content:center;text-align:center}
button:focus-visible,label:focus-within,input:focus-visible{outline:4px solid var(--ocre);outline-offset:3px}
.sr{position:absolute;width:1px;height:1px;opacity:0;overflow:hidden}
#foto{width:100%;min-height:22vh;font-size:2rem;padding:14px;margin:0 0 12px}
#galeria{width:100%;min-height:64px;font-size:1.1rem;margin:0 0 14px;background:var(--card);color:var(--pine);border:2.5px solid var(--pine)}
.off{opacity:.45;pointer-events:none}
#vista{display:none;width:100%;max-width:340px;aspect-ratio:1/1;margin:0 auto 12px;border-radius:12px;background:#dfe9e0}
#res{border:4px solid var(--line);background:var(--card);border-radius:16px;padding:16px;margin:0 0 12px;text-align:center}
#res .ico{font-size:3.4rem;line-height:1;font-weight:800}
#res .tit{font-size:1.9rem;font-weight:800;line-height:1.15;margin:6px 0 4px}
#res .det{font-size:1.15rem}
#res.ok{background:#e1f2e6;border-color:var(--pine);color:#0b4a28}
#res.mal{background:#f6dcdc;border-color:var(--bad);color:#6e1414}
#res.duda{background:#fbefd5;border-color:var(--ocre);color:#6d4608}
#res.nada{background:#e8ecef;border-color:#5b6b76;color:#2d3b45}
#res.err{background:#f6dcdc;border-color:var(--bad);color:var(--bad)}
#barras{margin:0 0 12px;display:none}
.b{display:grid;grid-template-columns:8.2em 1fr 3.2em;gap:8px;align-items:center;font-size:.95rem;margin:4px 0}
.b i{display:block;height:16px;border-radius:8px;background:var(--line);overflow:hidden}
.b i span{display:block;height:100%;background:var(--pine);width:0}
.b em{font-style:normal;text-align:right;font-weight:700}
.fila{display:grid;grid-template-columns:1fr 1fr;gap:10px;margin:0 0 12px}
.fila button{min-height:72px;font-size:1.1rem;background:var(--card);color:var(--pine);border:2.5px solid var(--pine)}
small{display:block;color:var(--mute);font-size:.8rem;margin-top:6px}
</style>
</head>
<body>
<header><h1>El detector de obstáculos</h1></header>
<main>
  <p class="aviso"><strong>Prueba técnica.</strong> Es una IA entrenada con pocas fotos. <strong>No es un sistema de seguridad ni una ayuda para caminar.</strong> No fotografíe personas.</p>

  <canvas id="vista" width="448" height="448" aria-label="Foto que ha analizado la IA"></canvas>
  <label class="btn off" id="foto" for="f1">Hacer foto</label>
  <input class="sr" id="f1" type="file" accept="image/*" capture="environment">
  <button class="off" id="galeria" type="button">Elegir una foto que ya tengo</button>
  <input class="sr" id="f2" type="file" accept="image/*">

  <div id="res" aria-live="polite">
    <div class="ico" id="ico">…</div>
    <div class="tit" id="tit">Cargando la IA</div>
    <div class="det" id="det">Un momento, por favor.</div>
  </div>

  <div id="barras"></div>

  <div class="fila" id="voz" hidden>
    <button id="leer" type="button">Leer otra vez</button>
    <button id="calla" type="button">Callar</button>
  </div>

  <small>La foto no sale del móvil: la IA funciona dentro de esta página. Se analiza el centro de la foto, así que ponga ahí el suelo que quiere comprobar. La IA puede equivocarse: mire siempre usted también.</small>
</main>

<script src="https://cdn.jsdelivr.net/npm/@tensorflow/tfjs@1.3.1/dist/tf.min.js"></script>
<script src="https://cdn.jsdelivr.net/npm/@teachablemachine/image@0.8/dist/teachablemachine-image.min.js"></script>
<script>
/* ---------- Ajustes ---------- */
const MODELO = 'model.json';      // los tres archivos del modelo están en la misma carpeta que esta página
const METADATOS = 'metadata.json';
const UMBRAL = 0.80;              // por debajo de este porcentaje, la IA dice que no está segura

const TEXTOS = {
  camino:    {cls:'ok',   ico:'✔', tit:'Camino despejado', det:'No veo nada en medio. Mire usted también.',
              voz:'Camino despejado. No veo nada en medio. Mire usted también.'},
  obstaculo: {cls:'mal',  ico:'⚠', tit:'¡Cuidado! Hay un obstáculo', det:'Hay algo en medio del camino.',
              voz:'Cuidado. Hay algo en medio del camino.'},
  nada:      {cls:'nada', ico:'∅', tit:'No veo camino', det:'Apunte la cámara al suelo, delante de usted.',
              voz:'No veo el camino. Apunte la cámara al suelo, delante de usted.'},
  duda:      {cls:'duda', ico:'?', tit:'No estoy segura', det:'Mire usted con cuidado o haga otra foto con más luz.',
              voz:'No estoy segura. Mire usted con cuidado, o haga otra foto con más luz.'}
};
const NOMBRES = {camino:'Camino despejado', obstaculo:'Obstáculo', nada:'No hay camino'};

const $ = id => document.getElementById(id);
const norm = s => String(s).toLowerCase().normalize('NFD').replace(/[\u0300-\u036f]/g, '').trim();
let modelo = null, ultimaVoz = '';

function mostrar(t, extra) {
  $('res').className = t.cls; $('ico').textContent = t.ico; $('tit').textContent = t.tit;
  $('det').textContent = extra || t.det;
}
function activar(si) {
  ['foto', 'galeria'].forEach(id => $(id).classList.toggle('off', !si));
}

/* ---------- Voz ---------- */
function leer(t) {
  if (!('speechSynthesis' in window)) return;
  speechSynthesis.cancel();
  const v = speechSynthesis.getVoices().find(v => v.lang.toLowerCase().startsWith('es'));
  const u = new SpeechSynthesisUtterance(t); u.lang = 'es-ES'; u.rate = .9; if (v) u.voice = v;
  speechSynthesis.speak(u);
}
function desbloquearVoz() { // iPhone: la voz solo se activa tras un toque
  if ('speechSynthesis' in window) speechSynthesis.speak(new SpeechSynthesisUtterance(''));
}
$('leer').onclick = () => leer(ultimaVoz);
$('calla').onclick = () => speechSynthesis.cancel();
$('foto').addEventListener('click', desbloquearVoz);
$('galeria').addEventListener('click', () => { desbloquearVoz(); $('f2').click(); });

/* ---------- Descargar los 3 archivos sin caché, comprobarlos y cargar el modelo ---------- */
const VERSION = 'v3';
const BYTES = {float32:4, int32:4, bool:1, uint8:1, uint16:2, int8:1, int16:2, float16:2};
async function bajar(url) {
  const r = await fetch(url, {cache:'no-store'});
  if (!r.ok) throw new Error('No encuentro ' + url + ' (error ' + r.status + ').');
  return r;
}
async function cargar() {
  try {
    if (typeof tmImage === 'undefined') throw new Error('No se han podido cargar las librerías (¿sin internet?).');
    const mj = JSON.parse(await (await bajar(MODELO)).text().catch(() => '{}') || '{}');
    const grupos = mj.weightsManifest || [];
    const nombre = (grupos[0] && grupos[0].paths && grupos[0].paths[0]) || 'weights.bin';
    if (grupos.length !== 1 || grupos[0].paths.length !== 1) throw new Error('El modelo tiene varios fragmentos de pesos; esta página espera un solo weights.bin.');
    const esperado = grupos[0].weights.reduce((t, w) => {
      const dt = (w.quantization && w.quantization.dtype) || w.dtype || 'float32';
      return t + w.shape.reduce((a, b) => a * b, 1) * (BYTES[dt] || 4);
    }, 0);
    const wr = await bajar(nombre), wb = await wr.blob();
    if (wb.size !== esperado)
      throw new Error(nombre + ' no coincide con model.json: pesa ' + wb.size + ' bytes y model.json espera ' + esperado +
        '. Son de exportaciones distintas, o el archivo del servidor está cambiado.');
    const mdr = await bajar(METADATOS), mdb = await mdr.blob();
    const fm = new File([JSON.stringify(mj)], 'model.json'),
          fw = new File([wb], nombre),
          fd = new File([mdb], 'metadata.json');
    modelo = await tmImage.loadFromFiles(fm, fw, fd);
    mostrar({cls:'nada', ico:'📷', tit:'Lista', det:'Pulse «Hacer foto» y apunte al suelo.'});
    activar(true);
  } catch (e) {
    mostrar({cls:'err', ico:'✖', tit:'No he podido cargar la IA (' + VERSION + ')'}, e.message);
  }
}

/* ---------- Foto: recorte cuadrado del centro (lo que ve la IA es lo que ve usted) ---------- */
function abrir(file) {
  return new Promise((ok, mal) => {
    const url = URL.createObjectURL(file), img = new Image();
    img.onload = () => { URL.revokeObjectURL(url); ok(img); };
    img.onerror = () => { URL.revokeObjectURL(url); mal(new Error('No puedo abrir esta imagen.')); };
    img.src = url;
  });
}
async function nuevaFoto(e) {
  const f = e.target.files[0]; e.target.value = ''; if (!f || !modelo) return;
  activar(false); $('voz').hidden = true; speechSynthesis.cancel();
  mostrar({cls:'nada', ico:'…', tit:'Mirando', det:'Un momento.'});
  try {
    const img = await abrir(f), c = $('vista'), s = Math.min(img.width, img.height);
    c.getContext('2d').drawImage(img, (img.width - s) / 2, (img.height - s) / 2, s, s, 0, 0, c.width, c.height);
    c.style.display = 'block';
    const pred = await modelo.predict(c);
    resultado(pred);
  } catch (err) {
    mostrar({cls:'err', ico:'✖', tit:'No he podido analizar la foto'}, err.message);
  }
  activar(true);
}
$('f1').onchange = nuevaFoto; $('f2').onchange = nuevaFoto;

/* ---------- Resultado ---------- */
function resultado(pred) {
  const mejor = pred.reduce((a, b) => b.probability > a.probability ? b : a);
  const clave = norm(mejor.className);
  const pct = Math.round(mejor.probability * 100);
  let t;
  if (mejor.probability < UMBRAL || !TEXTOS[clave]) t = TEXTOS.duda; // ante la duda, no afirmamos nada
  else t = TEXTOS[clave];
  mostrar(t, t === TEXTOS.duda ? t.det + ' (Lo más probable: ' + (NOMBRES[clave] || mejor.className) + ', ' + pct + ' %.)'
                               : t.det + ' (' + pct + ' % seguro)');
  ultimaVoz = t.voz; $('voz').hidden = false; leer(t.voz);
  if (t === TEXTOS.obstaculo && navigator.vibrate) navigator.vibrate([200, 100, 200]);

  $('barras').style.display = 'block';
  $('barras').innerHTML = pred.map(p => {
    const n = NOMBRES[norm(p.className)] || p.className, v = Math.round(p.probability * 100);
    return '<div class="b"><span></span><i><span style="width:' + v + '%"></span></i><em>' + v + '%</em></div>'.replace('<span></span>', '<span>' + n + '</span>');
  }).join('');
}

if (!window.isSecureContext) mostrar({cls:'err', ico:'✖', tit:'Falta https'}, 'La cámara y la IA necesitan una dirección https.');
else cargar();
</script>
</body>
</html>