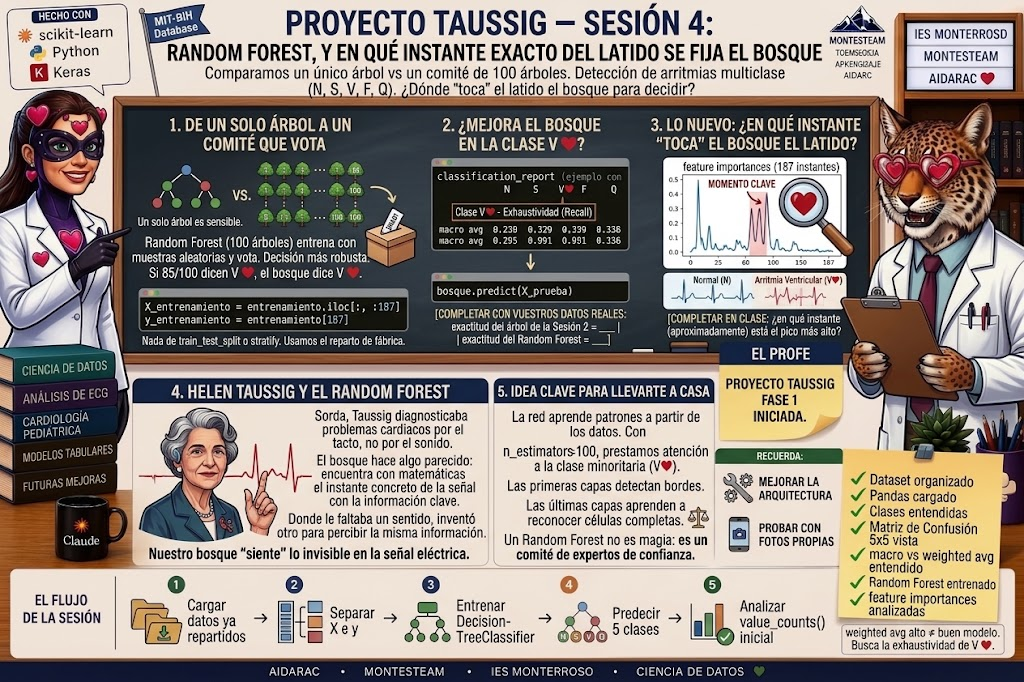
En la Sesion 4 del Proyecto Taussig, el alumnado entrena un Random Forest sobre los latidos de ECG, comprueba si mejora la deteccion de la arritmia ventricular respecto al arbol unico, y descubre con feature importances en que instante exacto del latido se fija el modelo para decidir.
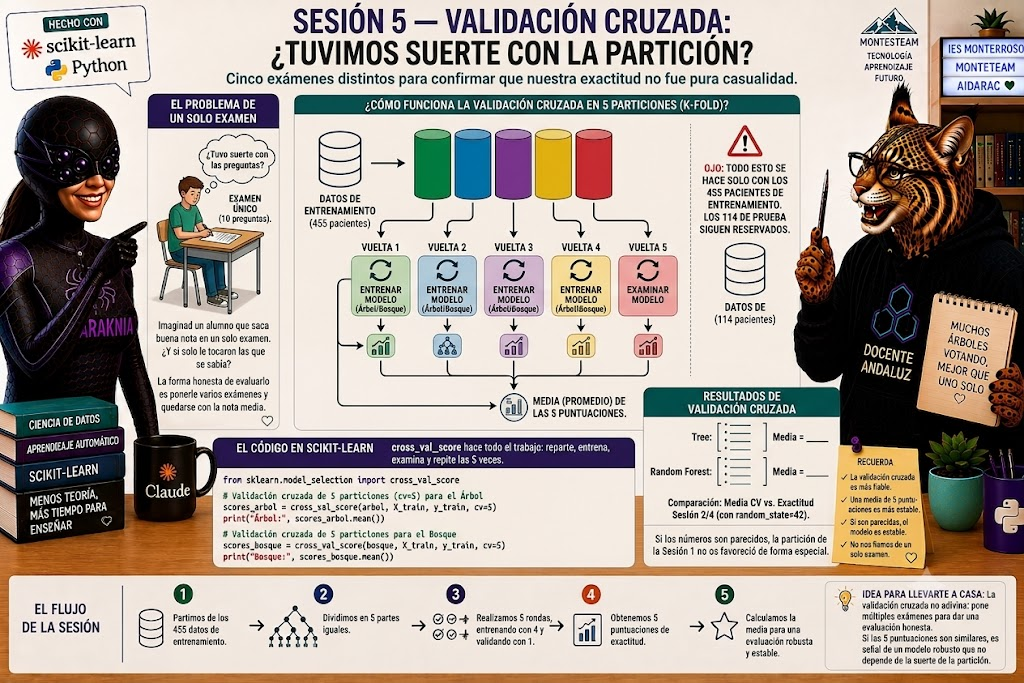
En la Sesión 5, la última del taller CUTLER, el alumnado usa validación cruzada con scikit-learn para comprobar si la exactitud de sus modelos dependía de la suerte de una única partición de datos, cerrando el recorrido del taller.
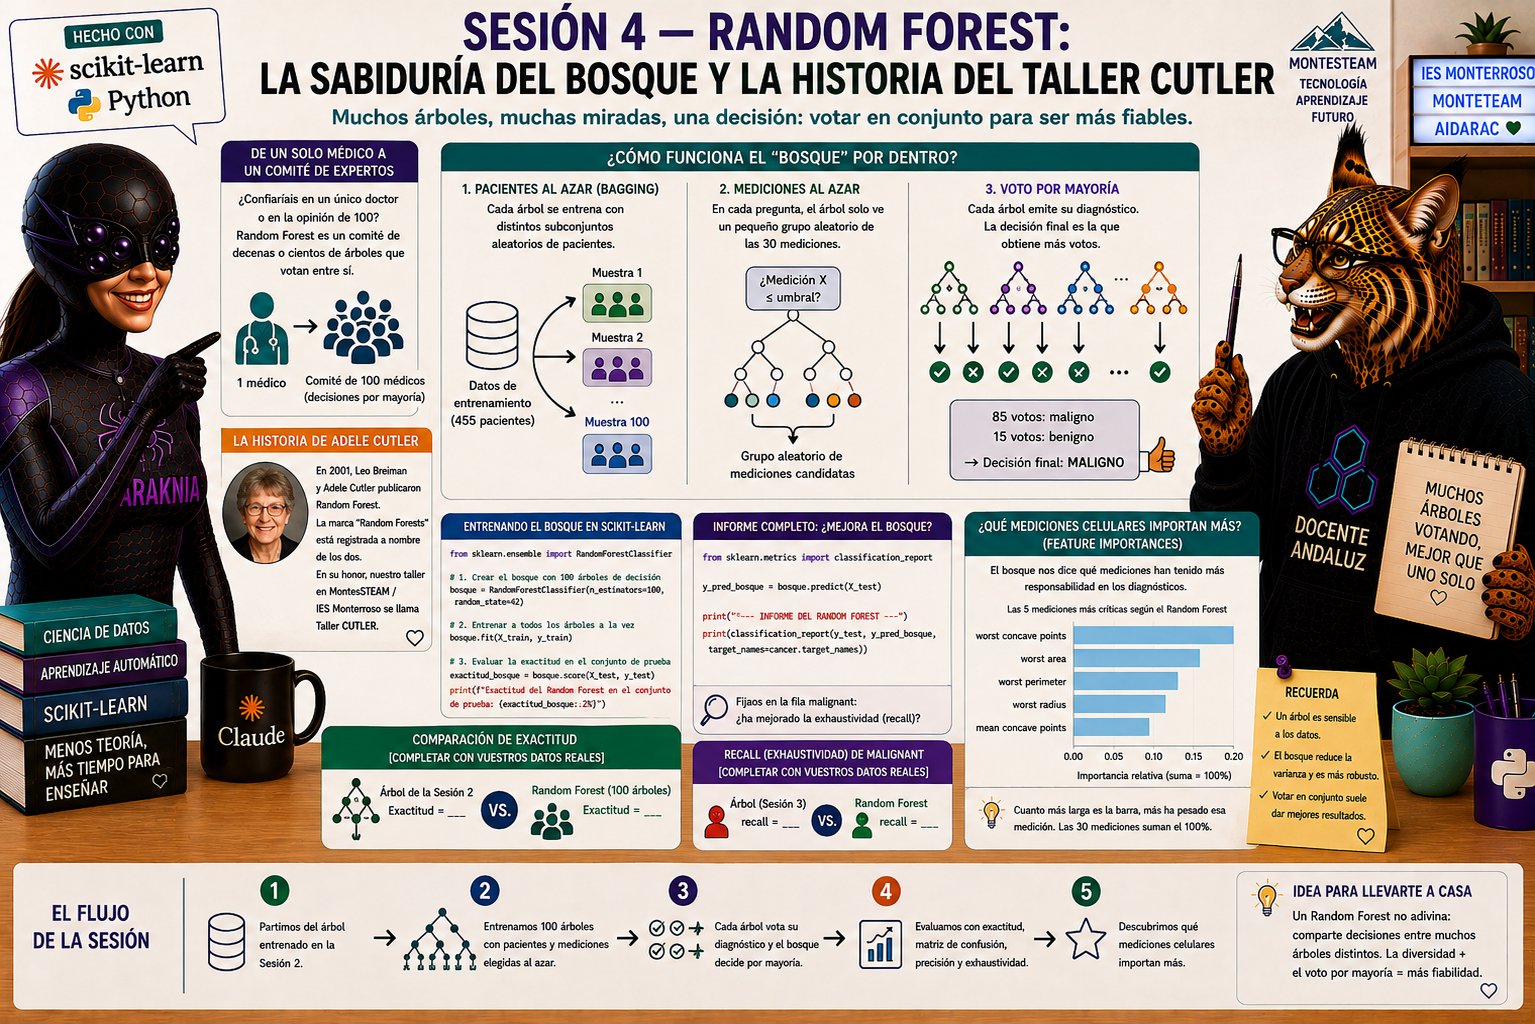
Sesión 4 del taller CUTLER, el alumnado entrena su primer Random Forest (bosque aleatorio) con scikit-learn. Descubrimos la historia de Adele Cutler, la sabiduría del voto por mayoría y qué mediciones celulares son más críticas en la detección del cáncer.
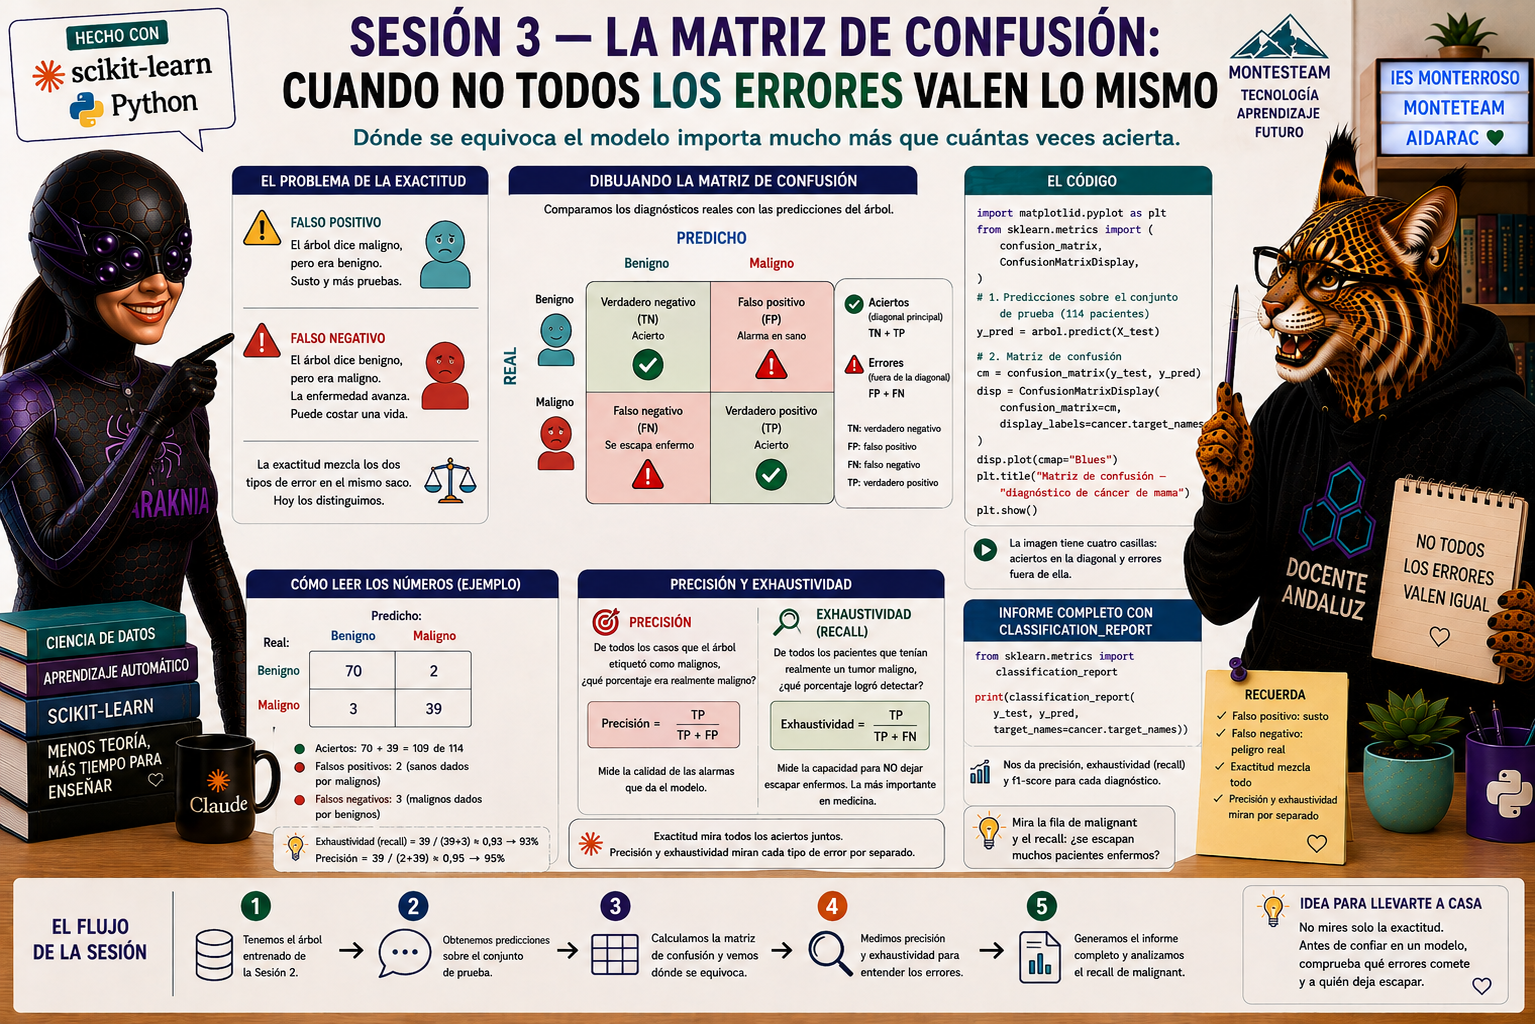
Seguimos en nuestro cuaderno. En la Sesión 2 entrenamos nuestro primer árbol de decisión y calculamos su exactitud en el conjunto de prueba. Nos dio un porcentaje bastante alto pero, ¿es suficiente un solo número para confiar en un diagnóstico …
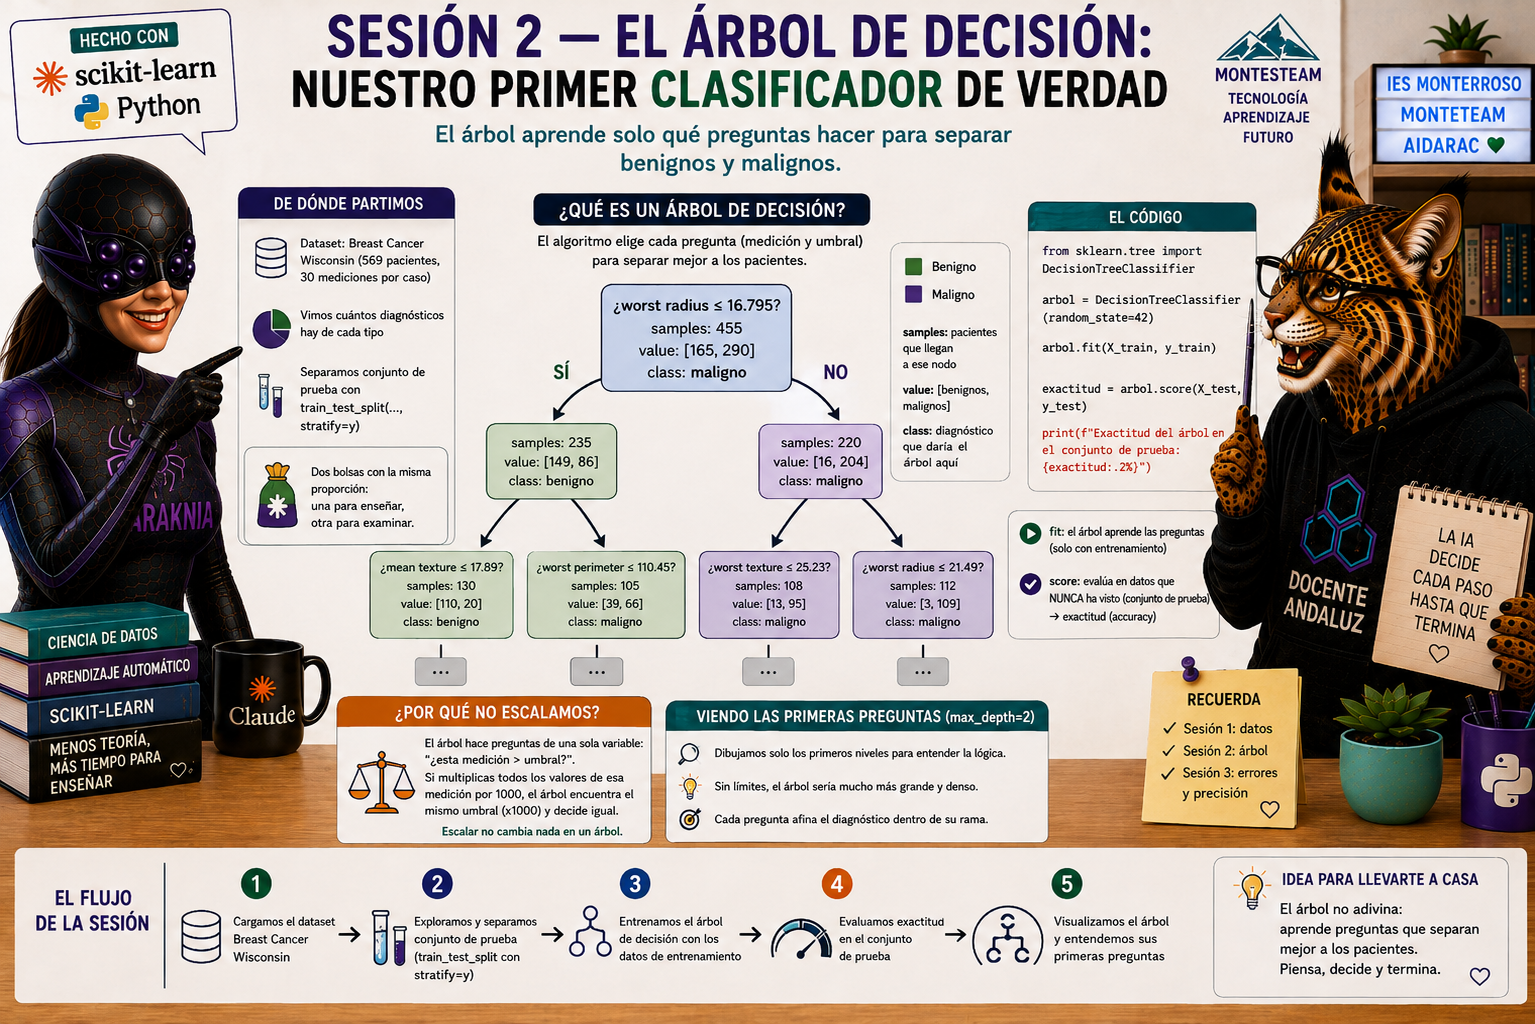
En la Sesión 2 del taller CUTLER, el alumnado entrena su primer clasificador real — un árbol de decisión con scikit-learn — sobre datos médicos reales, sin escalar variables y midiendo su exactitud.
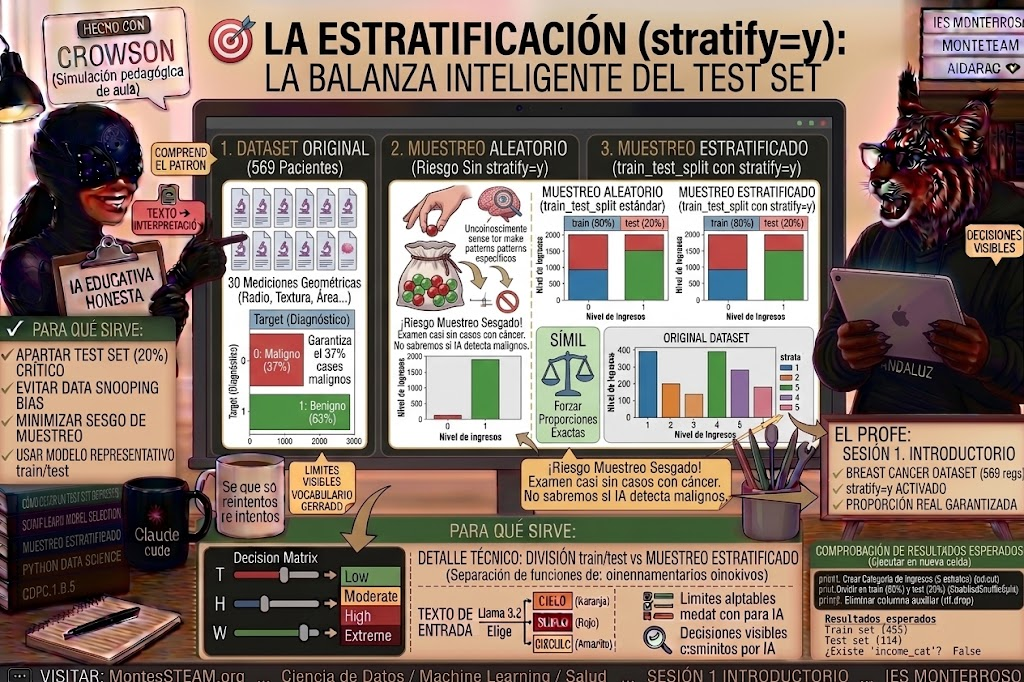
En este tutorial introductorio de Ciencia de Datos para MontesSTEAM e IES Monterroso, damos los primeros pasos en Machine Learning aplicado a la salud mediante el dataset real Breast Cancer Wisconsin. Aprende a instalar scikit-learn en JupyterLab, cargar datos médicos en memoria, reservar un conjunto de prueba para evaluar el modelo y comprender la importancia de la estratificación (stratify=y) para garantizar un reparto equilibrado entre tumores benignos y malignos.
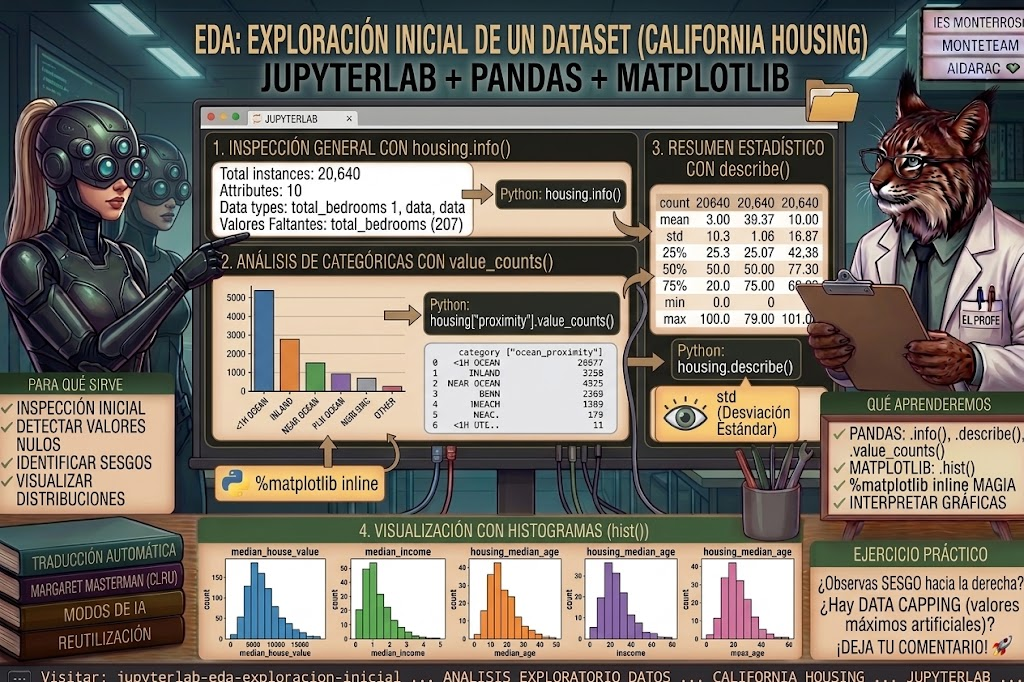
Este tutorial guía paso a paso al alumnado en la realización de un Análisis Exploratorio de Datos (EDA) inicial utilizando Python, Pandas y JupyterLab sobre el conjunto de datos California Housing. A través de métodos fundamentales como info(), value_counts(), describe() e hist(), los estudiantes aprenderán a identificar la estructura del dataset, detectar valores nulos, analizar variables categóricas, interpretar estadísticas descriptivas (como cuartiles y desviación estándar) y visualizar la distribución de los datos mediante histogramas con Matplotlib. Incluye un reto práctico final para afianzar los conceptos aprendidos.
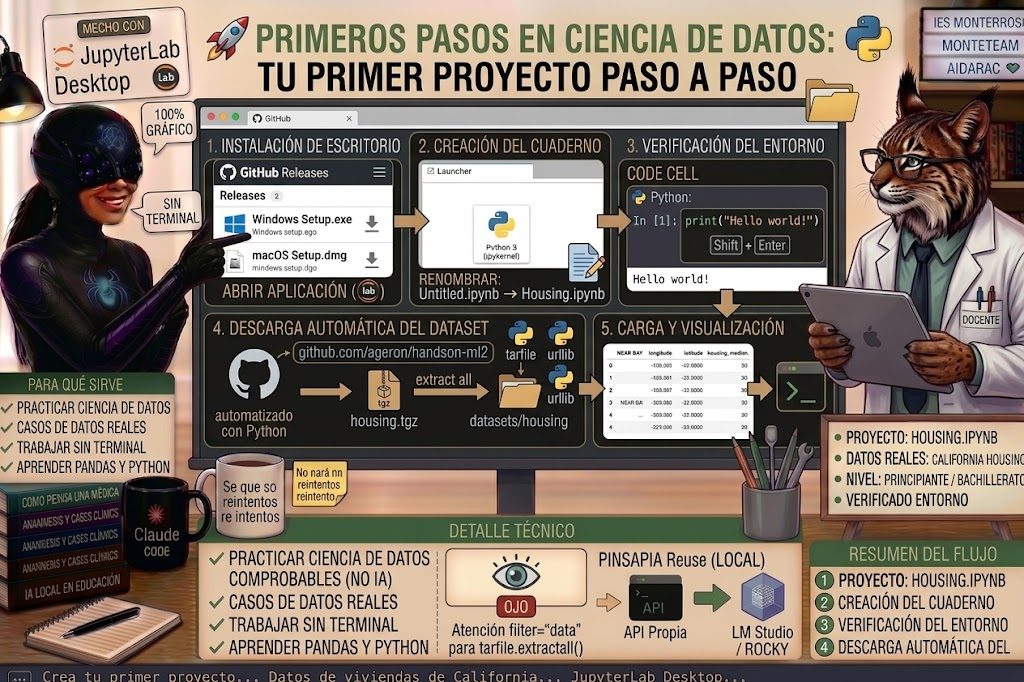
Aprende a configurar un entorno de Ciencia de Datos en local con JupyterLab Desktop de forma 100% visual y sin usar comandos de consola. Guía paso a paso para descargar y visualizar tu primer conjunto de datos real con Python y Pandas para proyectos de Inteligencia Artificial y pensamiento computacional.
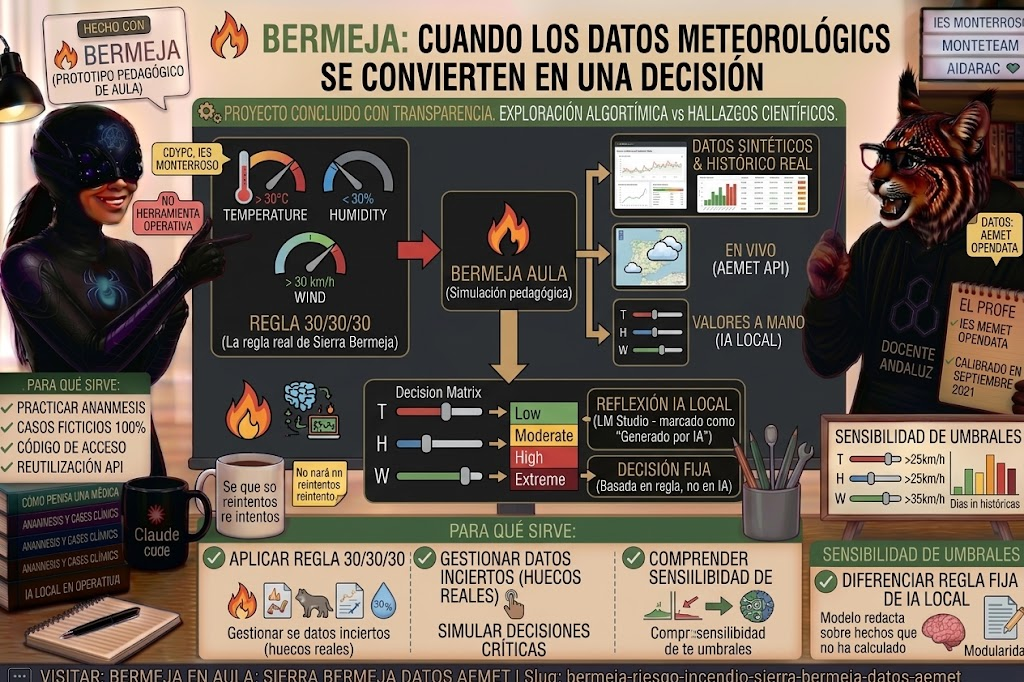
BERMEJA es una herramienta de aula del IES Monterroso que aplica la regla real 30/30/30 y datos de AEMET para enseñar a tomar decisiones sobre riesgo de incendio forestal.
Ni periódicos ni vendedores ambulantes: el problema del vendedor de periódicos, resuelto con el ejemplo más cercano que tiene el instituto. ARSENIA calcula cuántos bocadillos preparar cada mañana en el bar de Arsenia, sabiendo que pedir de más y pedir de menos cuestan cosas distintas.