Proyecto Peridotita 10: De la teledetección a la Inteligencia Artificial — Entrenando un Árbol de Decisión en Google Colab para evaluar el riesgo de desertificación
¡Lo hemos conseguido! Tras extraer los datos satelitales de Sierra Bermeja y procesarlos con Inteligencia Artificial en Google Colab, hemos generado el primer modelo predictivo del proyecto. Esta novena entrada constituye un hito científico clave para Climate Detectives: pasamos de la observación estática a la predicción automatizada utilizando algoritmos de aprendizaje automático (Machine Learning).
A continuación, explicamos paso a paso todo el proceso técnico, desde la salida de Google Earth Engine hasta la interpretación detallada del árbol de decisión obtenido.
Paso 1: Extracción del Dataset Multivariable (De GEE a CSV)
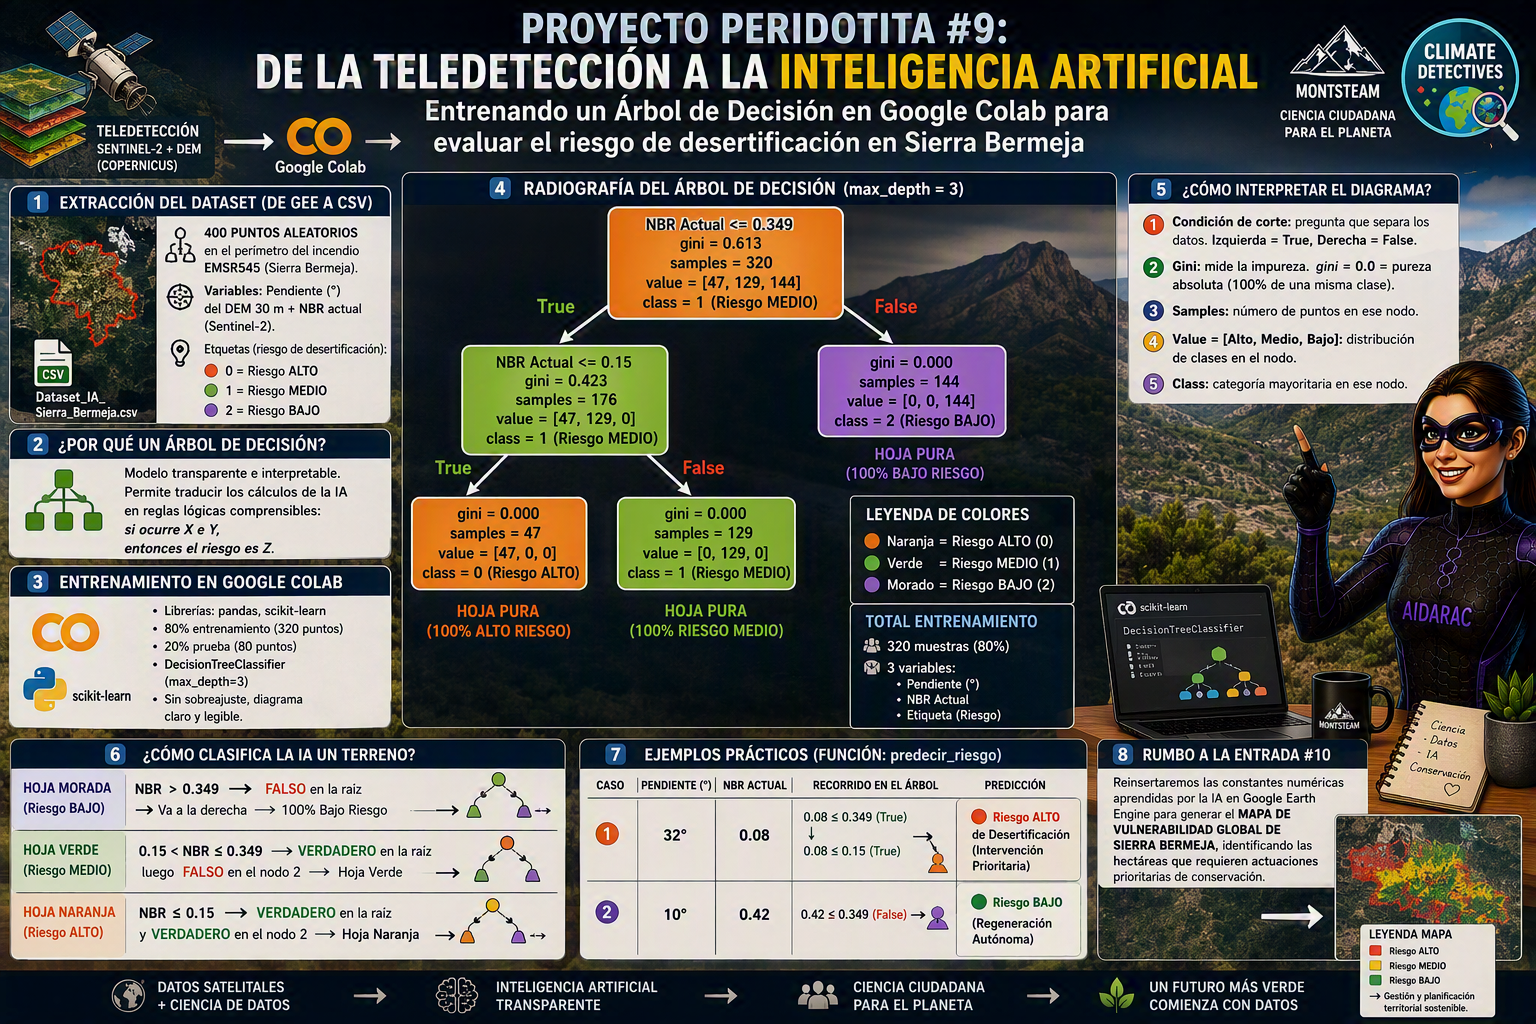
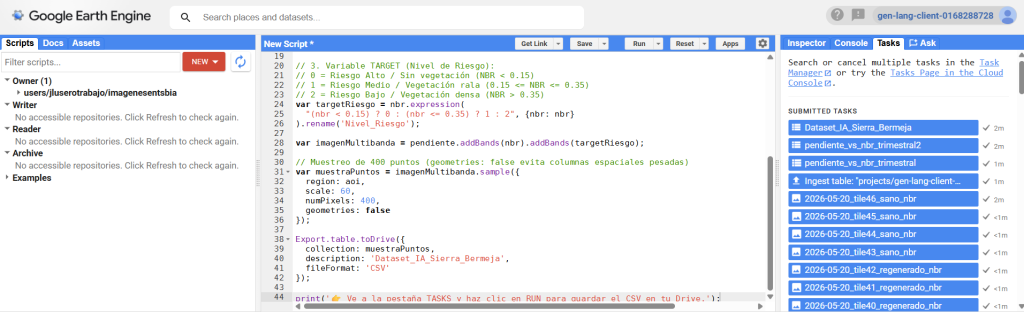
Para alimentar nuestro modelo de IA, necesitábamos extraer de Google Earth Engine una muestra representativa del terreno. Diseñamos un script que tomó 400 puntos aleatorios distribuidos por todo el perímetro del incendio (EMSR545). Cada punto contenía el ángulo de la pendiente (extraído del DEM Copernicus de 30 m) y el valor actual del índice $NBR$ (Sentinel-2), etiquetando cada registro en tres categorías según su grado de regeneración vegetal: Riesgo Alto (0), Riesgo Medio (1) y Riesgo Bajo (2).
Paso 2: ¿Por qué elegimos un Árbol de Decisión?
En el ámbito de la ciencia ciudadana y la gestión ambiental, no nos sirven las IAs tipo “caja negra” que dan una predicción sin explicar sus motivos. Elegimos un Árbol de Decisión (Decision Tree Classifier) porque es un modelo transparente e interpretable: nos permite “abrir el cerebro” de la Inteligencia Artificial y traducir sus cálculos matemáticos en reglas lógicas escritas en lenguaje humano (del tipo si ocurre X e Y, entonces el riesgo es Z).
Paso 3: Entrenando el modelo en Google Colab con scikit-learn
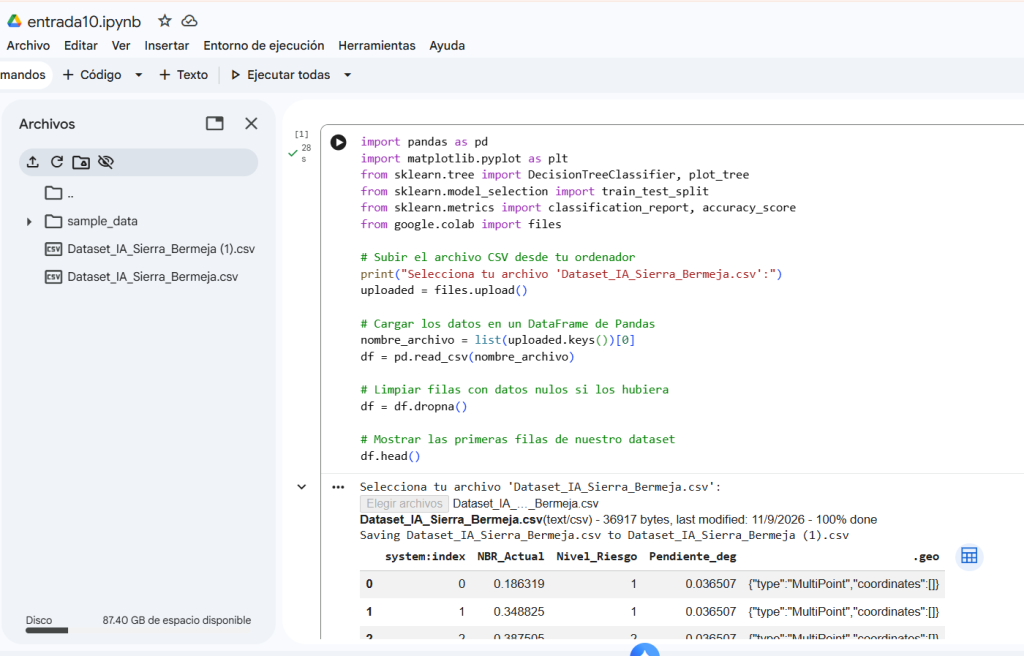
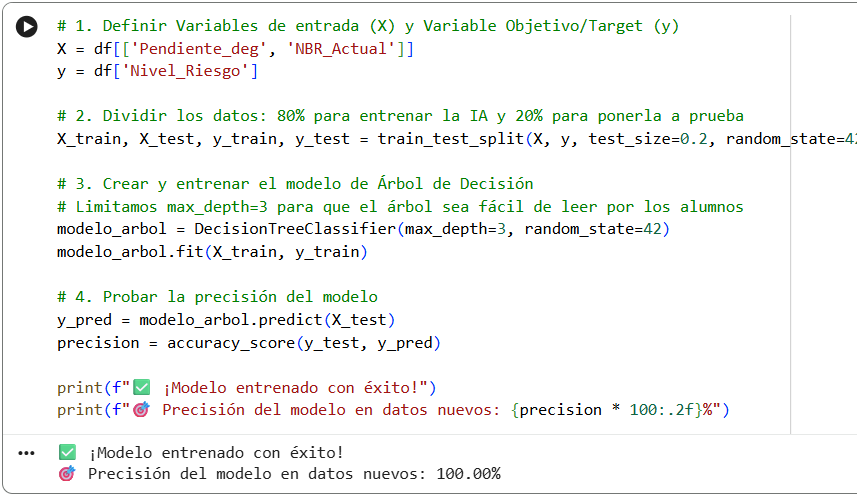
Una vez cargado el archivo Dataset_IA_Sierra_Bermeja.csv en Google Colab utilizando la librería pandas, dividimos la muestra en dos conjuntos: el 80% de los datos (320 puntos) se destinó a entrenar a la IA, mientras que el 20% restante (80 puntos) se reservó para evaluar la precisión del modelo en puntos no vistos previamente. Mediante la librería scikit-learn, ajustamos el árbol fijando una profundidad máxima (max_depth=3) para evitar el sobreajuste y garantizar que el diagrama resultante fuera nítido y legible para el alumnado.
Paso 4: Radiografía completa del Árbol de Decisión (Análisis del diagrama)
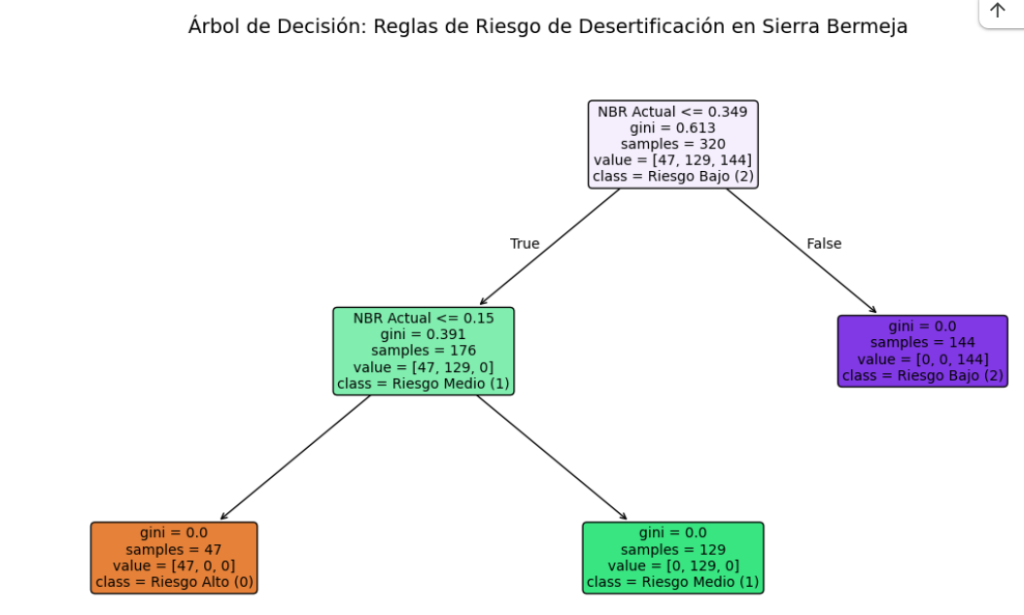
La imagen generada en Colab representa el mapa de pensamiento de nuestra IA. Para comprender qué ha aprendido el algoritmo, debemos analizar la información contenida en las casillas (nodos):
- Condición de corte (Ejemplo:
NBR Actual <= 0.349): Es la pregunta lógica que realiza el árbol en ese nivel para separar los datos en dos caminos. Si la afirmación es verdadera, el punto de terreno viaja por la rama izquierda (True); si es falsa, toma la rama derecha (False). - Impureza de Gini (
gini): Mide la heterogeneidad de las muestras en ese nodo. Un valor alto (comogini = 0.613en la raíz) indica que hay una mezcla confusa de clases. Un valor degini = 0.0representa la pureza absoluta, lo que significa que el 100% de los puntos en ese nodo pertenecen a la misma categoría de riesgo. - Muestras (
samples): Es el número total de puntos de terreno que están siendo analizados en ese nodo específico. En el nodo raíz superior hay 320 muestras (el total de nuestro conjunto de entrenamiento). - Distribución de clases (
value = [Alto, Medio, Bajo]): Desglosa cuántos puntos pertenecen a cada una de las tres categorías. En el nodo raíz,value = [47, 129, 144]significa que hay 47 puntos de Riesgo Alto, 129 de Riesgo Medio y 144 de Riesgo Bajo. - Clase asignada (
class): Indica la categoría mayoritaria en ese nodo en particular, identificada además mediante un código de colores (naranja para Riesgo Alto, verde para Riesgo Medio y morado para Riesgo Bajo).
Paso 5: ¿Cómo usa la IA estos parámetros para clasificar un terreno?
El modelo toma las decisiones evaluando el perfil de cualquier punto de Sierra Bermeja a través de los nodos de decisión:
- Evaluación de la Hoja Morada (Derecha): Si un punto de terreno tiene un
NBR Actual > 0.349, toma el camino False desde la raíz. Cae directamente en la casilla morada congini = 0.0,samples = 144yvalue = [0, 0, 144]. La IA concluye con un 100% de certeza que pertenece a Riesgo Bajo (2). - Evaluación de la Hoja Naranja (Izquierda-Izquierda): Si el
NBR Actuales menor o igual a 0.349, toma el camino True hacia el nodo verde intermedio. Si además elNBR Actual <= 0.15, vuelve a tomar el camino True y desemboca en la hoja naranja (gini = 0.0,samples = 47,value = [47, 0, 0]). La IA lo clasifica automáticamente como Riesgo Alto (0). - Evaluación de la Hoja Verde (Izquierda-Derecha): Si el NBR se encuentra en el rango intermedio (mayor que 0.15 pero menor o igual a 0.349), toma la ruta False desde el nodo central y cae en la hoja verde inferior (
gini = 0.0,samples = 129), asignándole Riesgo Medio (1).
Paso 6: Aplicación en los ejemplos prácticos del código
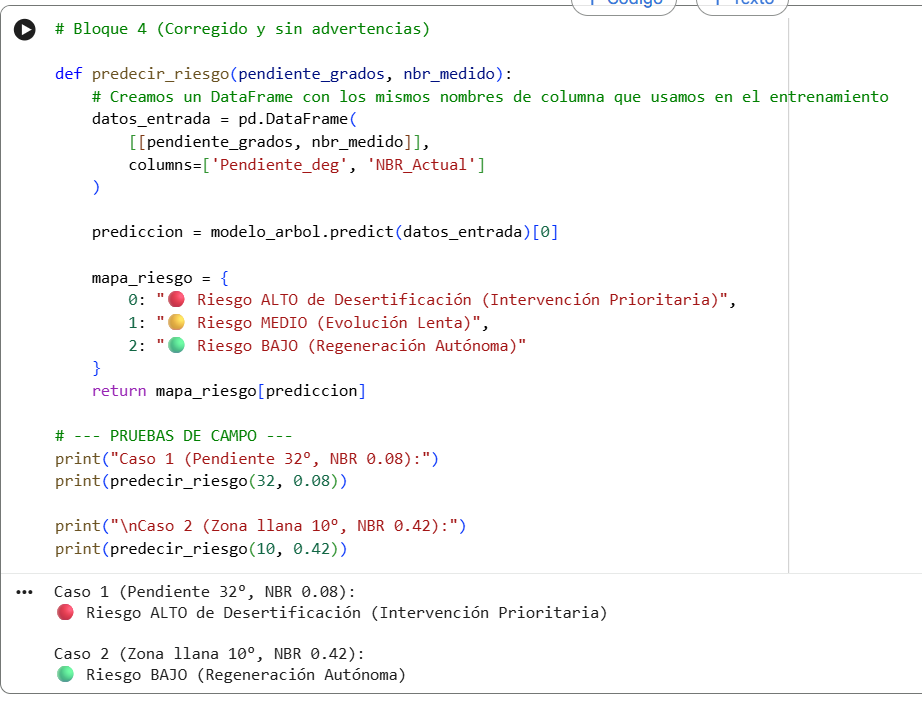
En el tramo final del script de Python, definimos la función predecir_riesgo() para poner a prueba el árbol con coordenadas reales simuladas:
- Caso 1 (Pendiente 32°, NBR 0.08): La función envía estos valores al árbol. Como
0.08 <= 0.349(True) y0.08 <= 0.15(True), el algoritmo clasifica el suelo dentro del grupo naranja y devuelve: 🔴 Riesgo ALTO de Desertificación (Intervención Prioritaria). - Caso 2 (Zona llana 10°, NBR 0.42): Al procesar los datos, la condición inicial
0.42 <= 0.349resulta falsa (False), desplazando el registro a la rama derecha. El árbol devuelve de inmediato: 🟢 Riesgo BAJO (Regeneración Autónoma).
Rumbo a la Entrada #10: La síntesis final
Con las reglas de decisión perfectamente validadas en Google Colab, tenemos el motor lógico necesario para dar el paso definitivo en la Entrada #10. Reinsertaremos estas constantes numéricas aprendidas por la IA en Google Earth Engine para pintar el Mapa de Vulnerabilidad Global de Sierra Bermeja, identificando las hectáreas exactas que requieren actuaciones prioritarias de conservación por parte de las administraciones públicas.
Proyecto Peridotita #9: De la teledetección a la Inteligencia Artificial — Entrenando un Árbol de Decisión en Google Colab para evaluar el riesgo de desertificación
¡Lo hemos conseguido! Tras extraer los datos satelitales de Sierra Bermeja y procesarlos con Inteligencia Artificial en Google Colab, hemos generado el primer modelo predictivo del proyecto. Esta novena entrada constituye un hito científico clave para Climate Detectives: pasamos de la observación estática a la predicción automatizada utilizando algoritmos de aprendizaje automático (Machine Learning).
A continuación, explicamos paso a paso todo el proceso técnico, desde la salida de Google Earth Engine hasta la interpretación detallada del árbol de decisión obtenido.
Paso 1: Extracción del Dataset Multivariable (De GEE a CSV)
Para alimentar nuestro modelo de IA, necesitábamos extraer de Google Earth Engine una muestra representativa del terreno. Diseñamos un script que tomó 400 puntos aleatorios distribuidos por todo el perímetro del incendio (EMSR545). Cada punto contenía el ángulo de la pendiente (extraído del DEM Copernicus de 30 m) y el valor actual del índice $NBR$ (Sentinel-2), etiquetando cada registro en tres categorías según su grado de regeneración vegetal: Riesgo Alto (0), Riesgo Medio (1) y Riesgo Bajo (2).
Paso 2: ¿Por qué elegimos un Árbol de Decisión?
En el ámbito de la ciencia ciudadana y la gestión ambiental, no nos sirven las IAs tipo “caja negra” que dan una predicción sin explicar sus motivos. Elegimos un Árbol de Decisión (Decision Tree Classifier) porque es un modelo transparente e interpretable: nos permite “abrir el cerebro” de la Inteligencia Artificial y traducir sus cálculos matemáticos en reglas lógicas escritas en lenguaje humano (del tipo si ocurre X e Y, entonces el riesgo es Z).
Paso 3: Entrenando el modelo en Google Colab con scikit-learn
Una vez cargado el archivo Dataset_IA_Sierra_Bermeja.csv en Google Colab utilizando la librería pandas, dividimos la muestra en dos conjuntos: el 80% de los datos (320 puntos) se destinó a entrenar a la IA, mientras que el 20% restante (80 puntos) se reservó para evaluar la precisión del modelo en puntos no vistos previamente. Mediante la librería scikit-learn, ajustamos el árbol fijando una profundidad máxima (max_depth=3) para evitar el sobreajuste y garantizar que el diagrama resultante fuera nítido y legible para el alumnado.
Paso 4: Radiografía completa del Árbol de Decisión (Análisis del diagrama)
La imagen generada en Colab representa el mapa de pensamiento de nuestra IA. Para comprender qué ha aprendido el algoritmo, debemos analizar la información contenida en las casillas (nodos):
- Condición de corte (Ejemplo:
NBR Actual <= 0.349): Es la pregunta lógica que realiza el árbol en ese nivel para separar los datos en dos caminos. Si la afirmación es verdadera, el punto de terreno viaja por la rama izquierda (True); si es falsa, toma la rama derecha (False). - Impureza de Gini (
gini): Mide la heterogeneidad de las muestras en ese nodo. Un valor alto (comogini = 0.613en la raíz) indica que hay una mezcla confusa de clases. Un valor degini = 0.0representa la pureza absoluta, lo que significa que el 100% de los puntos en ese nodo pertenecen a la misma categoría de riesgo. - Muestras (
samples): Es el número total de puntos de terreno que están siendo analizados en ese nodo específico. En el nodo raíz superior hay 320 muestras (el total de nuestro conjunto de entrenamiento). - Distribución de clases (
value = [Alto, Medio, Bajo]): Desglosa cuántos puntos pertenecen a cada una de las tres categorías. En el nodo raíz,value = [47, 129, 144]significa que hay 47 puntos de Riesgo Alto, 129 de Riesgo Medio y 144 de Riesgo Bajo. - Clase asignada (
class): Indica la categoría mayoritaria en ese nodo en particular, identificada además mediante un código de colores (naranja para Riesgo Alto, verde para Riesgo Medio y morado para Riesgo Bajo).
Paso 5: ¿Cómo usa la IA estos parámetros para clasificar un terreno?
El modelo toma las decisiones evaluando el perfil de cualquier punto de Sierra Bermeja a través de los nodos de decisión:
- Evaluación de la Hoja Morada (Derecha): Si un punto de terreno tiene un
NBR Actual > 0.349, toma el camino False desde la raíz. Cae directamente en la casilla morada congini = 0.0,samples = 144yvalue = [0, 0, 144]. La IA concluye con un 100% de certeza que pertenece a Riesgo Bajo (2). - Evaluación de la Hoja Naranja (Izquierda-Izquierda): Si el
NBR Actuales menor o igual a 0.349, toma el camino True hacia el nodo verde intermedio. Si además elNBR Actual <= 0.15, vuelve a tomar el camino True y desemboca en la hoja naranja (gini = 0.0,samples = 47,value = [47, 0, 0]). La IA lo clasifica automáticamente como Riesgo Alto (0). - Evaluación de la Hoja Verde (Izquierda-Derecha): Si el NBR se encuentra en el rango intermedio (mayor que 0.15 pero menor o igual a 0.349), toma la ruta False desde el nodo central y cae en la hoja verde inferior (
gini = 0.0,samples = 129), asignándole Riesgo Medio (1).
Paso 6: Aplicación en los ejemplos prácticos del código
En el tramo final del script de Python, definimos la función predecir_riesgo() para poner a prueba el árbol con coordenadas reales simuladas:
- Caso 1 (Pendiente 32°, NBR 0.08): La función envía estos valores al árbol. Como
0.08 <= 0.349(True) y0.08 <= 0.15(True), el algoritmo clasifica el suelo dentro del grupo naranja y devuelve: 🔴 Riesgo ALTO de Desertificación (Intervención Prioritaria). - Caso 2 (Zona llana 10°, NBR 0.42): Al procesar los datos, la condición inicial
0.42 <= 0.349resulta falsa (False), desplazando el registro a la rama derecha. El árbol devuelve de inmediato: 🟢 Riesgo BAJO (Regeneración Autónoma).
Rumbo a la Entrada #10: La síntesis final
Con las reglas de decisión perfectamente validadas en Google Colab, tenemos el motor lógico necesario para dar el paso definitivo en la Entrada #10. Reinsertaremos estas constantes numéricas aprendidas por la IA en Google Earth Engine para pintar el Mapa de Vulnerabilidad Global de Sierra Bermeja, identificando las hectáreas exactas que requieren actuaciones prioritarias de conservación por parte de las administraciones públicas.
Código
Aquí está todo el código que hemos usado

También te puede interesar
Chisme 147 del Lince: termómetro con micro:bit y LM35
Chisme 146 del Lince: LED con micro:bit y placa de ampliación