Aprendizaje por refuerzo: chisme 95 del Lince
Un robot que aprende sin que nadie le enseñe el camino.
En la cima de Sierra Bermeja, el Lince de la Noche ha sembrado robots de suelo llamados Macrothele, como la araña negra de los alcornocales. Su misión es llegar a la madriguera de la sierra sin caer en las trampas. El Lince les ha dado un mapa en blanco. La Gata Montesa lo mira y le dice: «Si les explicas el camino, siempre irán por donde tú quieras. Déjalos equivocarse».
Introducción
En este chisme construimos un simulador de aprendizaje por refuerzo: un robot que aprende a base de prueba y error. Nadie le dice qué movimiento es el correcto. Solo recibe premios y castigos después de cada paso.
Lo veremos en la pantalla del ordenador y, si quieres, en la matriz de LEDs de una micro:bit.
Por qué este chisme
Muchos sistemas reales aprenden así: un robot que aprende a caminar, un programa que aprende a jugar o un sistema que decide cuándo regar. Nadie escribe todas las reglas; las descubren mirando qué les sale bien y qué les sale mal.
Además, es la primera vez que la serie usa una forma de aprender distinta. En el detector de obstáculos los ejemplos ya venían etiquetados. Aquí no hay ejemplos: solo premios y castigos.
Cómo funciona
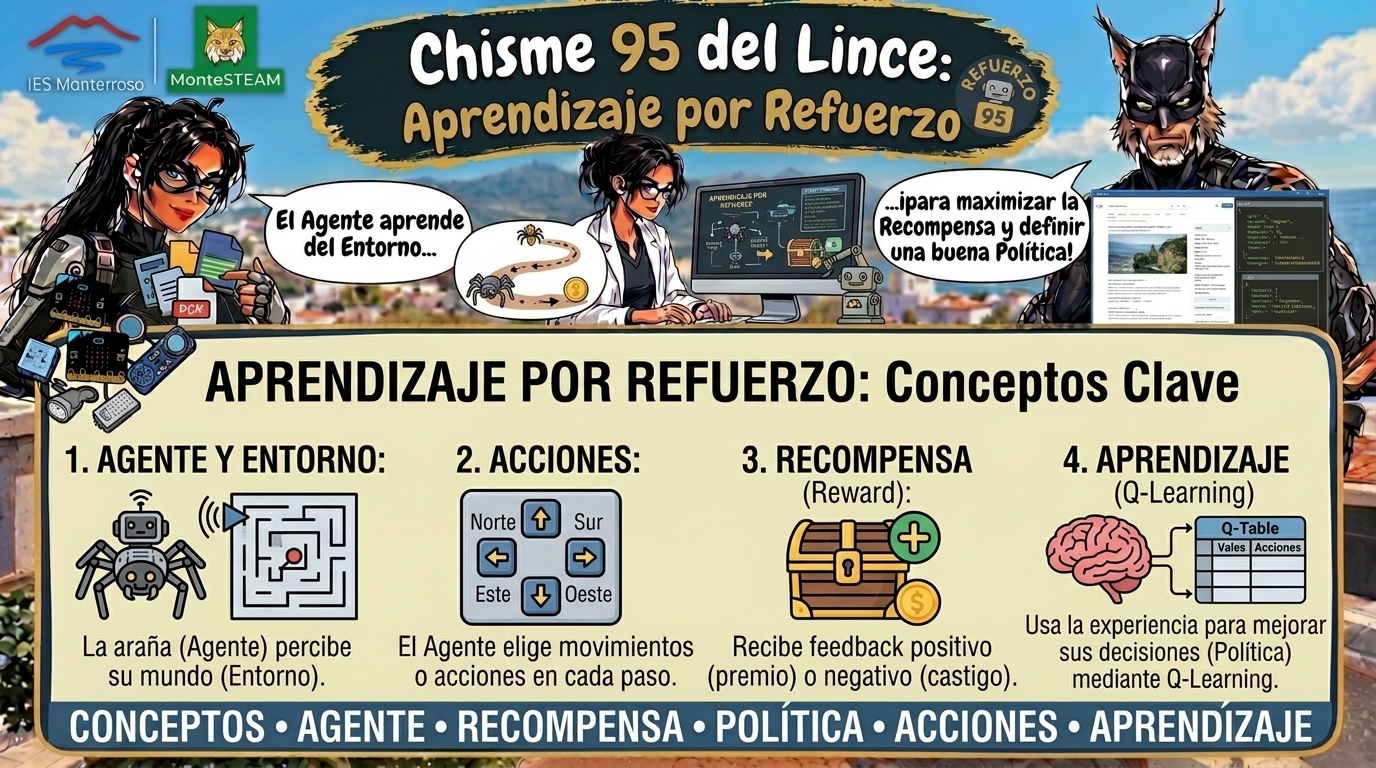
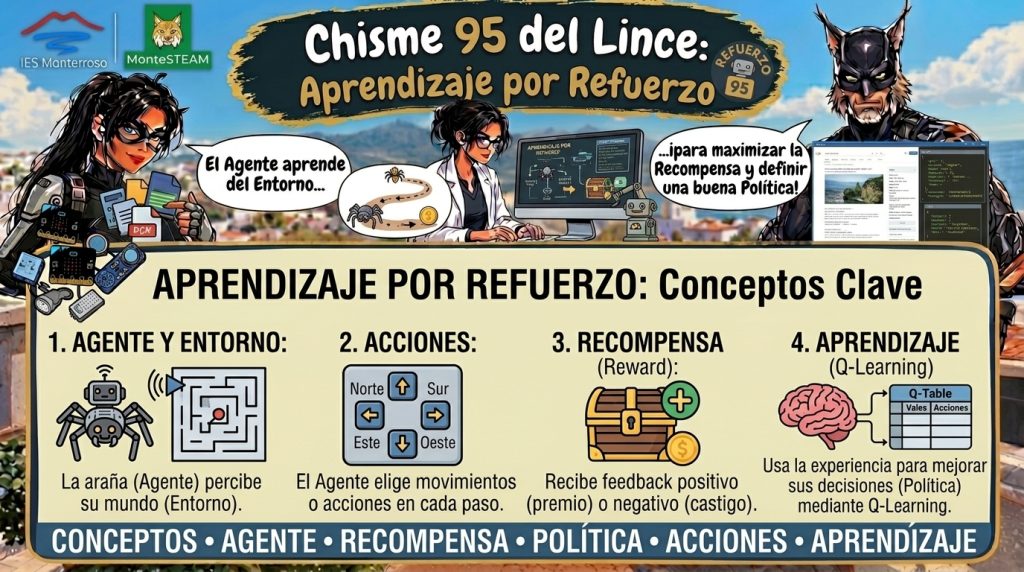
El robot sabe en qué casilla está y puede moverse arriba, derecha, abajo o izquierda. Por cada casilla y cada movimiento guarda un número, llamado Q, que indica lo que cree que le compensa hacer.
Al principio todos los números valen 0. Tras cada movimiento actualiza su Q con una idea sencilla: lo que ya sabía se corrige un poco con lo que acaba de ver.
nuevo Q = Q + tasa · (premio + descuento · mejor Q siguiente − Q)Para elegir, el robot usa el mejor Q que tiene, pero de vez en cuando prueba algo al azar. Si nunca se arriesga, nunca descubrirá un camino mejor.
Este método se llama Q-learning y pertenece a una familia más amplia: el aprendizaje por refuerzo.
Qué necesitamos
- Un navegador moderno (Chrome o Edge) para el simulador. No necesita instalación.
- Opcional: una micro:bit, un cable USB o Bluetooth y el editor MakeCode para la matriz de LEDs.
Construcción
- Abre la página del simulador: simulador del chisme 95.
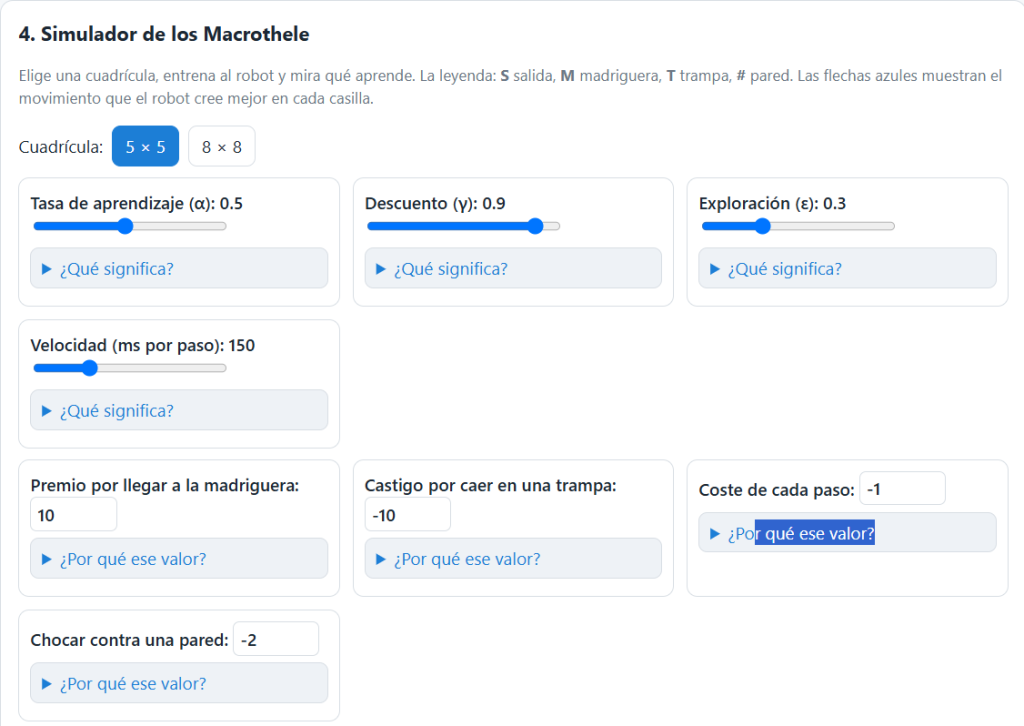
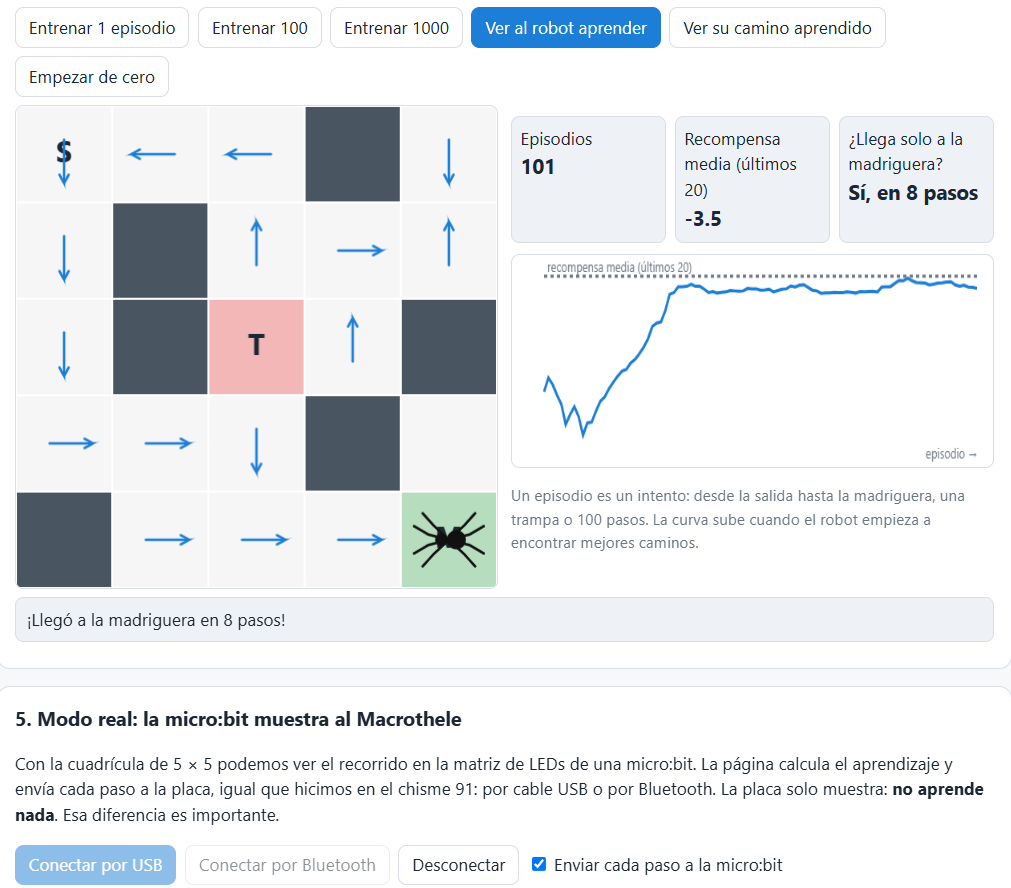
- Elige la cuadrícula de 5 × 5 y pulsa Entrenar 100.
- Pulsa Ver su camino aprendido: el robot recorre el mejor camino que ha encontrado.
- Para la micro:bit, copia el programa de MakeCode del apartado siguiente, pégalo en el editor en modo JavaScript y descárgalo a la placa.
- Conecta la micro:bit por USB o Bluetooth y activa «Enviar cada paso a la micro:bit».
El código de la micro:bit
La micro:bit solo muestra lo que le envía el ordenador. Entiende cuatro mensajes: R para empezar de nuevo, x,y para encender la casilla, M para la madriguera y T para la trampa. Se conecta igual que en el chisme de la pizarra de LEDs.
bluetooth.startUartService()
serial.setBaudRate(BaudRate.BaudRate115200)
let px = -1
let py = -1
basic.showString("MACROTHELE")

function digito(c: string): number {
    if (c == "0") { return 0 }
    if (c == "1") { return 1 }
    if (c == "2") { return 2 }
    if (c == "3") { return 3 }
    return 4
}

function limpia() {
    if (px >= 0) {
        led.unplot(px, py)
    }
    px = -1
    py = -1
}

function procesa(s: string) {
    if (s == "R") {
        basic.clearScreen()
        limpia()
    } else if (s == "M") {
        basic.showIcon(IconNames.Happy)
    } else if (s == "T") {
        basic.showIcon(IconNames.Sad)
    } else {
        limpia()
        px = digito(s.charAt(0))
        py = digito(s.charAt(2))
        led.plot(px, py)
    }
}

serial.onDataReceived(serial.delimiters(Delimiters.NewLine), function () {
    procesa(serial.readUntil(serial.delimiters(Delimiters.NewLine)))
})
bluetooth.onUartDataReceived(serial.delimiters(Delimiters.NewLine), function () {
    procesa(bluetooth.uartReadUntil(serial.delimiters(Delimiters.NewLine)))
})
Cómo probarlo
Empieza sin micro:bit. Entrena 100 episodios y pulsa «Ver su camino aprendido». Si el robot llega a la madriguera, ya ha aprendido un camino. Después prueba con 1000 episodios y compara.
Con la micro:bit conectada, cada paso del robot debe aparecer como un LED encendido en la matriz 5 × 5. Si no ocurre, comprueba que el programa es el de MakeCode y que la placa está en la pestaña correcta.
Qué estamos midiendo realmente
- El robot no entiende el mapa. Solo acumula números por casilla. Si cambias un premio, cambia lo que aprende, aunque el mapa sea el mismo.
- El resultado depende de los parámetros. Con los mismos premios, una tasa de aprendizaje o un descuento distinto pueden tardar mucho más, o no llegar nunca.
- Una media puede engañar. La recompensa media puede subir mientras el robot sigue cayendo en alguna trampa. Mira también el camino que aprende.
- Medir no es comprender. Que llegue en 8 pasos no demuestra que haya aprendido el mejor camino en general: depende de los premios, del azar y de los episodios entrenados.
Para el aula
- Entrena 100 episodios con los valores por defecto y anota cuántas veces llega a la madriguera. Repite con 1000. ¿Qué cambia?
- Pon el descuento a 0. ¿Aprende a llegar? ¿Por qué?
- Pon la exploración a 0 desde el principio. ¿Se queda atascado con un mal camino?
- Haz que caer en una trampa cueste lo mismo que llegar a la meta. ¿Qué pasa?
- Diseña tu propia cuadrícula de 5 × 5, predice cuántos episodios tardará en aprender y compruébalo.
Retos
- Haz que funcione. Entrena 1000 episodios y comprueba que el robot llega solo a la madriguera.
- Modifica algo. Añade una trampa nueva en el mapa de 8 × 8 y comprueba que el robot la evita.
- Añade un sensor. Con el sensor de luz de la micro:bit, cambia el premio según la luz. ¿Qué problema aparece?
- Guarda los datos. Anota la recompensa media cada 100 episodios y dibuja la curva en una hoja de cálculo.
- Haz que otro dispositivo participe. Dos micro:bit, una con el mapa y otra con el robot, pueden compartir el recorrido.
Qué hemos aprendido
Un robot puede aprender un camino sin que nadie se lo explique, solo con premios, castigos y muchos intentos. Lo que aprende depende de los premios y de los parámetros: no es magia, es una tabla de números que se corrige paso a paso.
Los Macrothele ya saben encontrar la madriguera. Ahora toca preguntarse si lo han aprendido de verdad o solo han tenido suerte, y eso solo se responde midiendo.
Prototipo educativo: la cuadrícula y los premios son de juguete. Los sistemas reales de aprendizaje por refuerzo son mucho más complejos.
Para seguir investigando
- El detector de obstáculos del lince (Teachable Machine): aprendizaje supervisado con ejemplos etiquetados.
- Aprendizaje por refuerzo en Wikipedia.
Etiqueta:AIDARAC, ies monterroso, montesteam

También te puede interesar
Compresión de imágenes y hexadecimal: chisme 96 del Lince
Chisme 94 del Lince: data scraping y metadatos para mejorar tu web