Cómo funciona un LLM: la inteligencia artificial paso a paso (Chisme 81 del Lince)
—Gata, lo he decidido: quiero mi propia inteligencia artificial —dijo el Lince de la Noche—. Que lo sepa todo y que me conteste a cualquier cosa. Dentro tendrá algo parecido a magia, ¿no?
—Dentro hay una lista de números, Lince —respondió la Gata Montesa—. Y una multiplicación detrás de otra. ¿Quieres saber cómo funciona un LLM?
—¿Y cómo va a saber la respuesta?
—Le daremos a leer física y matemáticas, que es lo que lee una IA pensada para la ciencia. Y no la sabe: calcula qué palabra es más probable que venga después. Vamos a construirla en pequeño y vas a ver cada cuenta.
—¿Ingeniería? —dijo el Lince—. Eso sí me gusta.
Introducción: cómo funciona un LLM sin magia
ChatGPT, Gemini o Claude son modelos de lenguaje (LLM, por large language model). Parecen magia, pero por dentro solo hay matemáticas e informática: lo que hacemos los ingenieros de software.
En este chisme 81 entrenas un mini-LLM de verdad en tu navegador, escribes una pregunta y lo ves calcular la respuesta palabra a palabra, con los números a la vista. Puedes abrirlo aquí: el LLM del Lince, paso a paso.
La IA de este chisme se llama A.L.P.H.A.S.I.D.A.: Asistente Lógico para la Predicción, el Hardware, la Astronomía, los Sistemas, la Informática, los Datos y el Aprendizaje. Es un modelo de lenguaje pequeño, como los grandes que usamos cada día, y es el que construimos paso a paso.
Por qué este chisme
Usamos la inteligencia artificial cada día, pero casi nadie sabe qué ocurre cuando pulsa «enviar». Si no lo sabes, es fácil creer que la IA «sabe» cosas, que «entiende» o que nunca se equivoca. Ninguna de las tres cosas es cierta.
Entender cómo funciona un LLM te permite usarlo mejor y desconfiar cuando toca. Y es la mejor manera de ver para qué sirven las matemáticas que estudias.
Cómo funciona un LLM: la idea en una frase
Un LLM predice la siguiente ficha a partir del texto que ya hay. La añade al texto y repite. Una respuesta de un párrafo son cientos de predicciones seguidas.
La metáfora de la biblioteca: imagina a alguien que ha leído millones de libros sin entender nada. Solo ha anotado qué palabra suele venir después de cada grupo de palabras. No guarda los libros: guarda los mandos de una mesa de mezclas que se fueron girando poco a poco hasta que acertar la palabra siguiente fuera cada vez más fácil. Esos mandos son los parámetros.
Los siete pasos de una palabra
La página te enseña, con tus propios textos, estos siete pasos:
- Fichas (tokens). El texto se corta en trozos y cada trozo recibe un número. Nuestro mini-LLM usa palabras enteras; los LLM reales usan trozos de palabra (técnica llamada BPE), para poder escribir cualquier palabra, incluso inventada.
- Ventana de contexto. El modelo solo ve las últimas fichas. El nuestro ve 10; los reales, decenas o cientos de miles.
- Embeddings. Cada ficha se convierte en una lista de números (un vector). Esos números no los escribe nadie: se ajustan durante el entrenamiento.
- Atención. La última ficha «pregunta» (query) y las demás «responden» con una etiqueta (key). El producto escalar mide cuánto se parecen y softmax lo convierte en porcentajes: son los pesos con los que se mezcla el contexto.
- Red neuronal. El vector pasa por una capa de neuronas. Cada neurona hace una suma ponderada y se apaga si el resultado es negativo (función ReLU).
- Probabilidades. Cada palabra del diccionario recibe una puntuación y softmax las convierte en probabilidades que suman 1.
- Elegir. Se sortea una palabra según esas probabilidades. La temperatura controla cuánto azar hay: con 0 sale siempre la más probable.
Qué necesitamos
- Un ordenador con un navegador moderno. No hace falta instalar nada ni conectarse a internet.
- Curiosidad. Todo el código es JavaScript puro, sin bibliotecas, y se puede leer entero en el archivo.
Cómo aprende: el entrenamiento
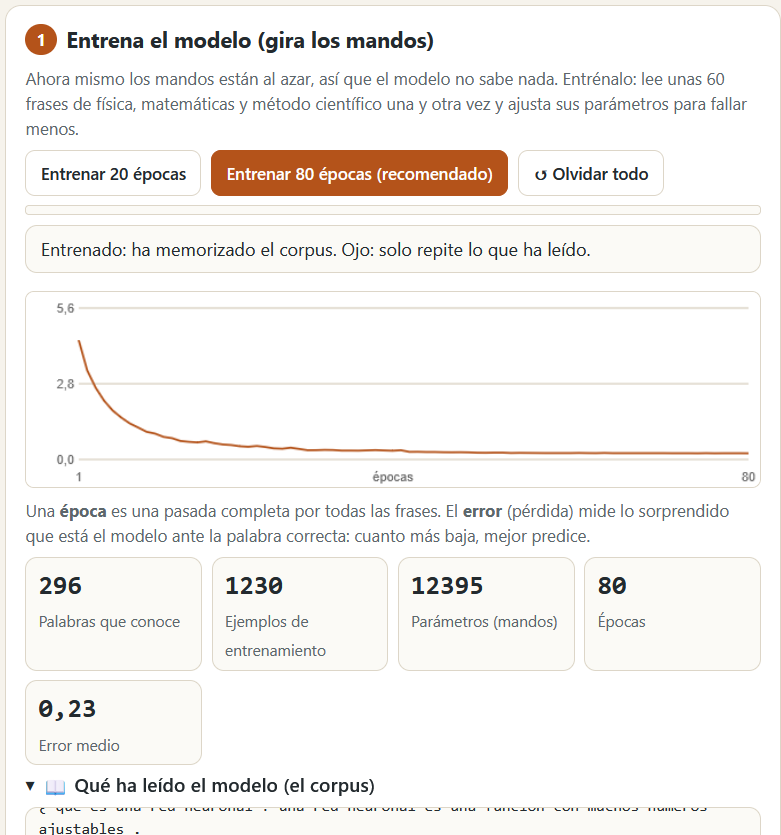
El mini-LLM empieza con todos los mandos al azar, así que si le preguntas algo suelta palabras sin sentido. Al entrenarlo ocurre esto, una y otra vez:
- Se toma un trozo de texto real y se tapa la última palabra.
- El modelo calcula probabilidades para cada palabra posible.
- Se mide el error: cuánta probabilidad dio a la palabra correcta. Si le dio poca, el error es grande.
- Se calcula, con derivadas (el algoritmo de retropropagación), cuánto hay que girar cada mando para reducir ese error.
- Se giran todos los mandos un poquito en esa dirección. Es el descenso del gradiente, con un ajustador llamado Adam.
Una pasada completa por todas las frases es una época. Con 80 épocas el mini-LLM contesta bien a todas las preguntas del corpus. La página dibuja cómo baja el error. Nuestro mini-LLM tiene unos 10.000 parámetros y lee unas 60 frases de física, matemáticas y método científico, como «¿qué es la velocidad?» o «¿qué dice la ley de Ohm?». Un LLM real tiene miles de millones de parámetros y lee billones de palabras, pero el principio es el mismo.
Los gráficos de la página
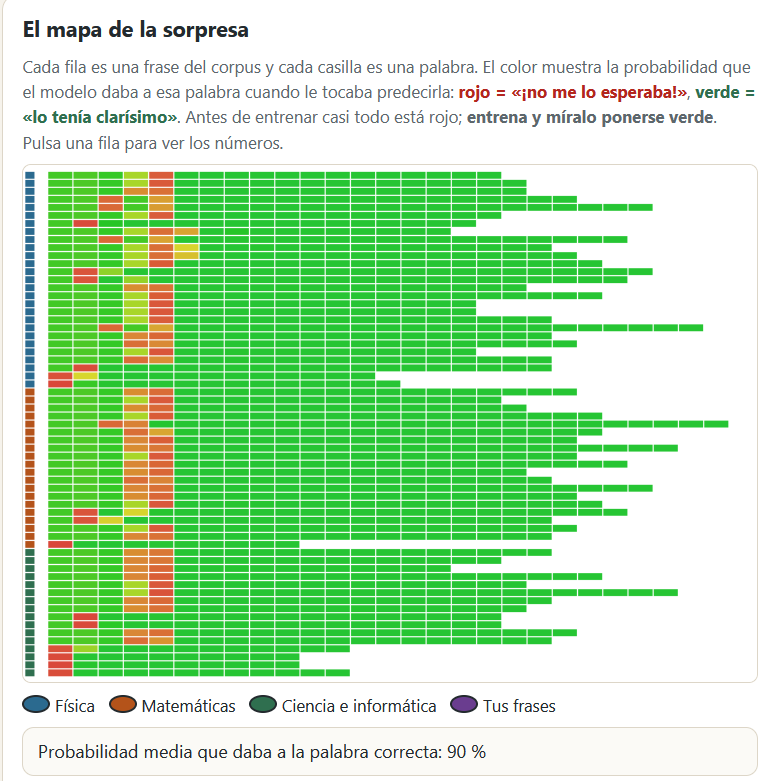
- El mapa de la sorpresa: una fila por frase y una casilla por palabra, del rojo («no me lo esperaba») al verde («lo tenía claro»). Mientras entrenas, todo se va poniendo verde.
- Arcos de atención: la última ficha mira a las demás; cuanto más gruesa la línea, más atención.
- Esquema de la red: los 16 números de entrada, las 48 neuronas (naranja las activas) y los 16 números de salida, con las conexiones más fuertes.
- Barras de probabilidad: las puntuaciones y lo que hace softmax con ellas.
Cómo probarlo
Hay cinco misiones y una opcional:
- Recorre los 7 pasos hasta ver qué palabra elige el modelo.
- Genera una respuesta sin entrenar y otra con 60 épocas o más: compara.
- Pon la temperatura a 0 y comprueba que la misma pregunta da siempre la misma respuesta.
- Escribe una pregunta con palabras que no conoce y mira cómo las trata.
- Pulsa una fila del mapa de la sorpresa y mira qué probabilidad daba el modelo a cada palabra de esa frase.
- Opcional: escribe tus propias frases con el formato «pregunta | respuesta» y comprueba si las aprende.
Qué estamos viendo realmente
- El modelo no entiende. Calcula probabilidades. Que sus respuestas parezcan inteligentes es una consecuencia de haber leído muchísimo texto.
- Alucinar es normal. Siempre hay una palabra más probable que las demás, aunque no sepa nada del tema. Prueba la pregunta de Marge: el mini-LLM responde con total aplomo a algo que nunca ha leído.
- Los vectores de palabras no dicen nada con tan pocos datos. En un LLM real los vectores acaban agrupando palabras parecidas; en el nuestro, con tan poco texto, no. Lo hemos comprobado y por eso la página no te enseña un mapa de significados falso.
- Memorizar no es comprender. Con unas 60 frases el modelo las memoriza. Un LLM real generaliza mucho más porque ha visto muchísimos más ejemplos, pero la diferencia es de grado.
- Correlación y causalidad. El modelo aprende qué palabras aparecen juntas, no por qué ocurren las cosas.
- Medir no es medir bien. Que el error baje no garantiza que las respuestas sean verdaderas: solo que se parecen más al texto de entrenamiento.
Lo que no cabe en la página: de este juguete a un asistente
Un asistente real hace lo mismo que nuestro mini-LLM, pero añade varias cosas:
- Muchísimas capas. En vez de una capa de atención hay decenas, y cada una tiene muchas «cabezas» que miran cosas distintas (gramática, tema, quién habla…). Esta arquitectura se llama transformer y se presentó en el artículo Attention Is All You Need.
- Preentrenamiento y ajuste. Primero lee billones de palabras para aprender el idioma. Después se ajusta con ejemplos de conversaciones y con valoraciones de personas para que obedezca instrucciones y sea útil y seguro.
- Mucha potencia de cálculo. El entrenamiento exige miles de procesadores gráficos (GPU) durante semanas. Responder cuesta mucho menos, pero también es mucho cálculo.
- Herramientas. Algunos asistentes buscan en internet o ejecutan código para comprobar lo que dicen. Eso reduce errores, pero no los elimina.
Si quieres leer más, la entrada de Wikipedia sobre los modelos de lenguaje grandes es un buen punto de partida.
Privacidad
El mini-LLM se entrena y calcula en tu navegador: no se envía ningún texto a internet. Con un asistente en la nube, en cambio, lo que escribes viaja a un servidor. Piensa siempre qué datos personales pones.
Para el aula
- ¿Qué cambia entre el modelo sin entrenar y el entrenado? Describe el cambio con las gráficas del error.
- Calcula a mano un softmax de tres puntuaciones (por ejemplo 2, 1 y 0). ¿Por qué suman 1 las probabilidades?
- ¿Qué pasa si la temperatura sube a 1,5? ¿Para qué tipo de tareas conviene una temperatura alta y para cuáles una baja?
- Añade 10 pares «pregunta | respuesta» de otro tema y mira si el modelo los aprende. ¿Qué responde a una pregunta que no está en el corpus, como «¿qué es la aceleración de la luz?»?
- ¿Por qué puede decir algo falso con seguridad? ¿Cómo comprobarías lo que dice una IA como un científico, con evidencias verificables?
- Compara este mini-LLM con el compositor de música con IA, que usa una cadena de Markov: ¿qué ve cada modelo del contexto?
- Debate: ¿entiende un LLM lo que dice? Defiende las dos posturas.
Retos
- Reto 1: entrena el modelo hasta que conteste bien a las cinco preguntas de ejemplo.
- Reto 2: busca una pregunta con la que el modelo diga algo falso con aplomo y explica por qué.
- Reto 3: enséñale tus propias frases (una vez metidas, se estudian tres veces más) y comprueba que las contesta.
- Reto 4: abre el archivo y cambia el tamaño de la ventana de contexto (N) o de los vectores (D). ¿Qué pasa con el error?
- Reto 5: compara este modelo con el clasificador de mensajes de acoso escolar: uno clasifica y el otro genera. ¿Qué tienen en común?
- Reto 6: escribe en Python un softmax y una elección con temperatura.
Qué hemos aprendido
Un LLM es una función matemática enorme que convierte texto en números, los mezcla con atención y capas de neuronas, y devuelve probabilidades. Se ajusta leyendo muchísimo texto y no hay nada mágico: hay ingeniería, matemáticas y mucha escala.
Y lo más importante: sabiendo cómo funciona, sabes también cuándo no fiarte. El Lince lo tiene claro: ya no quiere una bola de cristal, quiere entender la suya. Puedes ver todos los chismes del Lince en el índice.
Prototipo educativo: un mini-LLM de juguete que solo conoce sus frases. No sirve para consultar información.

También te puede interesar
Tipos de eventos en una app: chisme 88 del Lince