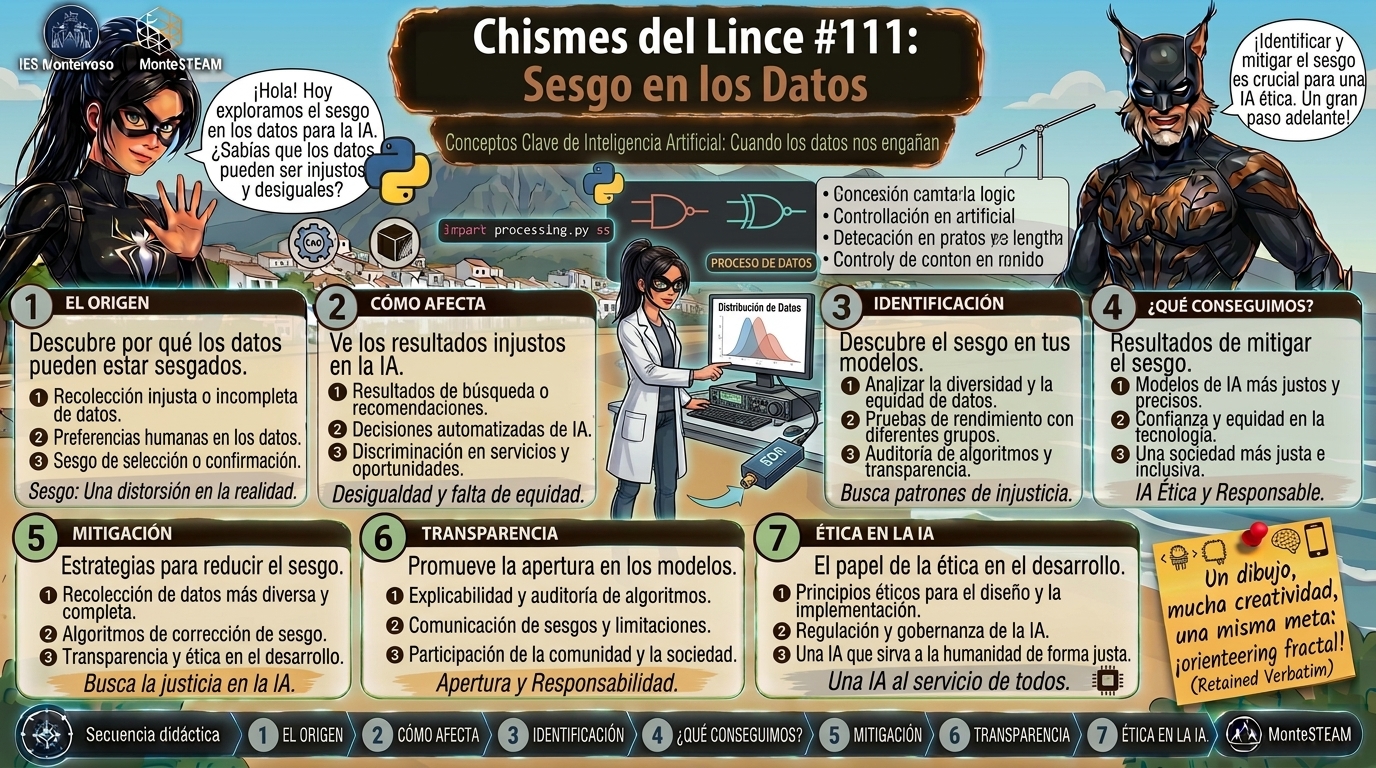
Chisme 111 del Lince: sesgo en los datos, el poder de enseñar a la IA
Noche en la cueva del Lince de la Noche. El Lince presume ante la Gata Montesa: «He entrenado a CABRA con todas las palabras que tenía a mano en la cueva: animales y comida». La Gata le enseña una lista nueva: «camión, patinete, avión». CABRA responde: «comida, comida, comida». El Lince palidece. «¿Se ha vuelto loca?». La Gata niega con la cabeza: «No. Solo ha visto lo que le enseñaste. En tu cueva no hay vehículos».
Introducción: sesgo en los datos
En el chisme 110, la IA clasificaba palabras nuevas mirando a sus vecinas más cercanas. Funcionaba muy bien, pero había una condición escondida: la IA tenía ejemplos de los cuatro grupos. ¿Qué pasa si no los tiene? En este chisme eliges tú con qué ejemplos aprende la IA y ves cómo cambia lo que acierta.
Por qué este chisme
Se habla mucho de que las IA pueden ser injustas. La causa más habitual no es que el programa sea «malo», sino que los datos con los que aprendió estaban incompletos o desequilibrados. A eso se le llama sesgo en los datos: favorecer cierta información sobre otra, normalmente sin querer.
Cómo funciona
Usamos exactamente el clasificador del chisme 110 (k = 3, es decir, la IA mira a las 3 vecinas más cercanas). Lo único que cambia es esto:
- Tú eliges con cuáles de las 24 palabras aprende la IA. Son sus «ejemplos de entrenamiento».
- Después, la IA hace un examen: 12 palabras nuevas que no ha visto nunca, 3 de cada grupo (animal, comida, lugar y vehículo).
- Comparamos lo que dice la IA con la respuesta real y calculamos el acierto: en total y por grupo.
Construcción
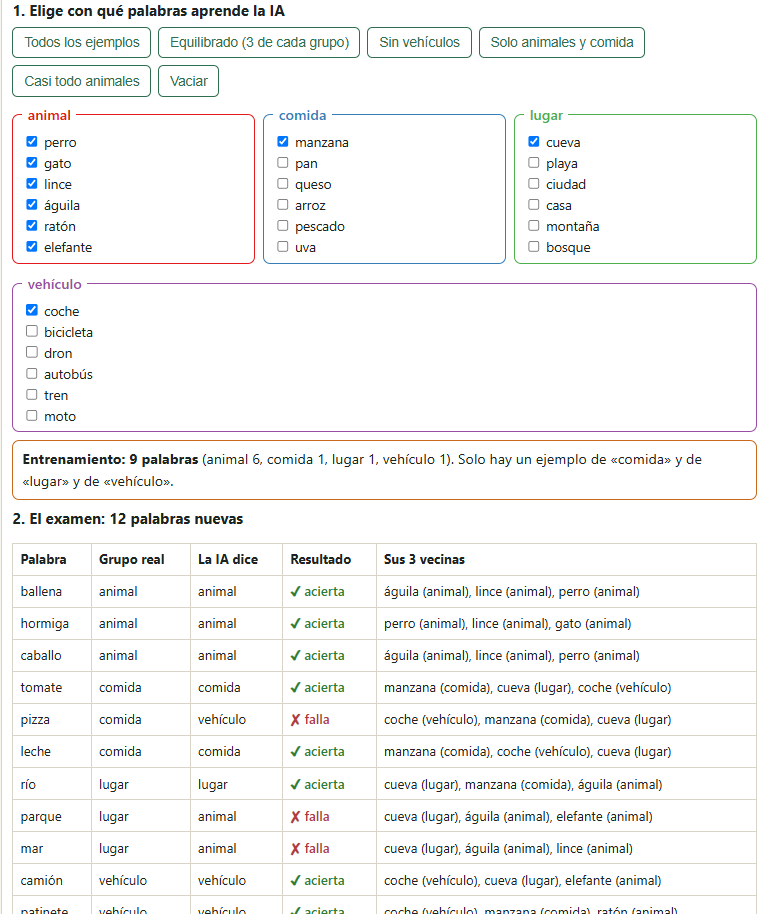
Abre el simulador en montesteam.org/app/chisme111-sesgo-datos.html. Tiene tres partes, de arriba abajo: las casillas con las palabras de entrenamiento, la tabla del examen con las 12 palabras nuevas, y el resultado con el acierto total y el de cada grupo. No hay botón de calcular: cada vez que cambias algo, el examen se repite solo.
Paso a paso
- Con todos los ejemplos. Pulsa «Todos los ejemplos». La IA acierta 12 de 12 (100 %). Con ejemplos de todo, lo hace bien.
- Con pocos ejemplos, pero repartidos. Pulsa «Equilibrado (3 de cada grupo)». Acierta 11 de 12 (92 %); falla «pizza». Con menos ejemplos puede fallar, pero los fallos son pocos y no se concentran en un grupo.
- Sin vehículos. Pulsa «Sin vehículos». El acierto total es 9 de 12 (75 %), que no parece tan malo. Pero los vehículos tienen 0 %: «camión», «patinete» y «avión» salen como «lugar» o «comida». La IA no puede decir «vehículo» porque nunca ha visto ninguno. El acierto total esconde que a un grupo entero le va fatal.
- Solo animales y comida (la cueva del Lince). Pulsa «Solo animales y comida». El acierto baja a 6 de 12 (50 %): animales y comida al 100 %, lugares y vehículos al 0 %. Es el caso de la escena.
- Casi todo animales. Pulsa «Casi todo animales». Acierta 9 de 12 (75 %). Los vehículos aciertan con un solo ejemplo («coche»), pero «mar» y «parque» salen como «animal» y «pizza» como «vehículo». Tener un ejemplo no siempre basta: depende de cuánto se parezcan los demás a ese ejemplo.
- Prueba tú. Pulsa «Vaciar» y marca las casillas. Misión A: el acierto más alto con solo 6 palabras. Misión B: un entrenamiento que haga fallar a un grupo entero pero deje el total por encima del 70 %.
El código en Python
El mismo experimento con muy pocas palabras. Cópialo y pruébalo:
import math
from collections import Counter

def clasificar(nueva, datos, k):
    # ordenar las palabras conocidas por distancia y votar
    cercanas = sorted(datos, key=lambda d: math.dist(nueva, d[0]))[:k]
    votos = Counter(grupo for _, grupo in cercanas)
    return votos.most_common(1)[0][0]

# [tamaño, tiene vida, es natural] y grupo
sin_vehiculos = [
    ([0.4, 1.0, 0.9], "animal"),   # perro
    ([0.3, 1.0, 0.6], "animal"),   # gato
    ([0.1, 0.0, 1.0], "comida"),   # manzana
    ([0.2, 0.0, 0.2], "comida"),   # pan
    ([0.8, 0.0, 1.0], "lugar"),    # cueva
]
con_vehiculos = sin_vehiculos + [
    ([0.6, 0.0, 0.0], "vehículo"), # coche
    ([0.3, 0.0, 0.0], "vehículo"), # bicicleta
]

camion = [0.8, 0.0, 0.0]
print(clasificar(camion, sin_vehiculos, 3))   # sale: comida
print(clasificar(camion, con_vehiculos, 3))   # sale: vehículo
El programa es el mismo y la palabra a clasificar también. Solo cambian los ejemplos con los que aprende, y por eso cambia la respuesta.
Aviso importante: las palabras y los vectores son inventados para que puedas leerlos. En la vida real los sesgos son más difíciles de ver, porque los datos son enormes y nadie los revisa uno a uno. Este simulador sirve para entender la idea, no para medir un sesgo real.
Qué estamos midiendo realmente
- Datos de entrenamiento: los ejemplos con los que la IA aprende. Aquí los elegimos nosotros.
- Acierto total y acierto por grupo: el total mezcla todos los casos. El acierto por grupo enseña dónde falla. Un total aceptable puede esconder un grupo con 0 %.
- Representatividad: unos datos son representativos si incluyen de todo lo que la IA se va a encontrar después. Si no, se equivocará con lo que nunca vio.
- El fallo está en los datos, no en el algoritmo: el programa es el mismo en todas las pruebas. Lo que cambia son los ejemplos.
- Sesgo no es lo mismo que mala intención: el Lince no quería engañar a CABRA. Simplemente usó lo que tenía a mano.
Para el aula
- ¿Qué «vehículos» o «lugares» faltan en los datos de una IA entrenada solo con lo que hay en tu casa? ¿Y en la cueva del Lince?
- Si un proyecto de ciencia ciudadana recoge datos solo en un barrio, ¿qué conclusiones serían fiables y cuáles no?
- Un sistema de IA acierta el 90 % en total. ¿Qué otra información pedirías antes de fiarte de él?
- ¿Cómo comprobarías que los datos de entrenamiento de una IA son representativos?
Retos
- Haz que funcione. Repite los pasos 1 a 5 y anota el acierto total y el de cada grupo en una tabla.
- Busca el menor entrenamiento. ¿Cuál es el menor número de palabras con el que la IA acierta 10 de 12?
- Cambia el código. En Python, añade una palabra de «lugar» y comprueba si cambia el resultado del camión.
- Diseña un sesgo. Elige un conjunto de entrenamiento que haga que la IA confunda «mar» con «animal» y explica por qué ocurre.
Qué hemos aprendido
Una IA solo conoce lo que le enseñamos. Si los datos de entrenamiento dejan fuera un grupo, la IA fallará con ese grupo, aunque el programa sea perfecto. Y el acierto total puede esconder el problema, por eso hay que mirar el acierto por grupo. Detrás de muchas «IA injustas» hay datos incompletos, no un programa con mala intención.
Para seguir investigando
- Chisme 110: el vecino más cercano, el clasificador que usamos aquí.
- Chisme 109: el mapa de las palabras, de donde salen los vectores.
- Chisme 81: cómo funciona un LLM, para ver dónde entran los datos de entrenamiento en un modelo grande.
- Qué es el sesgo algorítmico: explicación de DataCamp.
Etiqueta:#AIDARAC, #IESMonterroso, #MONTESTEAM

También te puede interesar
Chisme 114 del lince: sensor ultrasónico, el sonar de Justicia Ciega
Chisme 113 del Lince: led esp32, el Lince enciende una baliza