Chisme 110 del Lince: vecino más cercano kNN, clasificación clara
Noche en la cueva del Lince de la Noche. El Lince de la Noche tiene una lista de palabras nuevas que CABRA todavía no conoce: «ballena», «tomate», «camión». Quiere que la IA diga a qué grupo pertenece cada una. «Fácil», dice. «Que mire qué palabras conoce y elija la misma clase». La Gata Montesa levanta una ceja: «¿Y si la palabra más parecida es un ratón con cara de perro?». El Lince se queda mirando la pantalla. «Pues miramos a más vecinos». Vecino más cercano kNN.
Introducción: vecino más cercano kNN
En el chisme 109 aprendimos a medir la distancia entre palabras. Ahora usamos esa distancia para clasificar: dada una palabra nueva, la IA busca las palabras conocidas más cercanas y decide su grupo según lo que votan sus vecinas. Este método se llama k vecinos más cercanos, o kNN (de k-nearest neighbors).
Por qué este chisme
Hasta ahora hemos agrupado sin respuestas (chismes 106 y 108). Aquí el ordenador sí tiene respuestas: sabe a qué grupo pertenece cada palabra conocida, y aprende a decidir el grupo de una nueva. Es la base de la clasificación supervisada, la misma idea que el reconocimiento de imágenes o de voz, pero en su versión más sencilla.
Cómo funciona
- Tenemos palabras conocidas, cada una con sus tres números y su grupo (animal, comida, lugar o vehículo).
- Llega una palabra nueva con sus tres números.
- Medimos la distancia de la nueva a todas las conocidas y nos quedamos con las k más cercanas.
- Cada una de esas vecinas «vota» su grupo. Gana el grupo con más votos.
El número k lo elegimos nosotros. Con k = 1, la palabra toma el grupo de su vecina más cercana, aunque esa vecina sea un error. Con k más grande, pesan más vecinas y el resultado se suaviza, pero si k es demasiado grande, las vecinas pueden ser de grupos muy distintos y la decisión se vuelve borrosa.
Construcción
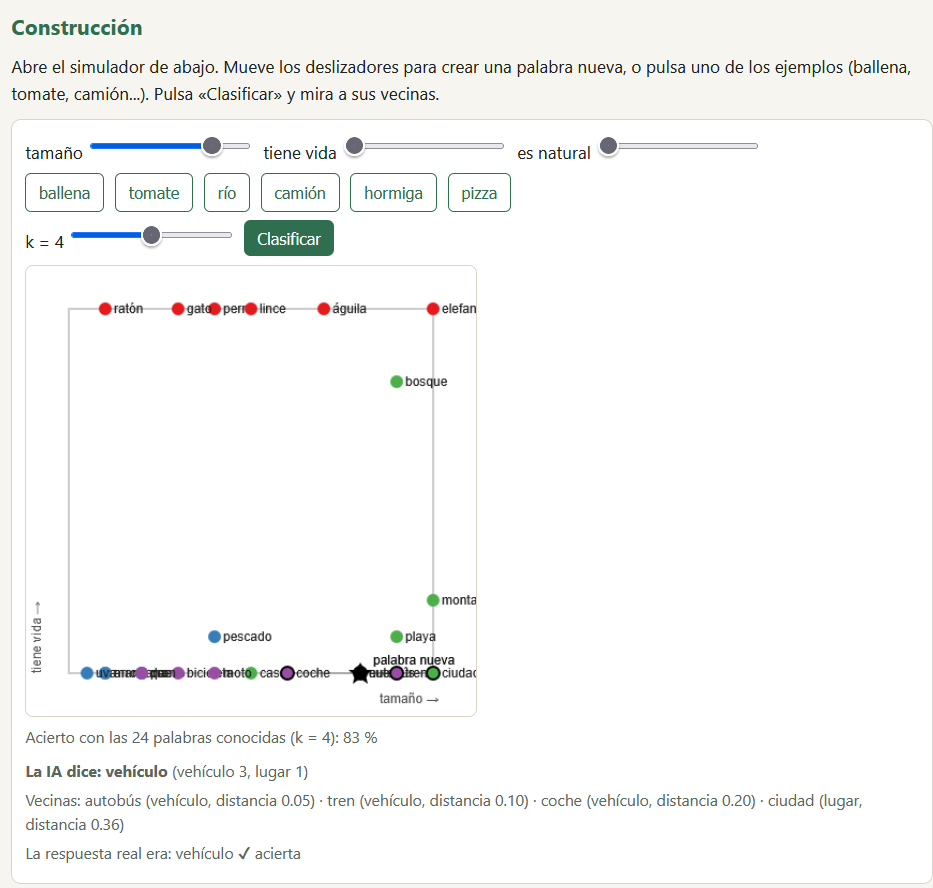
Abre el simulador en montesteam.org/app/chisme110-knn-vecino-cercano.html. Verás un mapa 2D y otro 3D: cada punto es una palabra conocida, la estrella es la palabra nueva y las líneas unen la estrella con sus vecinas. Puedes crear tu propia palabra con los deslizadores o pulsar uno de los ejemplos (ballena, tomate, camión…) y comprobar si la IA acierta.
El código en Python
Este es el mismo método en Python con cinco palabras conocidas, para que puedas ver cada paso. Cópialo y pruébalo:
import math
from collections import Counter

# palabras conocidas: [tamaño, tiene vida, es natural] y su grupo
conocidas = [
    ([0.4, 1.0, 0.9], "animal"),    # perro
    ([0.3, 1.0, 0.6], "animal"),    # gato
    ([1.0, 0.0, 0.3], "lugar"),     # ciudad
    ([0.6, 0.0, 0.0], "vehículo"),  # coche
    ([0.1, 0.0, 1.0], "comida"),    # manzana
]

def clasificar(nueva, datos, k):
    # 1. ordenar las palabras conocidas por distancia a la nueva
    cercanas = sorted(datos, key=lambda d: math.dist(nueva, d[0]))[:k]
    # 2. contar los votos de las k vecinas
    votos = Counter(grupo for _, grupo in cercanas)
    return votos.most_common(1)[0][0]

ballena = [0.9, 1.0, 1.0]
print(clasificar(ballena, conocidas, 3))
Lo que hace el programa es lo mismo que el simulador: mide, ordena y vota. No sabe qué es una ballena; solo sabe qué números se parecen a los de las palabras que ya conoce.
Cómo probarlo
- Clasifica la ballena con k = 3 y después con k = 7. ¿Cambia el resultado?
- Busca un valor de k que dé el mayor porcentaje de acierto. ¿Coincide con tu intuición?
- Crea una palabra que esté justo entre dos grupos. ¿Qué pasa con k par? ¿Qué regla usa el programa cuando hay empate?
Qué estamos midiendo realmente
- Clasificación supervisada: cada palabra conocida viene con su respuesta (su grupo). Eso la diferencia del aprendizaje sin etiquetas de los chismes 106 y 108.
- Acierto: es la proporción de palabras que el método clasifica bien. Para medirlo sin trampa, cada palabra se compara con sus vecinas, sin contarse a sí misma.
- Elección de k: si k es demasiado pequeño, el resultado depende de una sola vecina, que puede ser un error. Si es demasiado grande, se mezclan grupos distintos. Elegir k es una decisión humana que hay que comprobar.
- Empates: con k par, dos grupos pueden tener los mismos votos. Hay que decidir una regla, y esa regla también influye en el resultado.
Aviso importante: las palabras y los vectores son inventados para que puedas leerlos. Un clasificador real se entrena con muchos más ejemplos, con muchas más características, y casi nunca usa solo tres.
Para el aula
- ¿Qué pasaría si cambiáramos la unidad de «tamaño» de metros a centímetros? ¿Cambiaría el vecino más cercano?
- Si el método acierta casi siempre con las palabras conocidas, ¿significa que acertará con cualquier palabra nueva? ¿Por qué no?
- ¿Cómo elegirías k en un problema real sin mirar el resultado final? ¿Qué datos reservarías para comprobarlo?
Retos
- Haz que funcione. Clasifica las seis palabras de ejemplo con k = 3 y anota cuáles aciertan.
- Mide el acierto por k. Anota el porcentaje para k de 1 a 7 y dibuja la gráfica en papel.
- Añade ejemplos. Escribe cinco palabras nuevas con sus tres números y su grupo en el código de Python, y comprueba si el resultado cambia.
- Busca el caso difícil. Crea una palabra que el método clasifique mal y explica por qué la confunde.
Qué hemos aprendido
Para clasificar una palabra nueva basta con mirar a sus vecinas más cercanas y dejar que voten. Es un método sencillo y fácil de explicar, pero depende de tres decisiones humanas: qué características usamos, cómo medimos la distancia y cuántas vecinas miramos. Por eso una clasificación siempre hay que comprobarla antes de creerla.
Para seguir investigando
- Chisme 109: el mapa de las palabras, de donde salen los vectores de este chisme.
- Chisme 106: agrupar colores sin etiquetas, el mismo problema de distancias pero sin respuestas.
- Qué es el algoritmo kNN: explicación de Elastic.
Etiqueta:#AIDARAC, #IESMonterroso, #MONTESTEAM, ia, vecino más cercano knn

También te puede interesar
Chisme 114 del lince: sensor ultrasónico, el sonar de Justicia Ciega
Chisme 113 del Lince: led esp32, el Lince enciende una baliza