Chisme 109 del Lince: word embeddings, el mapa ingenioso de las palabras
Noche en la cueva del Lince de la Noche. CABRA, su IA, lleva toda la tarde leyendo palabras. El Lince le pregunta: «¿Sabes que “perro” y “gato” se parecen más que “perro” y “playa”?». CABRA responde sin dudar. La Gata Montesa, que no se fía de nada, pregunta: «¿Y cómo lo sabe? Un ordenador no sabe lo que es un perro». El Lince se queda pensando. «Pues sabrá algo», dice. La Gata sonríe: «Vamos a verlo». Vamos a usar word embeddings.
Introducción
En el chisme 81 vimos cómo funciona un modelo de lenguaje por dentro. Allí apareció una idea clave: cada palabra, o cada trozo de palabra, se convierte en una lista de números. A esa lista se le llama vector, y cuando un modelo aprende esos números para cada palabra, hablamos de word embeddings, o incrustaciones de palabras. Aquí los vemos con calma, en un mapa que puedes girar.
Por qué este chisme
Un ordenador no entiende lo que es un perro. Lo único que maneja son números. Si queremos que trate las palabras de forma útil, tenemos que convertirlas en números de forma que las parecidas queden cerca. Ese es el truco: el significado se convierte en distancia. Por eso este chisme amplía el 81: aquí puedes ver el mapa sin entrenar nada.
Cómo funciona
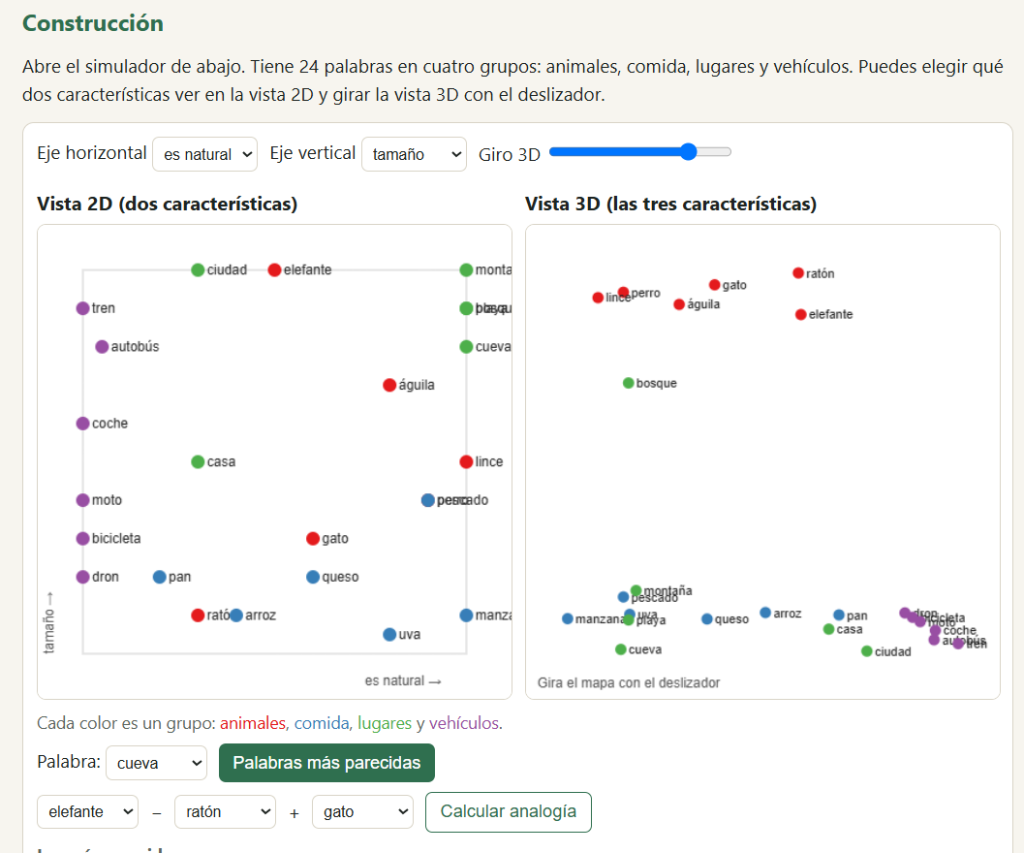
Cada palabra tiene tres números, uno por característica. En el simulador usamos tres características inventadas: tamaño (de pequeño a grande), tiene vida (no vive o vive) y es natural (hecho por personas o existente en la naturaleza). Con esos tres números, cada palabra es un punto en un espacio de tres dimensiones.
Para decir si dos palabras se parecen, medimos la distancia entre sus puntos: cuanto más corta, más parecidas. Es la misma idea que medir la distancia entre dos puntos en un mapa, pero con tres ejes en lugar de dos.
También podemos hacer operaciones con los vectores. Si restamos y sumamos, obtenemos un nuevo punto y buscamos qué palabra queda cerca de él. Así se hacen las analogías: «perro es a cachorro como gato es a…».
Qué necesitamos
- Un navegador (Chrome o Edge).
- Papel, para anotar las palabras más parecidas que encuentres.
Construcción
Abre el simulador en montesteam.org/app/chisme109-word-embeddings.html. Tiene 24 palabras en cuatro grupos (animales, comida, lugares y vehículos), una vista en 2D donde eliges las dos características y una vista 3D que puedes girar. Hay botones para ver las palabras más parecidas a una dada y para calcular una analogía.
El código en Python
Lo que hace el simulador en JavaScript también se puede hacer en Python en pocas líneas. Copia este código en un programa de Python y pruébalo:
import math

# tamaño, tiene vida, es natural
perro = [0.4, 1.0, 0.9]
gato  = [0.3, 1.0, 0.6]
lince = [0.5, 1.0, 1.0]
coche = [0.6, 0.0, 0.0]

# math.dist calcula la distancia entre dos puntos en el espacio
print(round(math.dist(perro, gato), 2))   # animales: distancia corta
print(round(math.dist(perro, lince), 2))  # animales: distancia corta
print(round(math.dist(perro, coche), 2))  # animal frente a vehículo: distancia larga
Lo importante no es el código, sino la idea: el programa no sabe qué es un perro. Solo compara números. Si los números están bien elegidos, el resultado parece inteligente.
Cómo probarlo
- Busca tres palabras que consideres «parecidas» y comprueba en el simulador si lo son según los vectores.
- Busca una palabra que salga cerca de otra que no esperabas. ¿Qué característica compartida explica la cercanía?
- Haz la analogía «elefante − ratón + gato». Sale «bosque», que no es un animal. ¿Por qué?
Qué estamos midiendo realmente
- Vector: lista de números que describe una palabra. Aquí tiene tres números; en un modelo real, cientos.
- Distancia: cuánto separa dos vectores. Cuanto menor, más parecidas son las palabras según ese mapa.
- Los números los elegimos nosotros: si cambiamos una característica, el mapa cambia. El significado que aparece depende de cómo hemos medido.
- Las analogías tienen límites: operar con números no garantiza un resultado con sentido.
Aviso importante: los vectores de este chisme son inventados, para que puedas leerlos. Un modelo real usa cientos de números por palabra y los aprende de enormes cantidades de texto. Sirve para entender la idea, no para hacer predicciones serias.
Para el aula
- ¿Qué característica falta para separar mejor «lince» de «perro»? ¿Cómo la medirías?
- Si el mapa dice que «ciudad» y «tren» están muy cerca, ¿qué ha salido mal? ¿Qué pasa si las características están mal elegidas?
- Un modelo de lenguaje real aprende sus vectores leyendo textos. ¿Crees que aprender del texto basta para entender lo que es un perro? ¿Por qué?
Retos
- Haz que funcione. Busca las palabras más parecidas a «playa» y explica por qué salen esas.
- Cambia las características. Sustituye «tiene vida» por otra que elijas y mira cómo cambia el mapa.
- Añade palabras. Escribe cinco palabras nuevas con sus tres números en el código de Python y comprueba dónde quedan.
- Busca una analogía propia. Diseña una operación A − B + C que dé un resultado con sentido y explícala.
Qué hemos aprendido
Un ordenador no sabe lo que es un perro, pero puede saber qué palabras se parecen si las convertimos en números de forma inteligente. El significado se convierte en distancia, y esa distancia depende de cómo hemos medido. Es la base de cómo los modelos de lenguaje trabajan con las palabras, y también la razón por la que pueden equivocarse.
Para seguir investigando
- Chisme 81: cómo funciona un LLM, donde los vectores se ajustan dentro de un modelo entero.
- Chisme 106: agrupar colores sin etiquetas, con distancias en tres dimensiones.
- Qué son las incrustaciones de palabras: explicación de Elastic.
Etiqueta:#AIDARAC, #IESMonterroso, #MONTESTEAM

También te puede interesar
Chisme 114 del lince: sensor ultrasónico, el sonar de Justicia Ciega
Chisme 113 del Lince: led esp32, el Lince enciende una baliza