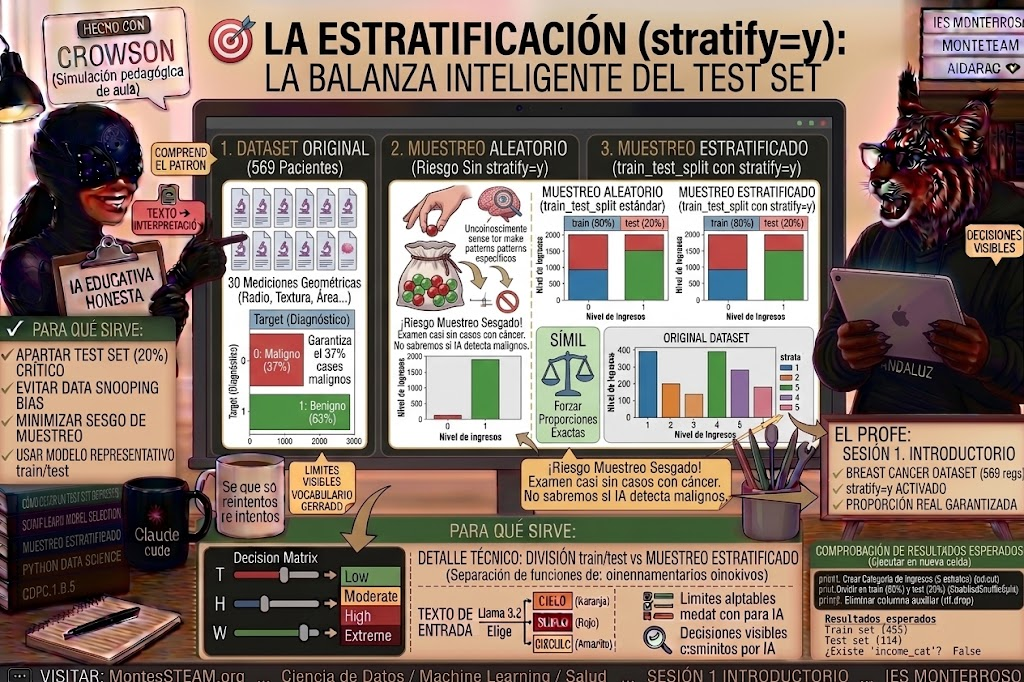
En este tutorial introductorio de Ciencia de Datos para MontesSTEAM e IES Monterroso, damos los primeros pasos en Machine Learning aplicado a la salud mediante el dataset real Breast Cancer Wisconsin. Aprende a instalar scikit-learn en JupyterLab, cargar datos médicos en memoria, reservar un conjunto de prueba para evaluar el modelo y comprender la importancia de la estratificación (stratify=y) para garantizar un reparto equilibrado entre tumores benignos y malignos.
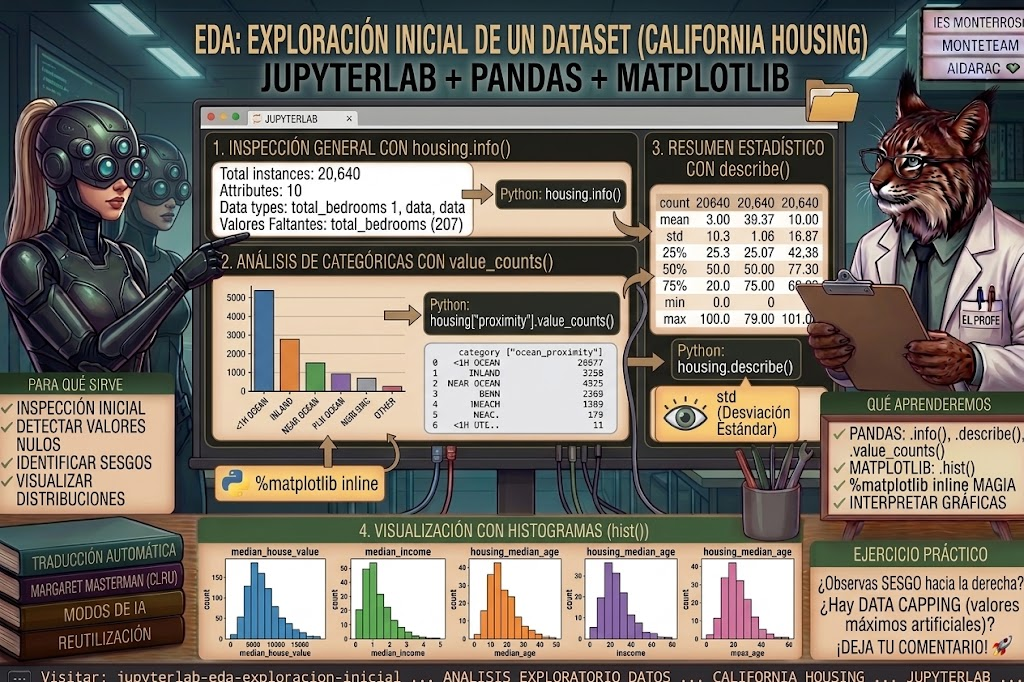
Este tutorial guía paso a paso al alumnado en la realización de un Análisis Exploratorio de Datos (EDA) inicial utilizando Python, Pandas y JupyterLab sobre el conjunto de datos California Housing. A través de métodos fundamentales como info(), value_counts(), describe() e hist(), los estudiantes aprenderán a identificar la estructura del dataset, detectar valores nulos, analizar variables categóricas, interpretar estadísticas descriptivas (como cuartiles y desviación estándar) y visualizar la distribución de los datos mediante histogramas con Matplotlib. Incluye un reto práctico final para afianzar los conceptos aprendidos.
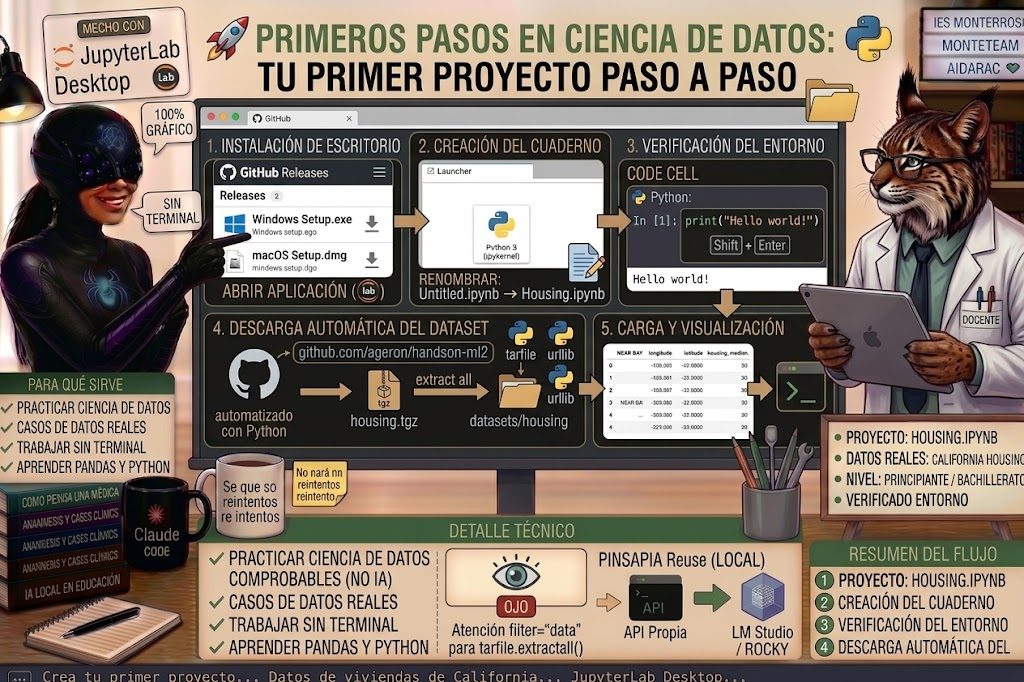
Aprende a configurar un entorno de Ciencia de Datos en local con JupyterLab Desktop de forma 100% visual y sin usar comandos de consola. Guía paso a paso para descargar y visualizar tu primer conjunto de datos real con Python y Pandas para proyectos de Inteligencia Artificial y pensamiento computacional.
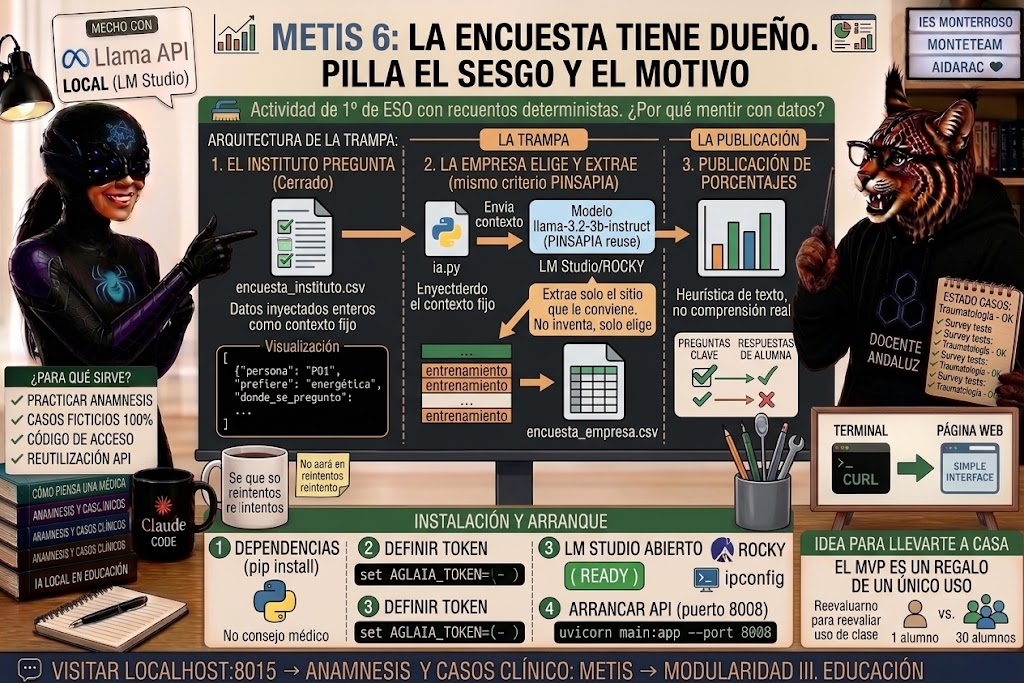
La actividad más simple de la serie METIS, para 1º de ESO: una empresa publica que el 75 % del instituto prefiere bebidas energéticas, y solo preguntó a las ocho personas que salían del entrenamiento. Ocho filas, veinte filas, dos columnas de palabras y cinco preguntas para no volver a creerse un porcentaje.
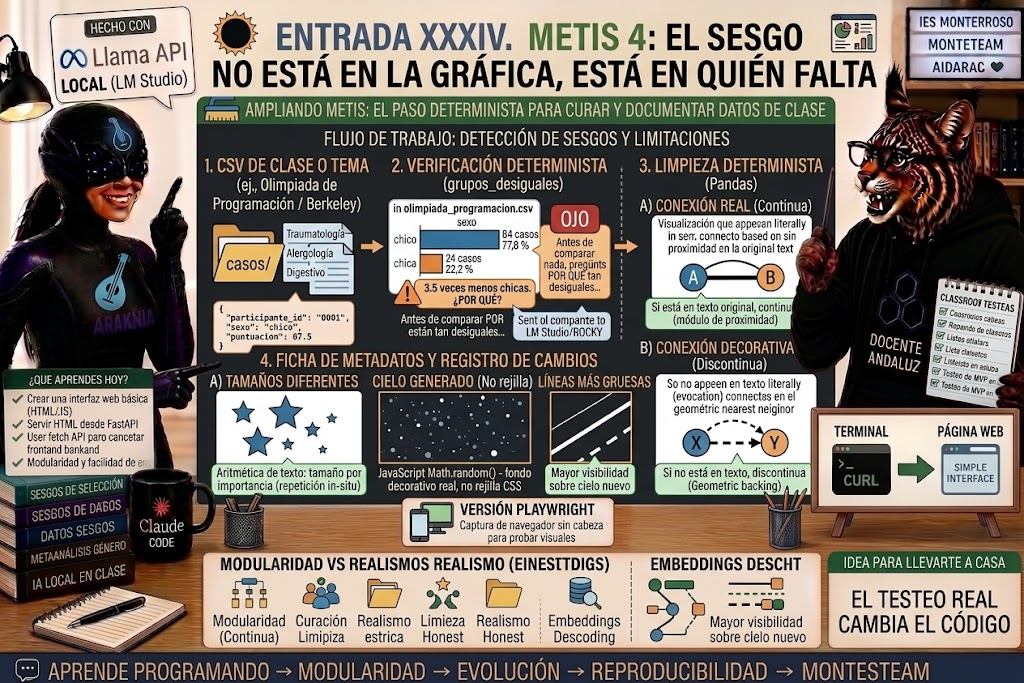
Cuarta entrega de METIS: un tipo de gráfica nuevo para contar cuánta gente hay en cada grupo y un aviso que pregunta por qué están tan desiguales. Con un ejercicio completo de aula sobre sesgo de selección —una olimpiada de programación con datos calibrados a las cifras reales de participación femenina en Informática— y la paradoja de Simpson en los datos reales de Berkeley 1973, incluida la conclusión de los autores que casi siempre se cita mal.
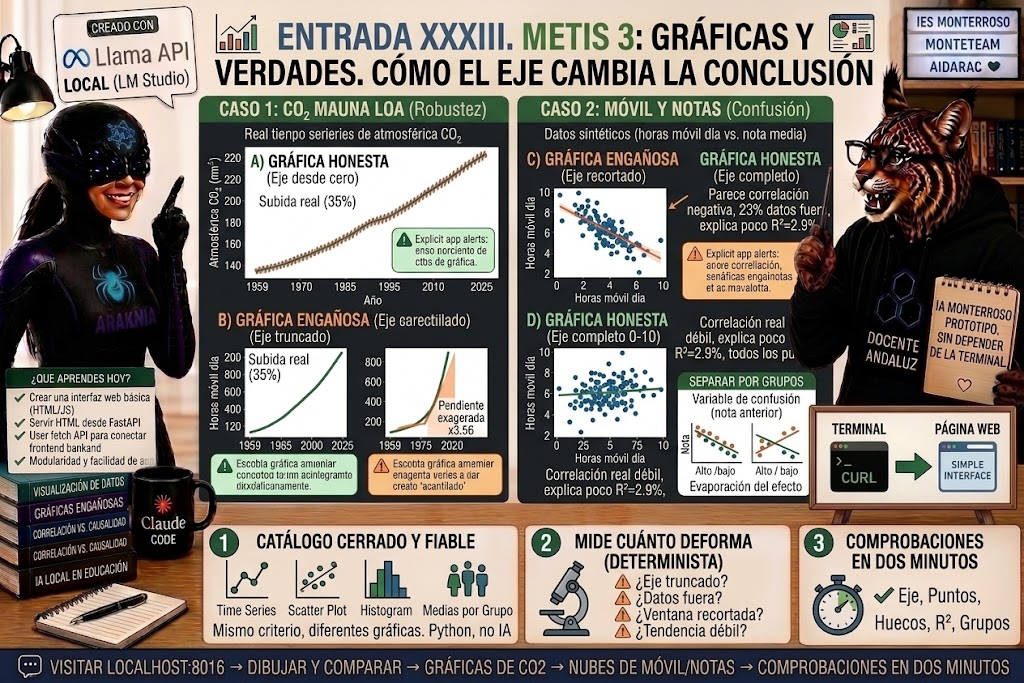
Tercera entrega de METIS: gráficas con matplotlib desde un catálogo cerrado, y avisos que miden con números exactos cuánto deforma cada opción del eje. Con un ejercicio completo de aula sobre dos conjuntos de datos —el CO₂ real de Mauna Loa y horas de móvil frente a notas— donde el mismo truco de gráfica da resultados opuestos.
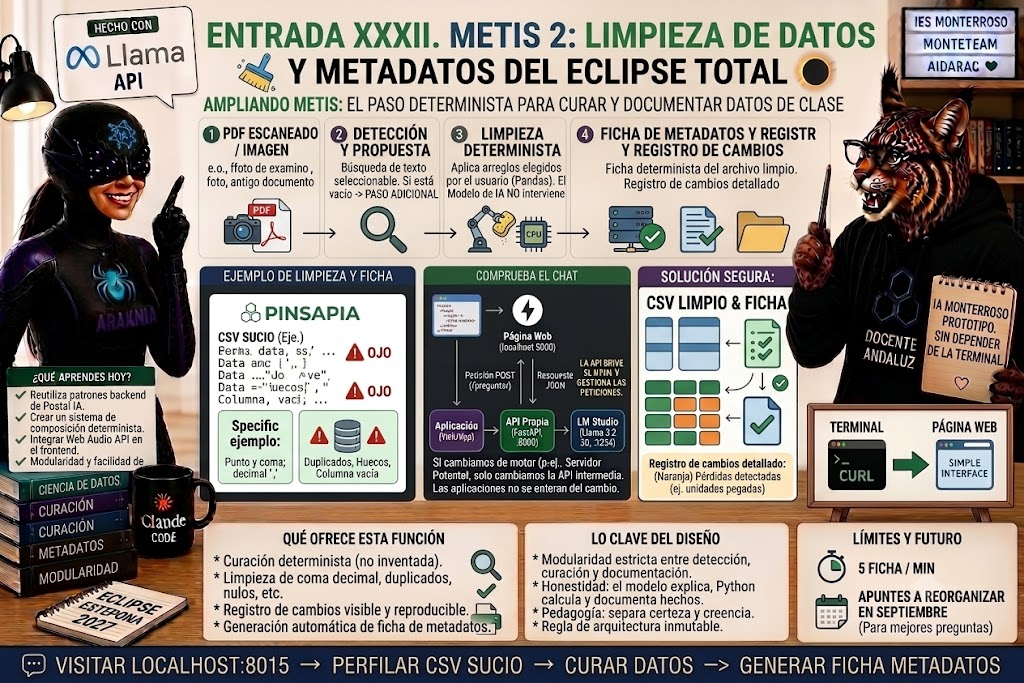
Segunda entrega de METIS: la herramienta pasa de detectar problemas a arreglarlos, con un registro de cambios que hace visible lo que se pierde, y genera la ficha de metadatos del archivo limpio. Con una práctica completa de principio a fin sobre datos del eclipse total del 2 de agosto de 2027 en Estepona.
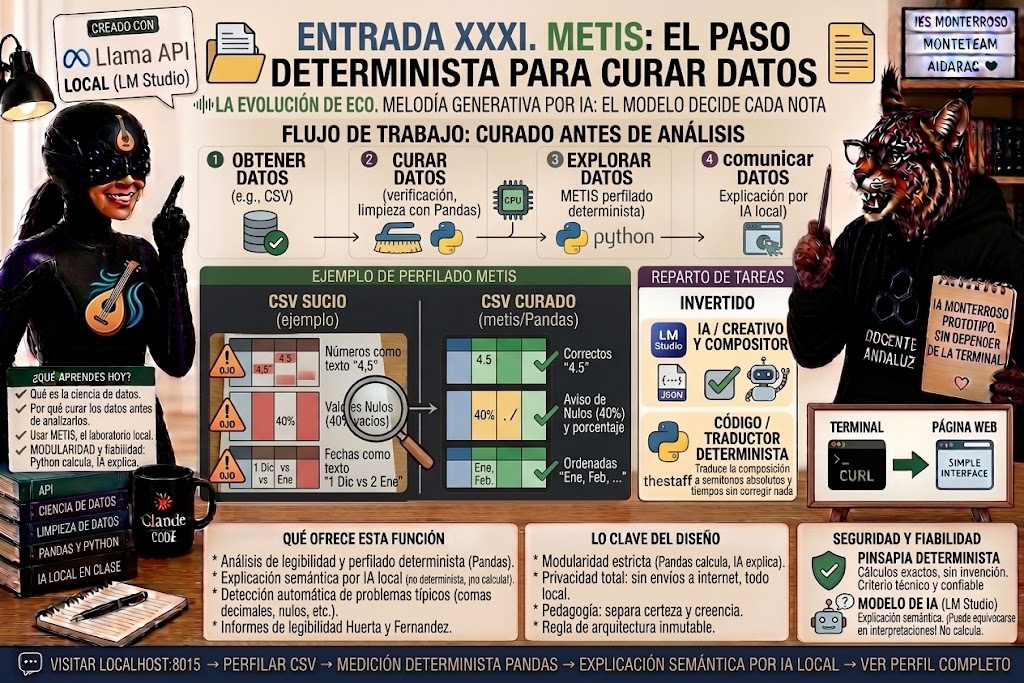
Tutorial completo para montar METIS, una aplicación web que analiza un CSV y te explica qué hay dentro con un modelo de IA local. Con una regla de fondo: los números los calcula Python, la IA solo los explica. Incluye qué es la ciencia de datos y por qué curar los datos es la parte más importante del trabajo.
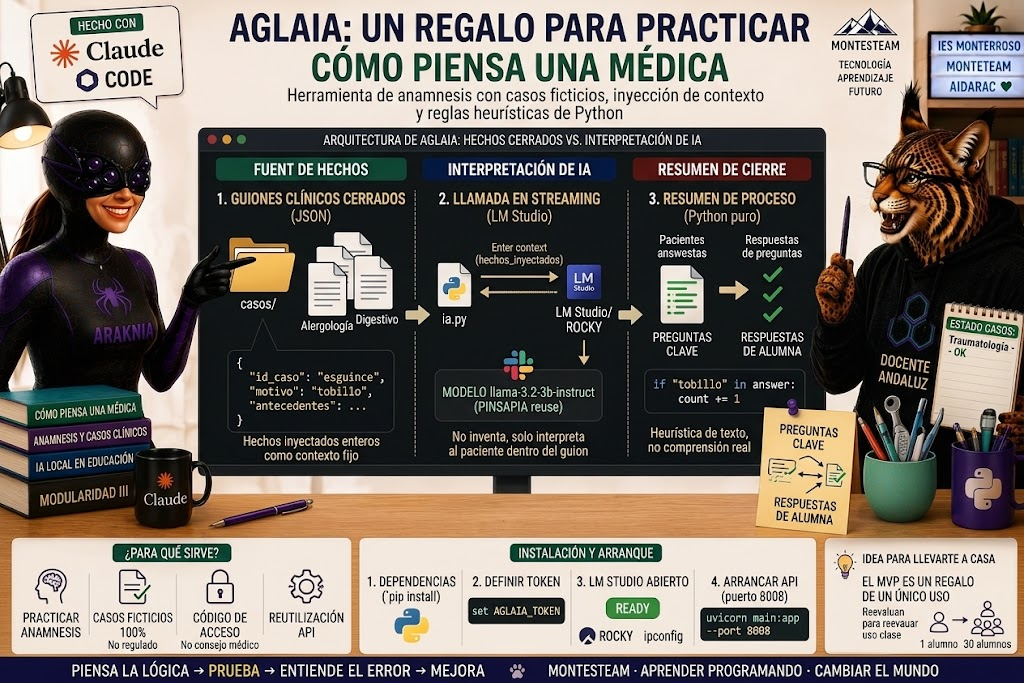
AGLAIA es un regalo para mi sobrina: una app que reutiliza el motor de PINSAPIA para practicar anamnesis con casos clínicos ficticios y una IA local en ROCKY.