En la Sesión 2 del taller CUTLER, el alumnado entrena su primer clasificador real — un árbol de decisión con scikit-learn — sobre datos médicos reales, sin escalar variables y midiendo su exactitud.
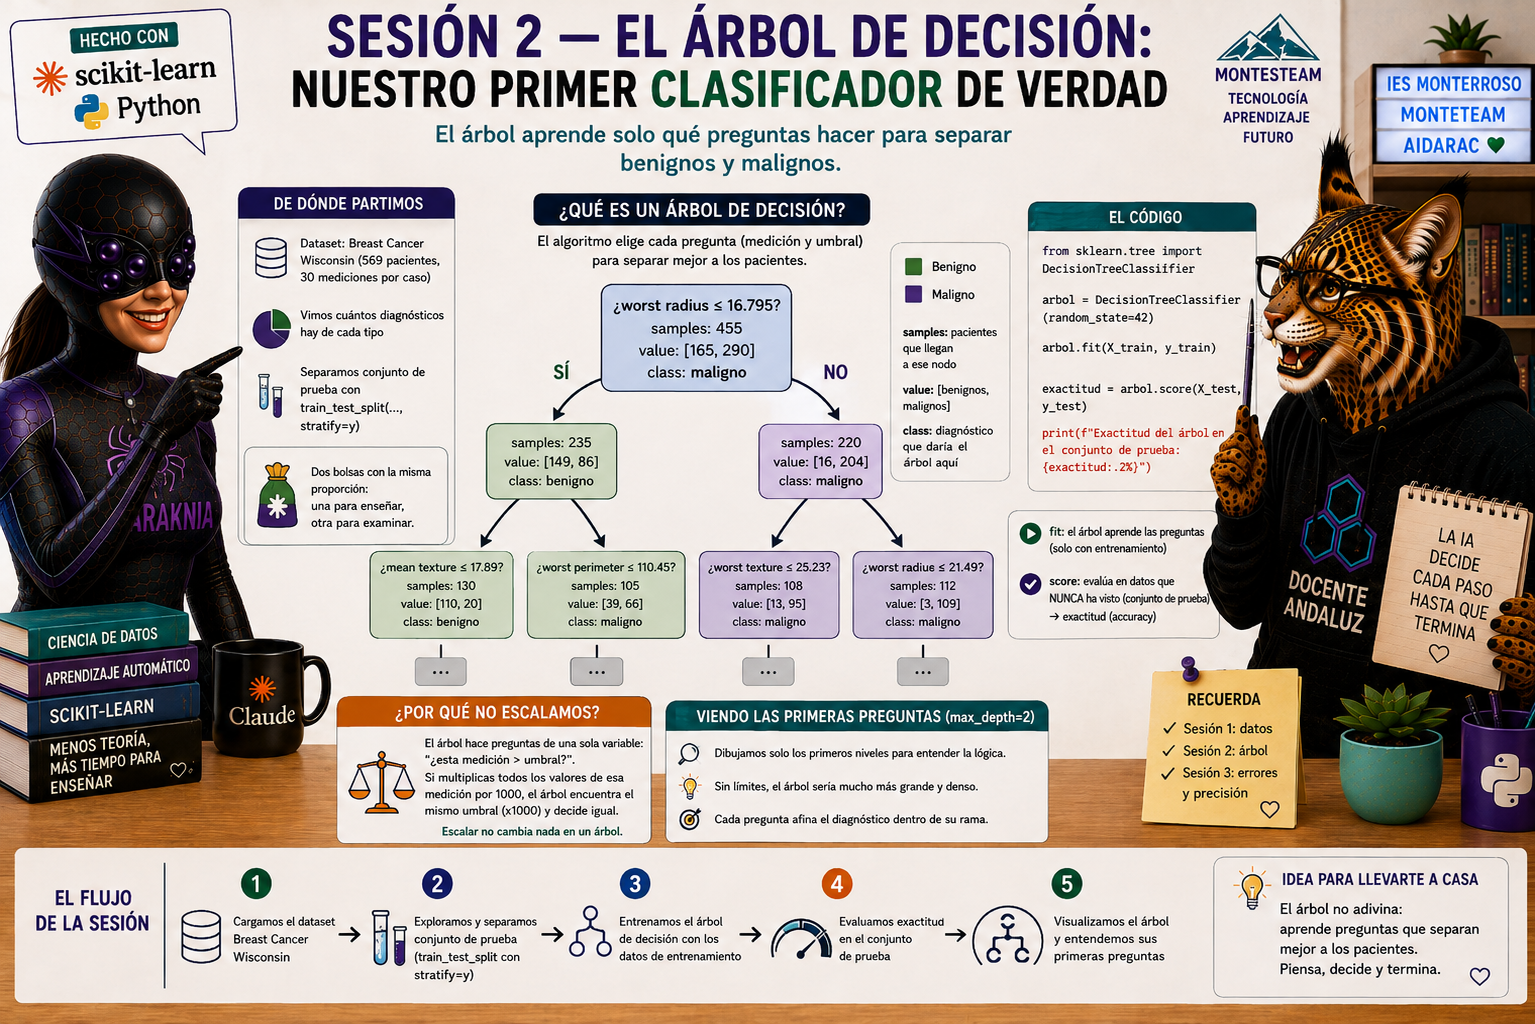

En la Sesión 2 del taller CUTLER, el alumnado entrena su primer clasificador real — un árbol de decisión con scikit-learn — sobre datos médicos reales, sin escalar variables y midiendo su exactitud.
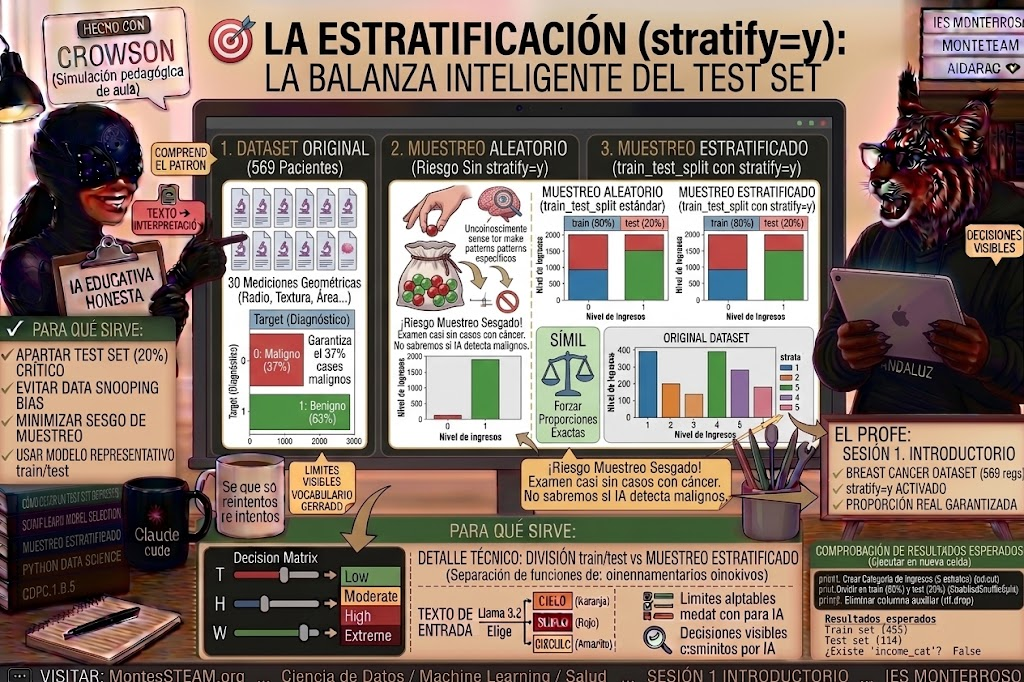
En este tutorial introductorio de Ciencia de Datos para MontesSTEAM e IES Monterroso, damos los primeros pasos en Machine Learning aplicado a la salud mediante el dataset real Breast Cancer Wisconsin. Aprende a instalar scikit-learn en JupyterLab, cargar datos médicos en memoria, reservar un conjunto de prueba para evaluar el modelo y comprender la importancia de la estratificación (stratify=y) para garantizar un reparto equilibrado entre tumores benignos y malignos.
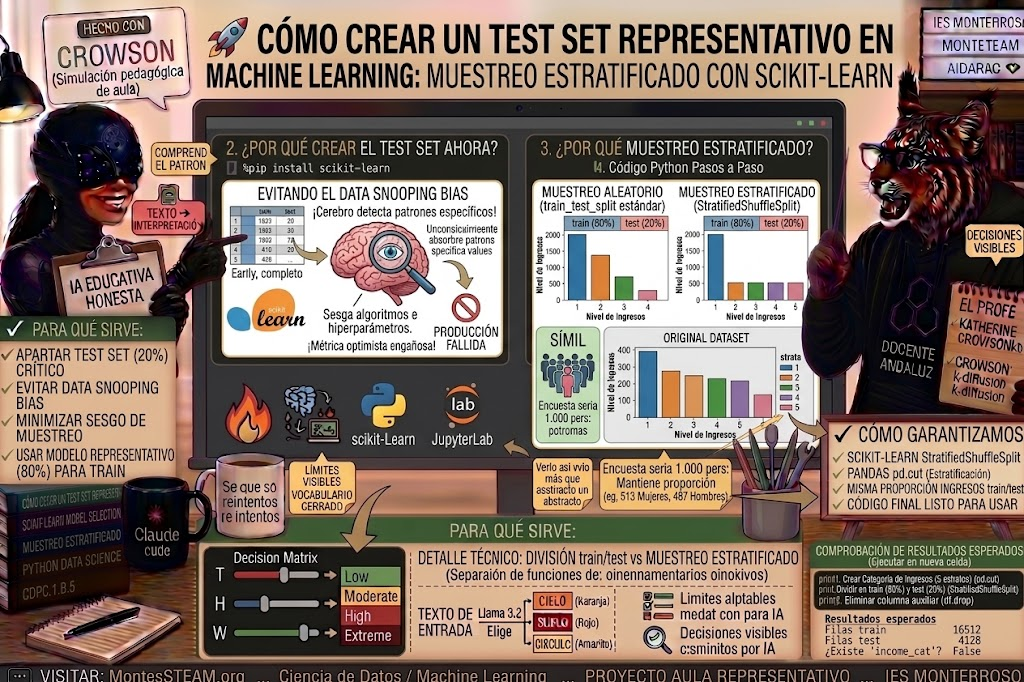
Publicado en: MontesSTEAM.org | Categoría: Ciencia de Datos / Machine Learning ¡Hola a todos y todas! En la entrega anterior aprendimos a inspeccionar el dataset de viviendas de California (California Housing Dataset) con Pandas. Antes de ponernos a entrenar modelos …
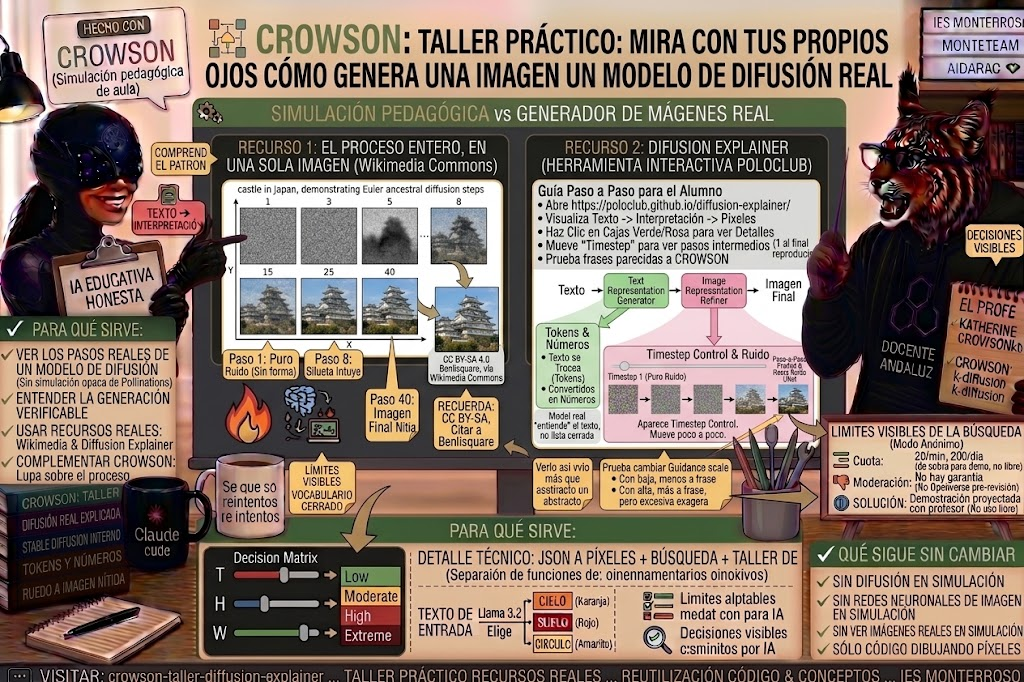
Un taller para que el alumnado vea, sin simulación de por medio, los pasos reales de un modelo de difusión — una imagen real de Wikimedia Commons que muestra el recorrido de ruido a imagen nítida, y Diffusion Explainer, una herramienta interactiva y gratuita para explorar ese mismo proceso paso a paso.
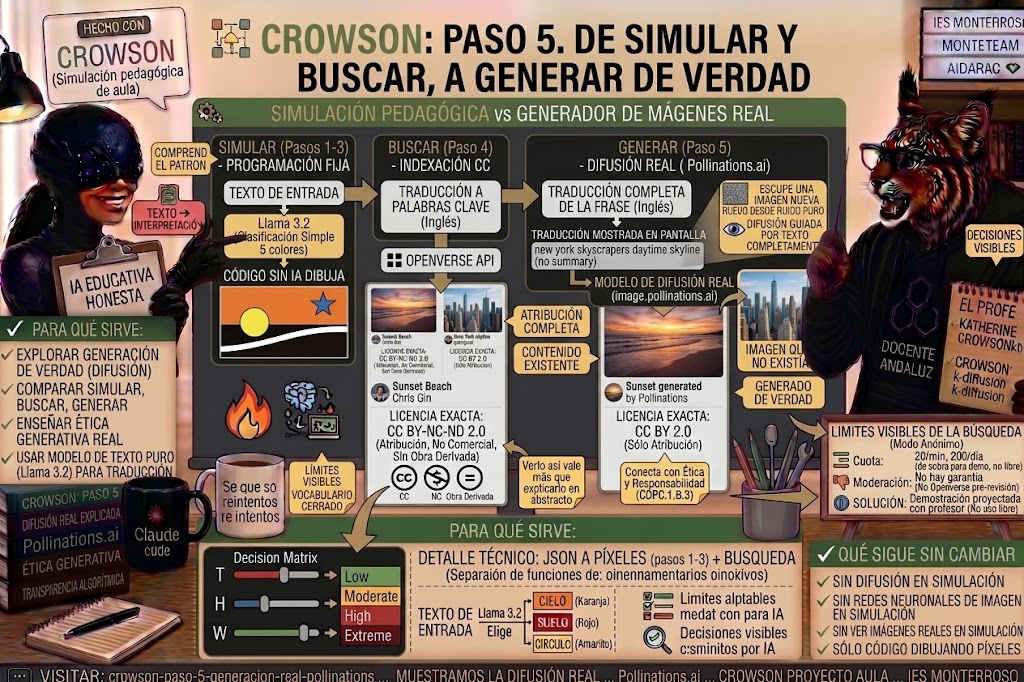
CROWSON añade un quinto nivel, distinto de simular y de buscar — Llama traduce la frase completa al inglés y esa traducción genera una imagen real con Pollinations.ai, un modelo de difusión de verdad, con los mismos avisos de honestidad y moderación de toda la familia.
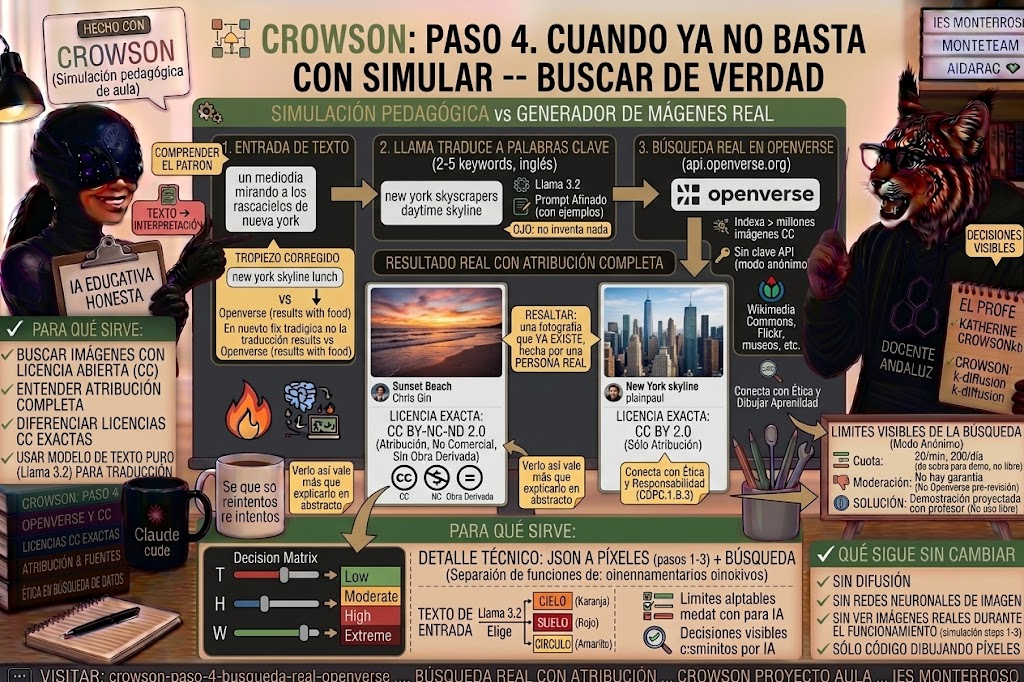
CROWSON añade un cuarto paso distinto de la simulación — Llama traduce la frase a palabras clave en inglés y busca de verdad en Openverse, con atribución completa y sin esconder sus límites (moderación, cuota de peticiones).
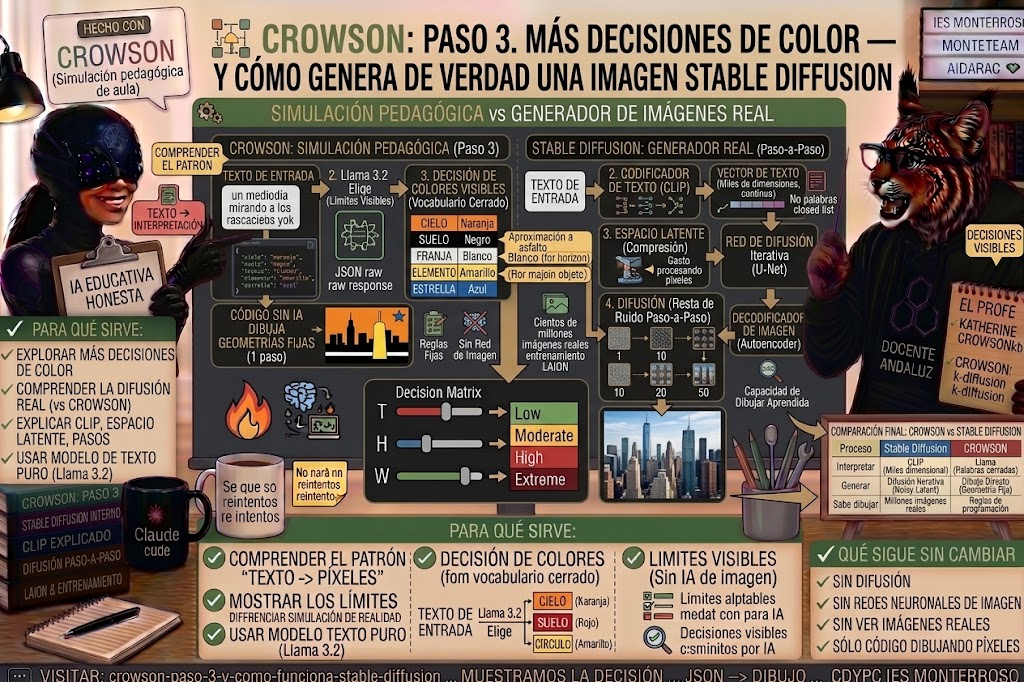
CROWSON amplía a cinco las decisiones de color de Llama (franja y estrella incluidas) — y esta entrada explica, paso a paso, cómo genera de verdad una imagen un modelo como Stable Diffusion (CLIP, espacio latente, difusión) frente a lo que hacemos aquí.
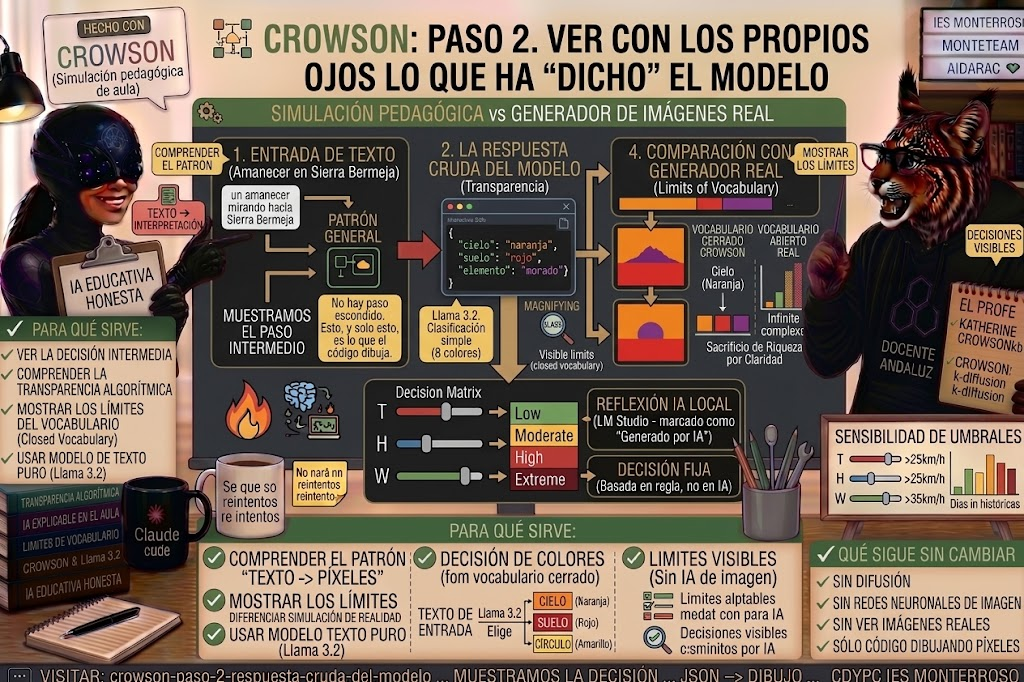
CROWSON muestra ahora, sin editar, la respuesta exacta que da Llama antes de convertirse en dibujo — el mismo principio de transparencia que ya aplicamos en MASTERMAN, aplicado aquí a la salida del modelo.
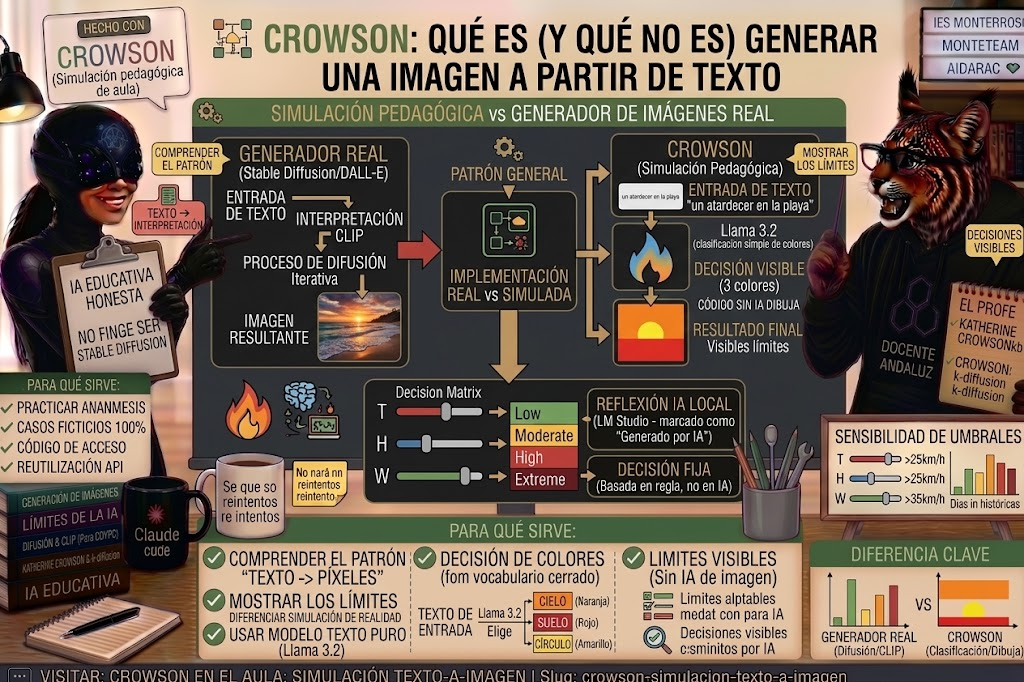
CROWSON simula el patrón “texto a imagen” con Llama eligiendo colores de una lista cerrada y código sin IA dibujándolos — sin fingir ser un generador real como Stable Diffusion.
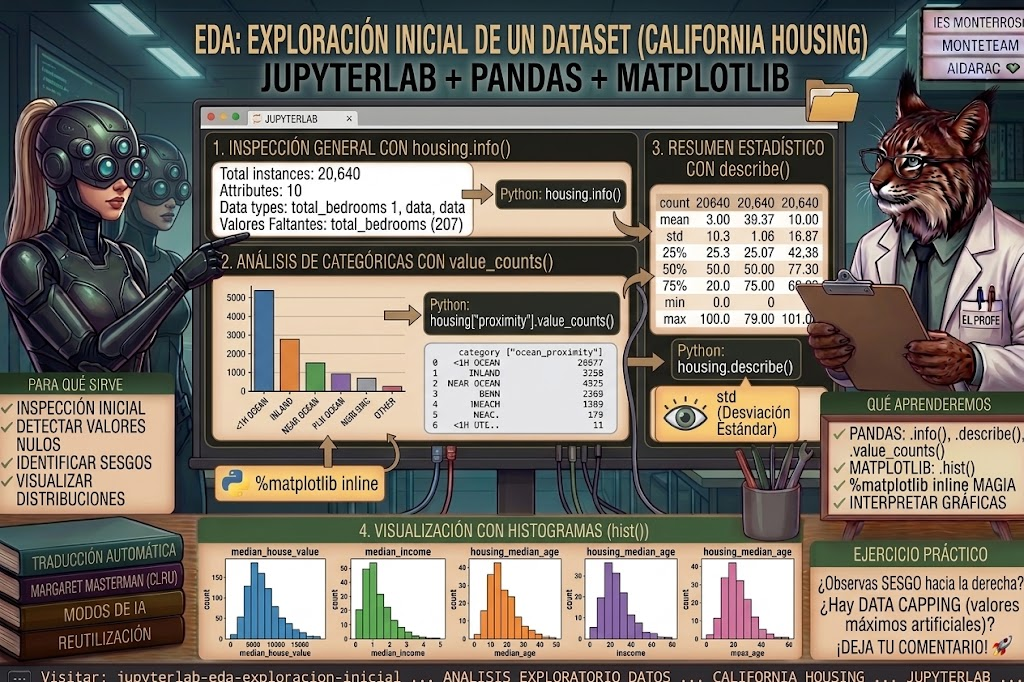
Este tutorial guía paso a paso al alumnado en la realización de un Análisis Exploratorio de Datos (EDA) inicial utilizando Python, Pandas y JupyterLab sobre el conjunto de datos California Housing. A través de métodos fundamentales como info(), value_counts(), describe() e hist(), los estudiantes aprenderán a identificar la estructura del dataset, detectar valores nulos, analizar variables categóricas, interpretar estadísticas descriptivas (como cuartiles y desviación estándar) y visualizar la distribución de los datos mediante histogramas con Matplotlib. Incluye un reto práctico final para afianzar los conceptos aprendidos.